
#강화학습
17개의 포스트
[특집] 점수 대신 첨삭으로 배운다 — GEPA, 프롬프트가 스스로 진화해 강화학습을 이긴 방법
강화학습은 시도 한 번에 점수 하나를 받는다. 그런데 AI가 일한 흔적은 전부 글이다 — 생각의 과정, 도구 호출, 컴파일러 오류 메시지까지. 그렇다면 점수 대신 그 글을 읽고 배우게 하면 어떨까? UC 버클리·스탠퍼드·MIT 등 17명이 쓴 GEPA(ICLR 2026 구두 발표)는 이 질문에 답한다. 실패한 기록을 언어 모델이 직접 읽고 반성해 프롬프트를 고치고, 고친 프롬프트들을 '문항별 1등'이라는 파레토 기준으로 살려 두며 진화시킨다. 그 결과 여섯 과제에서 가중치를 고치는 강화학습(GRPO, 24,000 롤아웃)보다 평균 6점, 최대 20점 높았고, 롤아웃은 최대 35배 적게 썼다. 이 글은 '생각해 보자, 차근차근'이라는 주문에서 시작한 프롬프트 최적화의 역사, 반성·진화·파레토라는 세 기둥, 논문의 표와 그림, 수학 문제에서는 강화학습에 진 이유, 그리고 에이전트가 경험을 글로 쌓아 가는 2026년에 이 아이디어가 맡는 역할을 인터랙티브 6개와 일러스트 13장으로 풀어 본다.
GLM-Legal 완전 해부 — 가벼운 모델이 법률 에이전트 시험에서 프런티어를 이긴 방법: 중간학습, 하네스 공진화, 그리고 19.2%의 의미
2026년 10월 12일, 중국 Z.ai가 법률 특화 모델 GLM-Legal을 공개했습니다. 활성 파라미터 18B짜리 가벼운 모델(GLM-5.3-Flash) 위에 법률 중간학습과 수만 개의 법률 과제 환경 강화학습을 얹었더니, 로펌 실무 과제를 끝까지 해내야 하는 Harvey LAB에서 전 항목 통과율 19.2%로 Claude Fable 5(11.3%)와 GPT-6 Astra(5.4%)를 앞섰습니다. 과제당 비용은 0.15달러로 Fable 5의 약 130분의 1입니다. 그런데 19.2%는 열 건 중 여덟 건을 '불합격'했다는 뜻이기도 합니다. 1970년대 규칙 기반 법률 AI부터 가짜 판례 사건, LegalBench에서 Harvey LAB으로 바뀐 시험지, 중간학습과 하네스 공진화라는 아키텍처, 시연 세 장면, 순위표에서 빠진 모델과 퇴보한 지표까지, 이 발표를 둘러싼 모든 것을 쉽게 풀어 씁니다. 인터랙티브 6개, 논문·벤치마크 그림 11장, 삽화 10장.
[특집] 수학의 미래 — 타오의 블로그에 실린 아비가드의 편지: '더 어려운 문제를 풀고, 더 큰 생각을 하고, 새로운 것을 시도하라'
2026년 10월 5일, 테런스 타오의 블로그에 카네기멜런 대학의 논리학자이자 Lean 수학 라이브러리의 산파인 제러미 아비가드의 글 「수학의 미래」가 실렸다. 한 달 내내 경고와 선언이 쏟아지던 블로그에 처음으로 '대체로 긍정적'이라는 진단과 함께 세 개의 동사가 나왔다 — 더 어려운 문제를 풀어라, 더 큰 생각을 하라, 새로운 것을 시도하라. 그리고 다음 세대에게 '우리는 당신들과 함께 선다'는 문장이 붙었다. 이 글은 왜 화제가 됐는가. 리만의 1854년 강연을 '어떤 강화학습 채점기도 평가할 수 없었을 것'이라고 한 기술적 주장은 무슨 뜻인가. 추론 모델이 실제로 어떻게 훈련되는지(GRPO·결과 보상·AlphaProof의 탐색 트리)부터, 수학이 '낯선 기술'을 삼켜 온 400년의 역사, 댓글창의 반론, 같은 주에 바뀐 arXiv·Erdős 사이트의 규칙, 그리고 2026년 한국의 자리까지, 원문과 논문·댓글 100여 건을 읽고 인터랙티브 다섯 개와 함께 풀어본다.
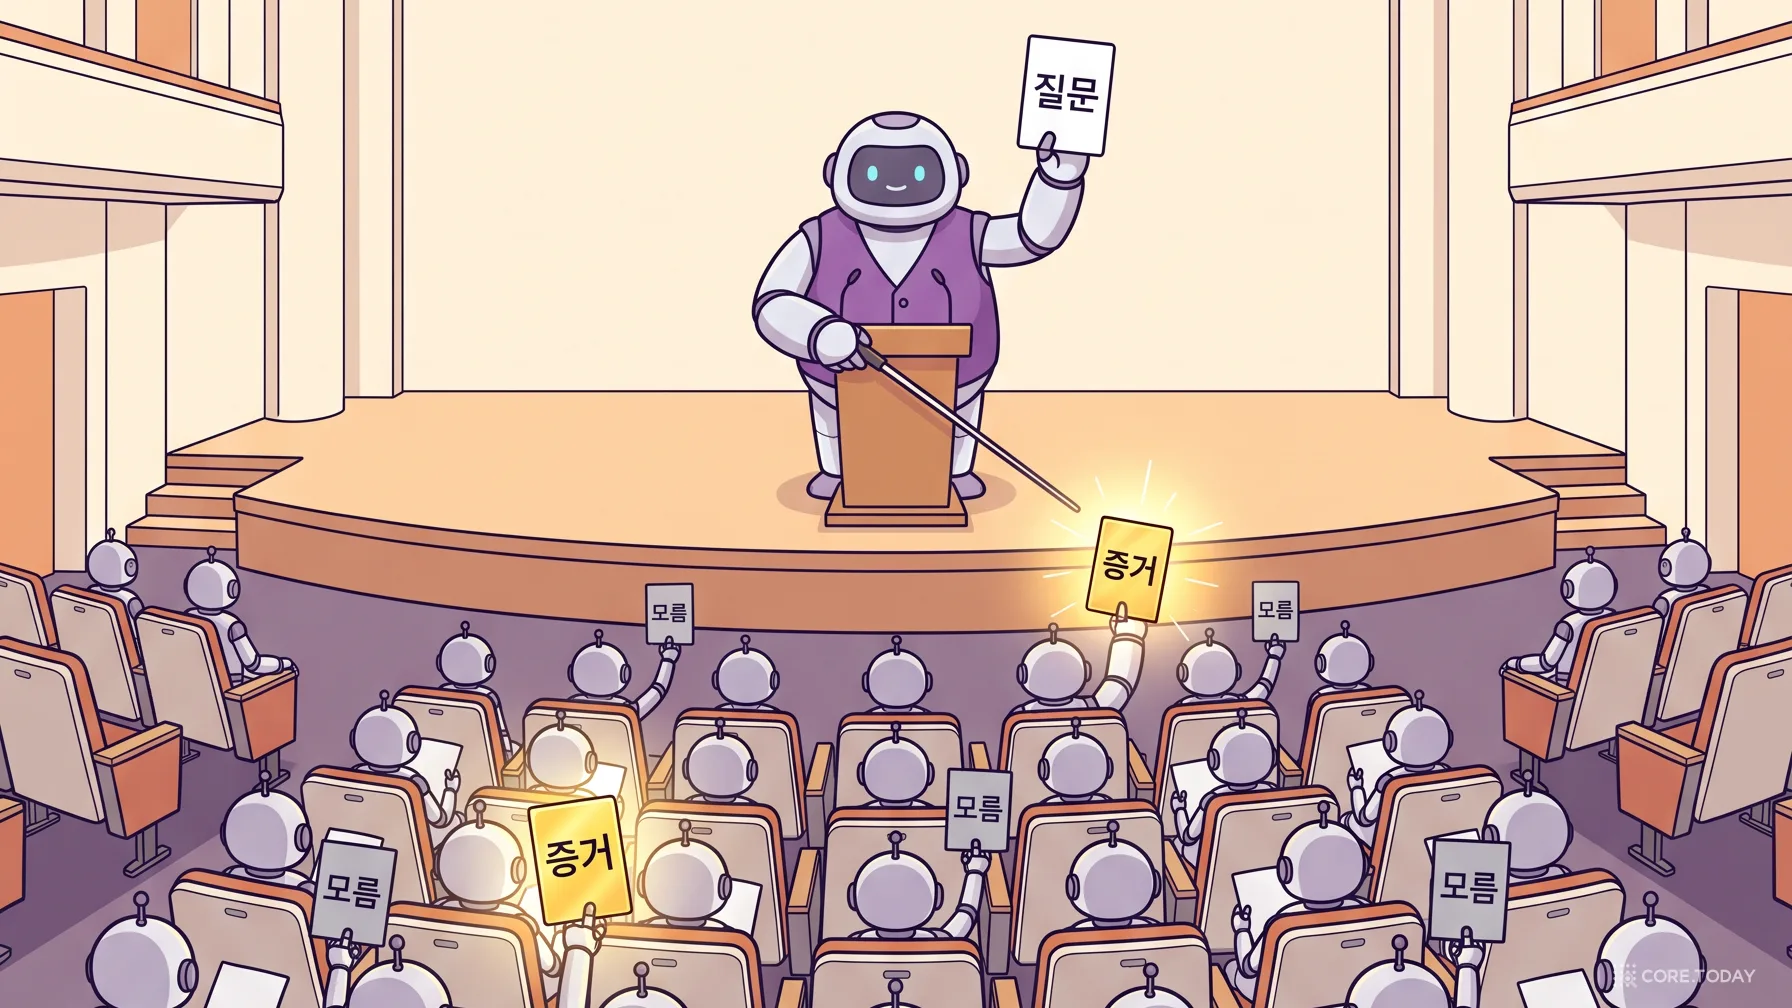
읽기는 병렬로, 추론은 깊게 — 896K 토큰 문서를 4B 모델이 읽어 내는 법, PARSER 논문 특집
100만 토큰짜리 창을 가진 모델도 긴 문서 앞에서는 정확도가 수십 점씩 떨어집니다. 홍콩중문대 연구진이 2026년 9월에 내놓은 PARSER는 '문서를 읽는 순서는 문서가 정하지만, 질문을 푸는 순서는 질문이 정해야 한다'는 한 문장에서 출발합니다. 문서를 보지 않는 리드 에이전트가 질문을 쪼개 수천 개의 청크 담당 서브에이전트에게 동시에 흩뿌리고, 돌아온 증거로 다음 질문을 다듬습니다. 4B 모델이 896K 토큰에서 순차 메모리 에이전트를 12점 앞서고, 9B 모델이 DeepSeek-V4-Pro를 6.3점 앞섰으며, 지연은 11배 줄었습니다. 이 글은 Transformer의 어텐션 창에서 시작해 'Lost in the Middle'과 Context Rot, MemAgent의 순차 메모리까지 이 논문이 서 있는 자리를 되짚고, 흩뿌리기-모으기 구조와 리드 에이전트만 강화학습하는 설계, 세 가지 통제 실험, 실패 사례와 한계, 그리고 2026년 멀티 에이전트 지형에서의 의미를 사례와 함께 풀어 씁니다. 시뮬레이터·결과 탐색기·접근법 가이드 위젯 3개.
생각은 어디에 흐르는가 — Recurrent Looped Transformer와 보이지 않는 추론의 시대
2026년 9월 12일, 프린스턴의 Yifan Zhang이 16쪽짜리 기술 보고서를 공개했다. 이전 토큰의 내부 상태를 다음 토큰으로 계속 넘겨서, 문장이 길어질수록 계산 경로도 계속 깊어지는 트랜스포머다. 열흘 전에는 OpenAI의 GPT-6 Astra가 비슷한 '순환' 기법을 쓴다는 보도로 AI 안전 연구자들이 들끓었다. 이 특집은 RNN에서 트랜스포머, 생각의 사슬, 루프 모델로 이어진 35년의 흐름 속에서 RLT가 왜 나왔는지 풀고, 논문의 세 가지 설계 원칙을 하나씩 분해하고, 독립 실험이 보여 준 한계를 확인한 뒤, 모델의 생각이 글에서 벡터로 옮겨 갈 때 사람의 감시가 어떻게 되는지를 따진다. 인터랙티브 실험 4종과 논문 원본 그림을 함께 싣는다.
당신의 AI, 빌린 겁니까 가진 겁니까 (1부): '인텔리전스 오너십'이라는 새 승부수
2026년 7월, Fermisense가 올린 한 편의 글이 AI 업계를 흔들었다. 90억 파라미터짜리 작은 오픈소스 모델을 강화학습으로 훈련시켰더니, 세계 최고 프런티어 모델을 전부 이기고도 비용은 최대 340배 싸더라는 것이다. 이 특집 1부는 '인텔리전스를 소유한다'는 개념이 왜 지금 등장했는지를 ChatGPT 이후의 역사와 2026년의 AI 경제학으로 추적한다.
당신의 AI, 빌린 겁니까 가진 겁니까 (2부): SFT에서 GRPO까지, '디지털 트윈'이라는 훈련장
'강화학습으로 모델을 훈련한다'는 말은 정확히 무슨 뜻일까? 사전학습·SFT·RLHF·RLVR로 이어지는 개념의 사다리를 밟아 오르고, 요즘 화제인 GRPO를 '커브로 채점하는 시험'에 빗대 직관적으로 푼다. 그리고 모델이 실제로 업무를 연습하는 '디지털 트윈'과 보상 설계까지, Fermisense의 카탈로그 실험을 해부한다.
당신의 AI, 빌린 겁니까 가진 겁니까 (3부): 90억 모델이 프런티어를 이긴 날, 그리고 판별법
이론은 충분하다. 이제 숫자다. Fermisense의 90억 파라미터 모델은 e커머스 카탈로그 검수에서 프런티어 5종을 어떻게 이겼고, 비용은 왜 최대 340배 저렴했나. 브리지워터부터 링크드인·체커까지 11개 회사의 성적표를 펼치고, 마지막엔 '우리 회사의 어떤 업무가 이 방식의 후보인가'를 직접 판별하는 체크리스트로 특집을 닫는다.
인간은 루프 안에서 지쳤다 — 'Human-in-the-Loop'의 70년史와, AI가 코딩의 보상을 훔쳐간 2026년
Pydantic의 엔지니어가 쓴 한 편의 고백 「The Human-in-the-Loop is Tired」가 개발자 세계를 뒤흔들었다. '코드가 알아서 써지는' 시대에 왜 우리는 더 생산적이면서 동시에 더 불행해졌을까? 이 글은 그 답을 찾기 위해 1948년 사이버네틱스의 '키잡이'에서 출발해, 군사 자율무기의 in/on/out-of-the-loop 논쟁, 강화학습의 보상함수, 스키너 상자, 그리고 2026년 버클리·하버드의 노동강도 연구까지 훑는다. '망가진 것은 당신이 아니라 피드백 루프'라는 명제를, 인터랙티브 시뮬레이터 2종과 함께 해부한다.
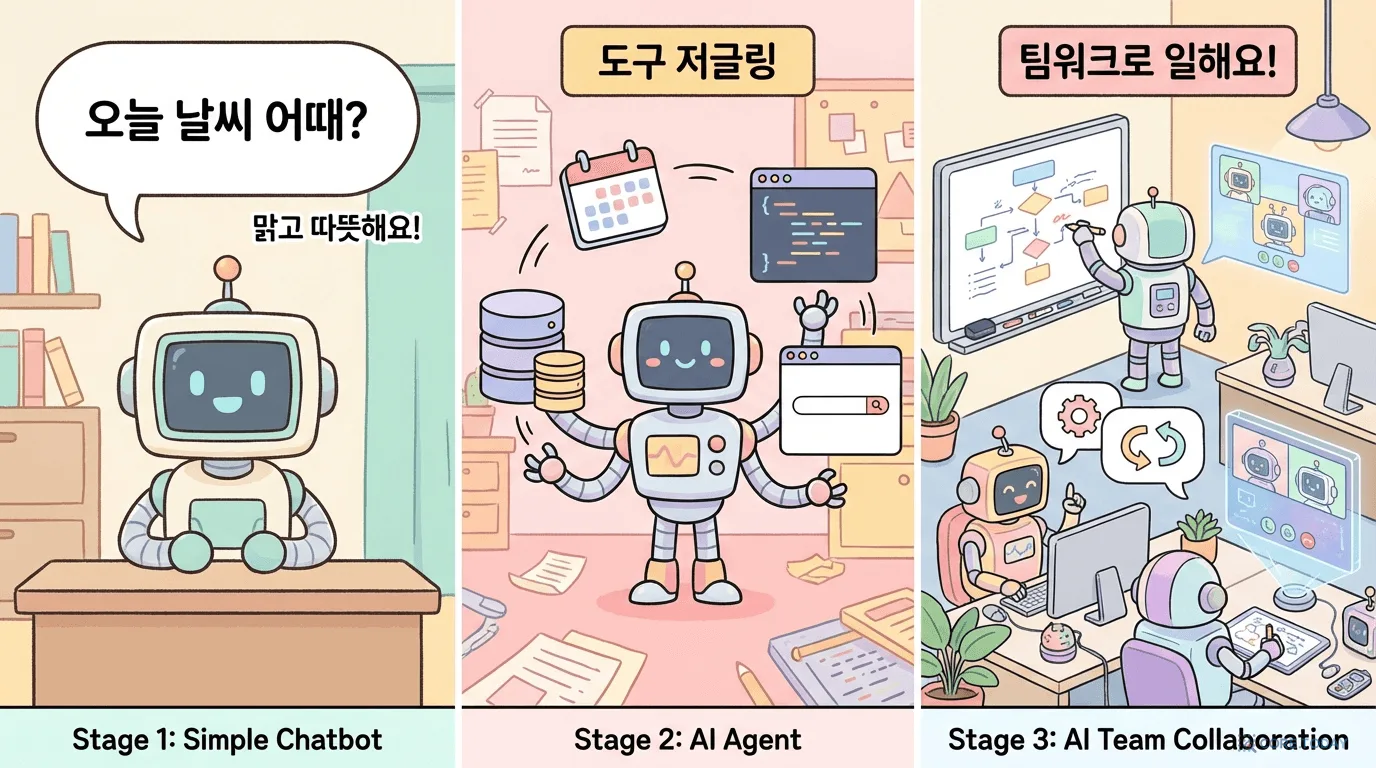
Agent Lightning 완전 가이드 — AI 에이전트를 강화학습으로 훈련시키는 시대가 왔다
Microsoft가 공개한 Agent Lightning은 어떤 AI 에이전트 프레임워크든 강화학습으로 훈련시킬 수 있는 오픈소스 프레임워크다. 왜 에이전트 훈련이 필요한지, 어떤 원리로 작동하는지, 아키텍처의 모든 것을 풍부한 사례와 함께 해부한다.
OpenClaw-RL 완전 해부: AI 에이전트가 '대화하면서 스스로 똑똑해지는' 시대가 열리다
매일 쓰는 AI 에이전트가 사용자의 반응, 터미널 출력, GUI 변화까지 '다음 상태 신호'로 읽어 스스로 진화한다면? OpenClaw-RL 논문이 제시하는 '대화만으로 학습하는 에이전트'의 원리를 역사적 맥락부터 핵심 기술까지 쉽고 깊게 풀어본다.
Vision-R1 특집: AI에게 '눈으로 보고 생각하는 법'을 가르치다 — 과잉사고의 함정부터 점진적 훈련까지
DeepSeek-R1이 텍스트에서 '생각하는 법'을 배웠다면, Vision-R1은 이미지를 보면서 생각하는 법을 배웠다. 하지만 그 과정에서 AI가 '쓸데없이 오래 생각하는' 과잉사고 문제에 빠졌다. ICLR 2026에서 발표된 이 논문이 제시한 점진적 사고 억제 훈련의 원리를, 일러스트와 인터랙티브 요소로 쉽고 깊게 풀어본다.