특집ZDR제로 데이터 보존Zero Data Retention데이터 보존개인정보프라이버시GDPR개인정보보호법Privacy by Design데이터 최소화OpenAIAnthropicAWS BedrockAzure OpenAIVertex AISignalApple Private Cloud Compute기밀 컴퓨팅TEE머신 언러닝학습 데이터 추출NYT 대 OpenAI남용 모니터링기업 AI 도입인사이트
[특집] 남기지 않는 기술 — 제로 데이터 보존(ZDR)은 어떻게 AI 시대 가장 뜨거운 계약 조건이 되었나
2026년 가을, 세계에서 가장 똑똑한 AI 모델을 두고 엔비디아는 '민감한 업무에는 쓰지 말라'고 했고, 팔란티어는 '배포하지 않겠다'고 했습니다. 모델이 나빠서가 아닙니다. 공급자가 프롬프트를 30일 동안 보관하기 때문입니다. 이 글은 '제로 데이터 보존(ZDR)'이라는 한 줄짜리 계약 조건이 어디서 왔는지를 20년 전으로 거슬러 올라가 따라갑니다. '모두 남겨라'고 명령했다가 8년 만에 뒤집힌 유럽의 법, 익명 검색 기록에서 사흘 만에 할머니의 이름이 나온 사건, 소환장을 받고 종이 한 장을 내민 메신저, 시만 반복하라고 했더니 학습 데이터를 토해 낸 챗봇, 그리고 '삭제한 대화도 보존하라'는 법원 명령까지. 그 끝에서 ZDR이 정확히 무엇을 약속하고 무엇을 약속하지 않는지, 2026년 공급자들이 내놓은 새 방식(고객 저장소·고객 키)은 무엇이 다른지, 한국 기업이 계약서에서 무엇을 물어야 하는지 정리합니다.
2026년 10월 초, 포춘은 기업 AI 시장에서 벌어지고 있는 이상한 장면을 보도했습니다. 세계에서 가장 성능이 좋은 모델 가운데 하나인 Anthropic의 Claude Fable을 두고, 엔비디아는 사내 사용을 오픈소스 작업 같은 저위험 업무로 제한하고 공급망처럼 민감한 일에는 자사 모델을 쓰기로 했습니다. 팔란티어는 "철회할 수 없는 ZDR 보장"이 있기 전까지 자사 플랫폼으로 이 모델을 유통하지 않겠다고 했고, 부즈 앨런은 사이버보안 소프트웨어 업무에 이 모델을 쓰지 못하게 했습니다. 포춘은 기업들의 반응을 "거의 알레르기에 가깝다"고 표현했습니다.
모델이 나빠서가 아닙니다. 지난 6월 Anthropic이 가장 강한 모델군(Mythos 5·5.1, Fable 5·5.1)에 대해 프롬프트와 출력을 30일 동안 보관하겠다고 정책을 바꿨기 때문입니다. 안전 모니터링을 위해서라는 설명이 붙었고, 이미 '보존 0일' 계약을 맺은 조직도 이 모델을 쓰려면 보존을 켜야 했습니다. 그 한 줄이 조달 담당자들을 움직였습니다.
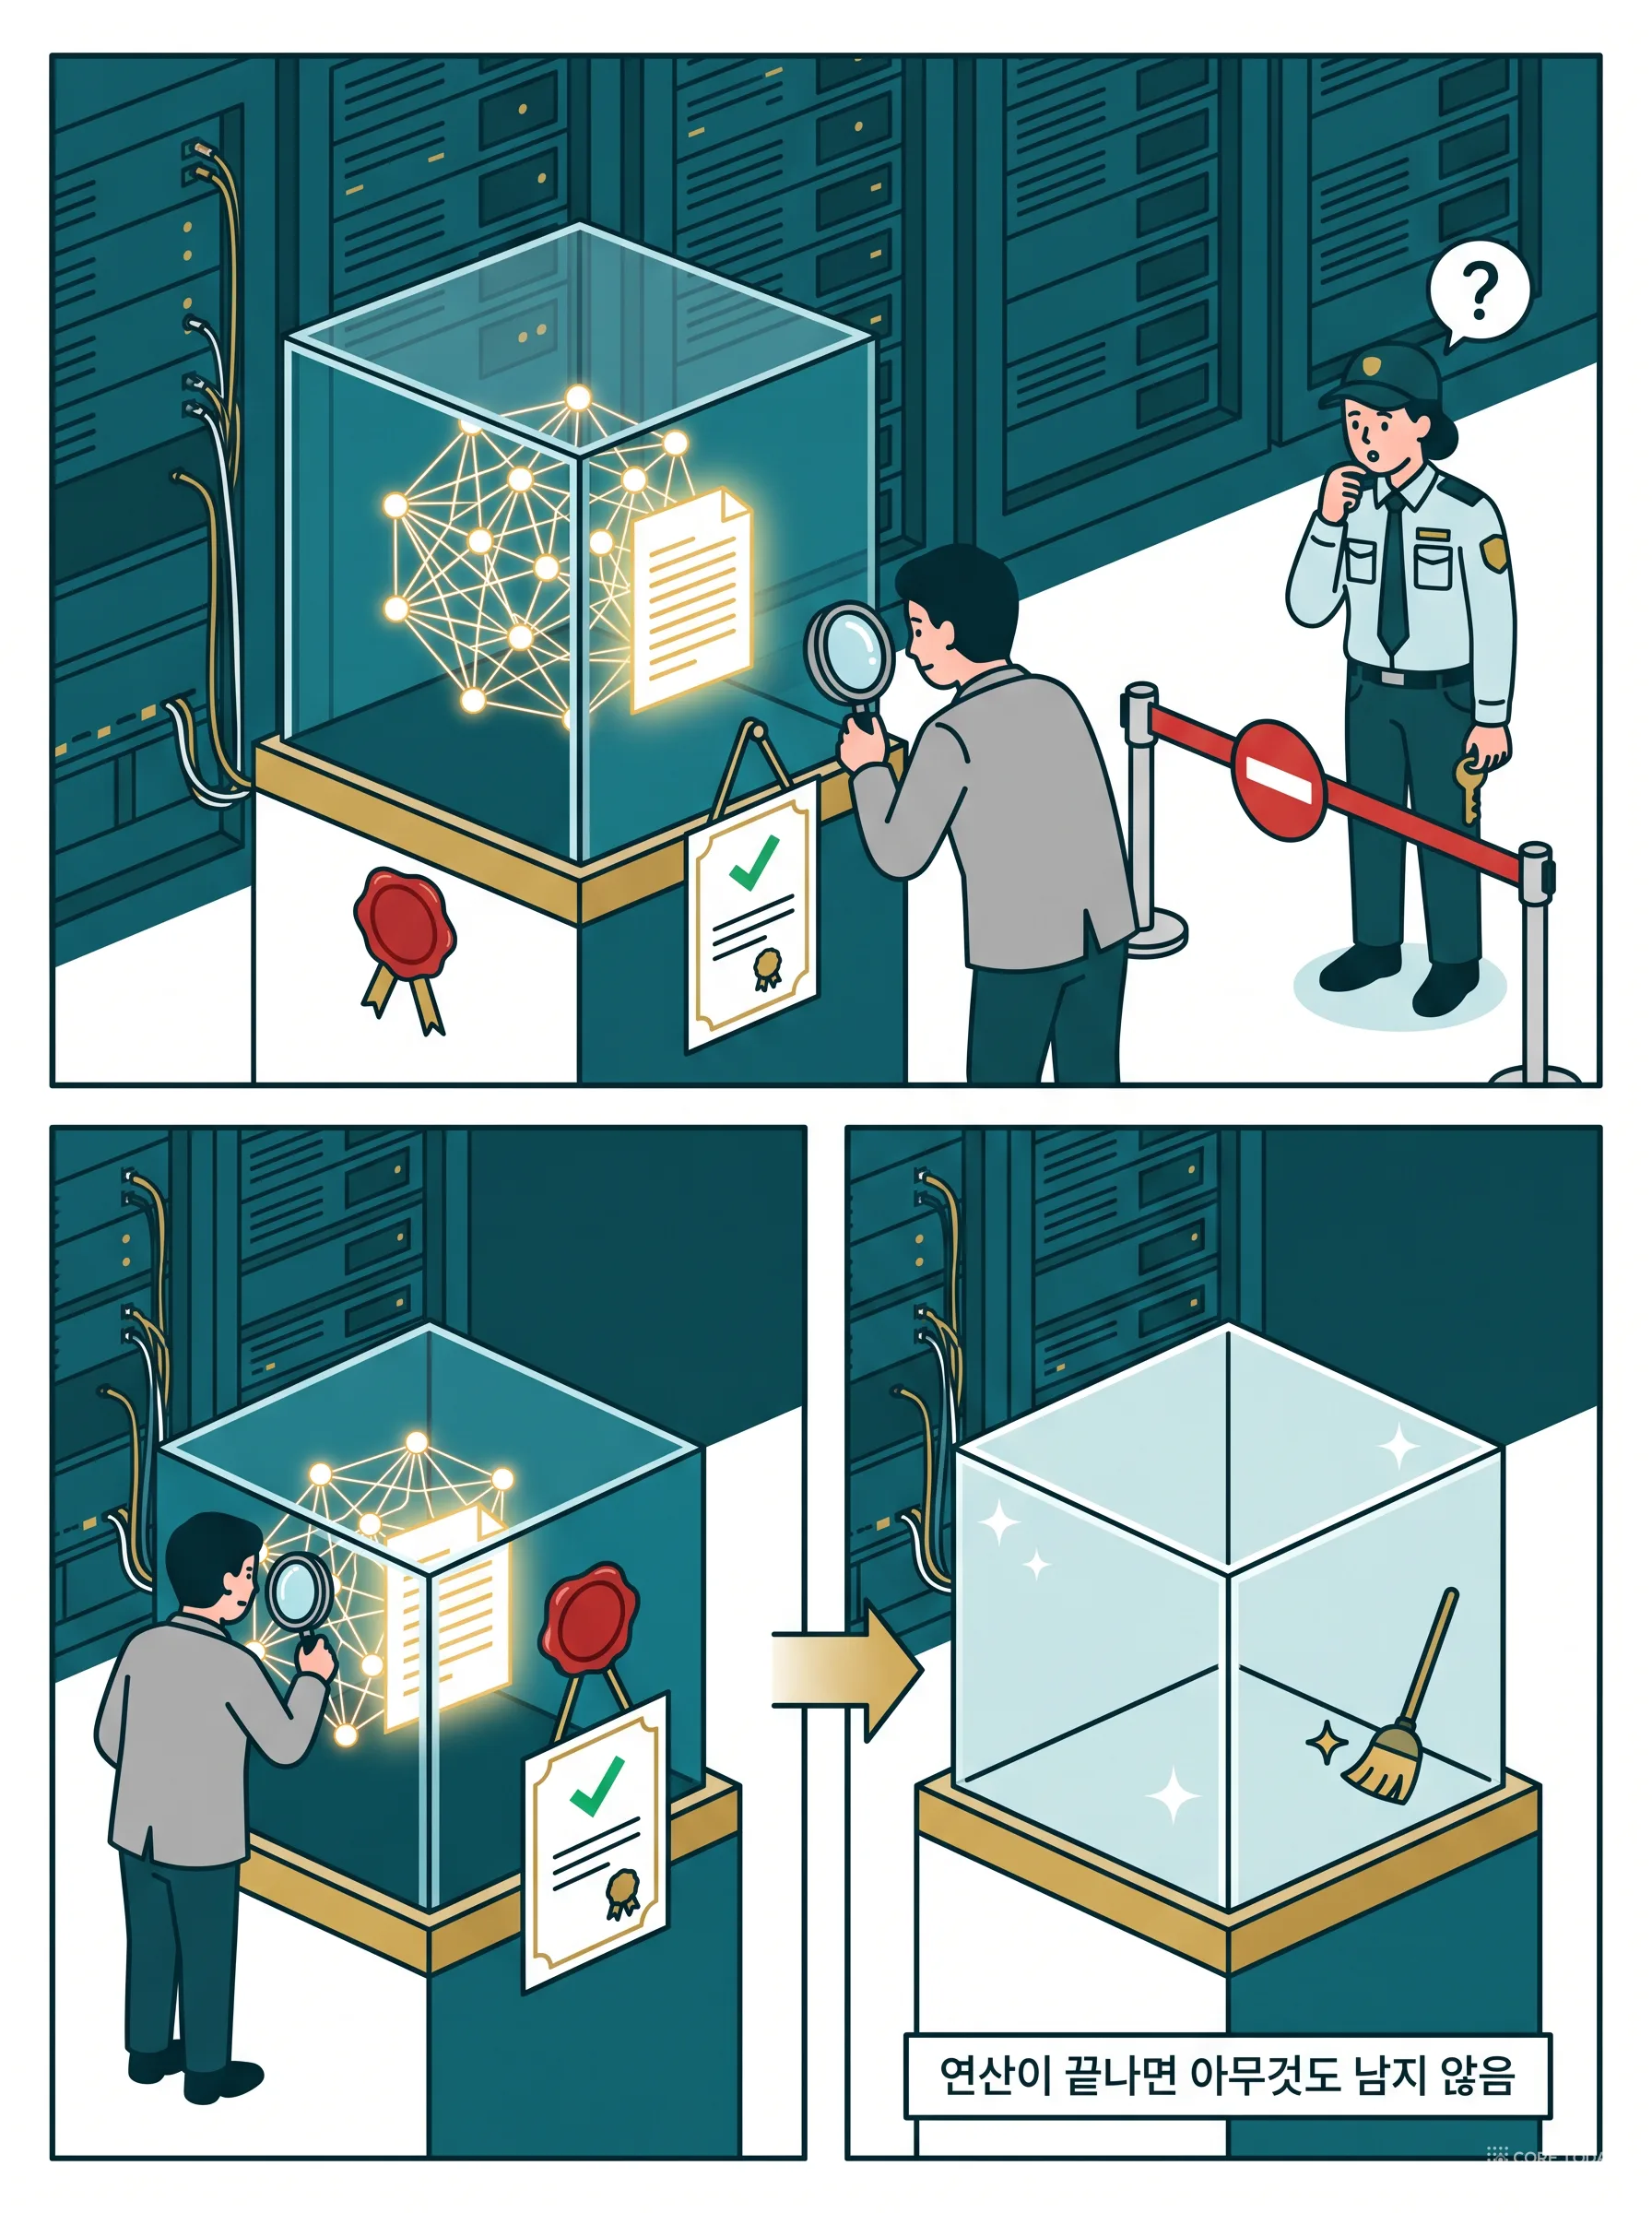
이 글의 주인공은 그 한 줄, 제로 데이터 보존(Zero Data Retention, ZDR)입니다. 뜻은 간단합니다. "당신이 보낸 요청과 우리가 만든 응답을, 처리가 끝나면 우리 쪽에 남기지 않겠다." 그런데 이 단순한 약속이 왜 2026년에 수십억 달러짜리 계약을 좌우하게 되었을까요. 답을 찾으려면 20년 전, 정반대의 법이 만들어지던 때로 돌아가야 합니다.
✅
요약.
· 데이터 보존은 한때 국가가 강요한 의무였습니다(2006년 EU 데이터 보존 지침). 8년 뒤 사법재판소가 "무차별 보존은 기본권 침해"라며 통째로 무효화했습니다.
· AOL·넷플릭스·애슐리 매디슨·에퀴팩스는 같은 교훈을 반복했습니다. 남긴 데이터는 자산이 아니라 부채이고, 익명화는 약하며, 삭제는 생각보다 어렵습니다.
· Signal·Mullvad·애플 PCC는 반대 방향을 증명했습니다. 없는 데이터는 소환장도, 압수수색도, 해커도 가져갈 수 없습니다.
· AI는 이 문제를 키웁니다. 프롬프트는 가장 솔직한 데이터이고, 모델은 학습 데이터를 암기하며, 한 번 가중치에 들어간 것은 로그를 지워도 안 지워집니다.
· ZDR은 '학습에 안 쓴다'와 다릅니다. 학습 사용 · 보존 · 열람은 세 개의 다른 축이고, ZDR은 두 번째 축을 0으로 만드는 약속입니다. 처리 중 메모리, 캐시, 우리 쪽 로그까지 지워 주지는 않습니다.
· 2026년의 새 흐름은 "보존하되 공급자가 못 본다"입니다. OpenAI의 Private Safety Processing과 Anthropic의 Enterprise Frontier Safeguards는 모두 모니터링용 데이터를 고객의 저장소·고객의 키로 옮깁니다.
1. '남겨라'가 법이었던 시절
서버는 원래 기억한다
컴퓨터 시스템은 기본적으로 기록을 남기도록 만들어져 있습니다. 장애가 나면 로그를 봐야 하고, 요금을 매기려면 사용량을 세야 하고, 공격을 받으면 흔적을 추적해야 합니다. 엔지니어에게 로그는 공기 같은 것이어서, "남기지 않는다"는 쪽이 오히려 의식적인 결정이 필요한 예외입니다.
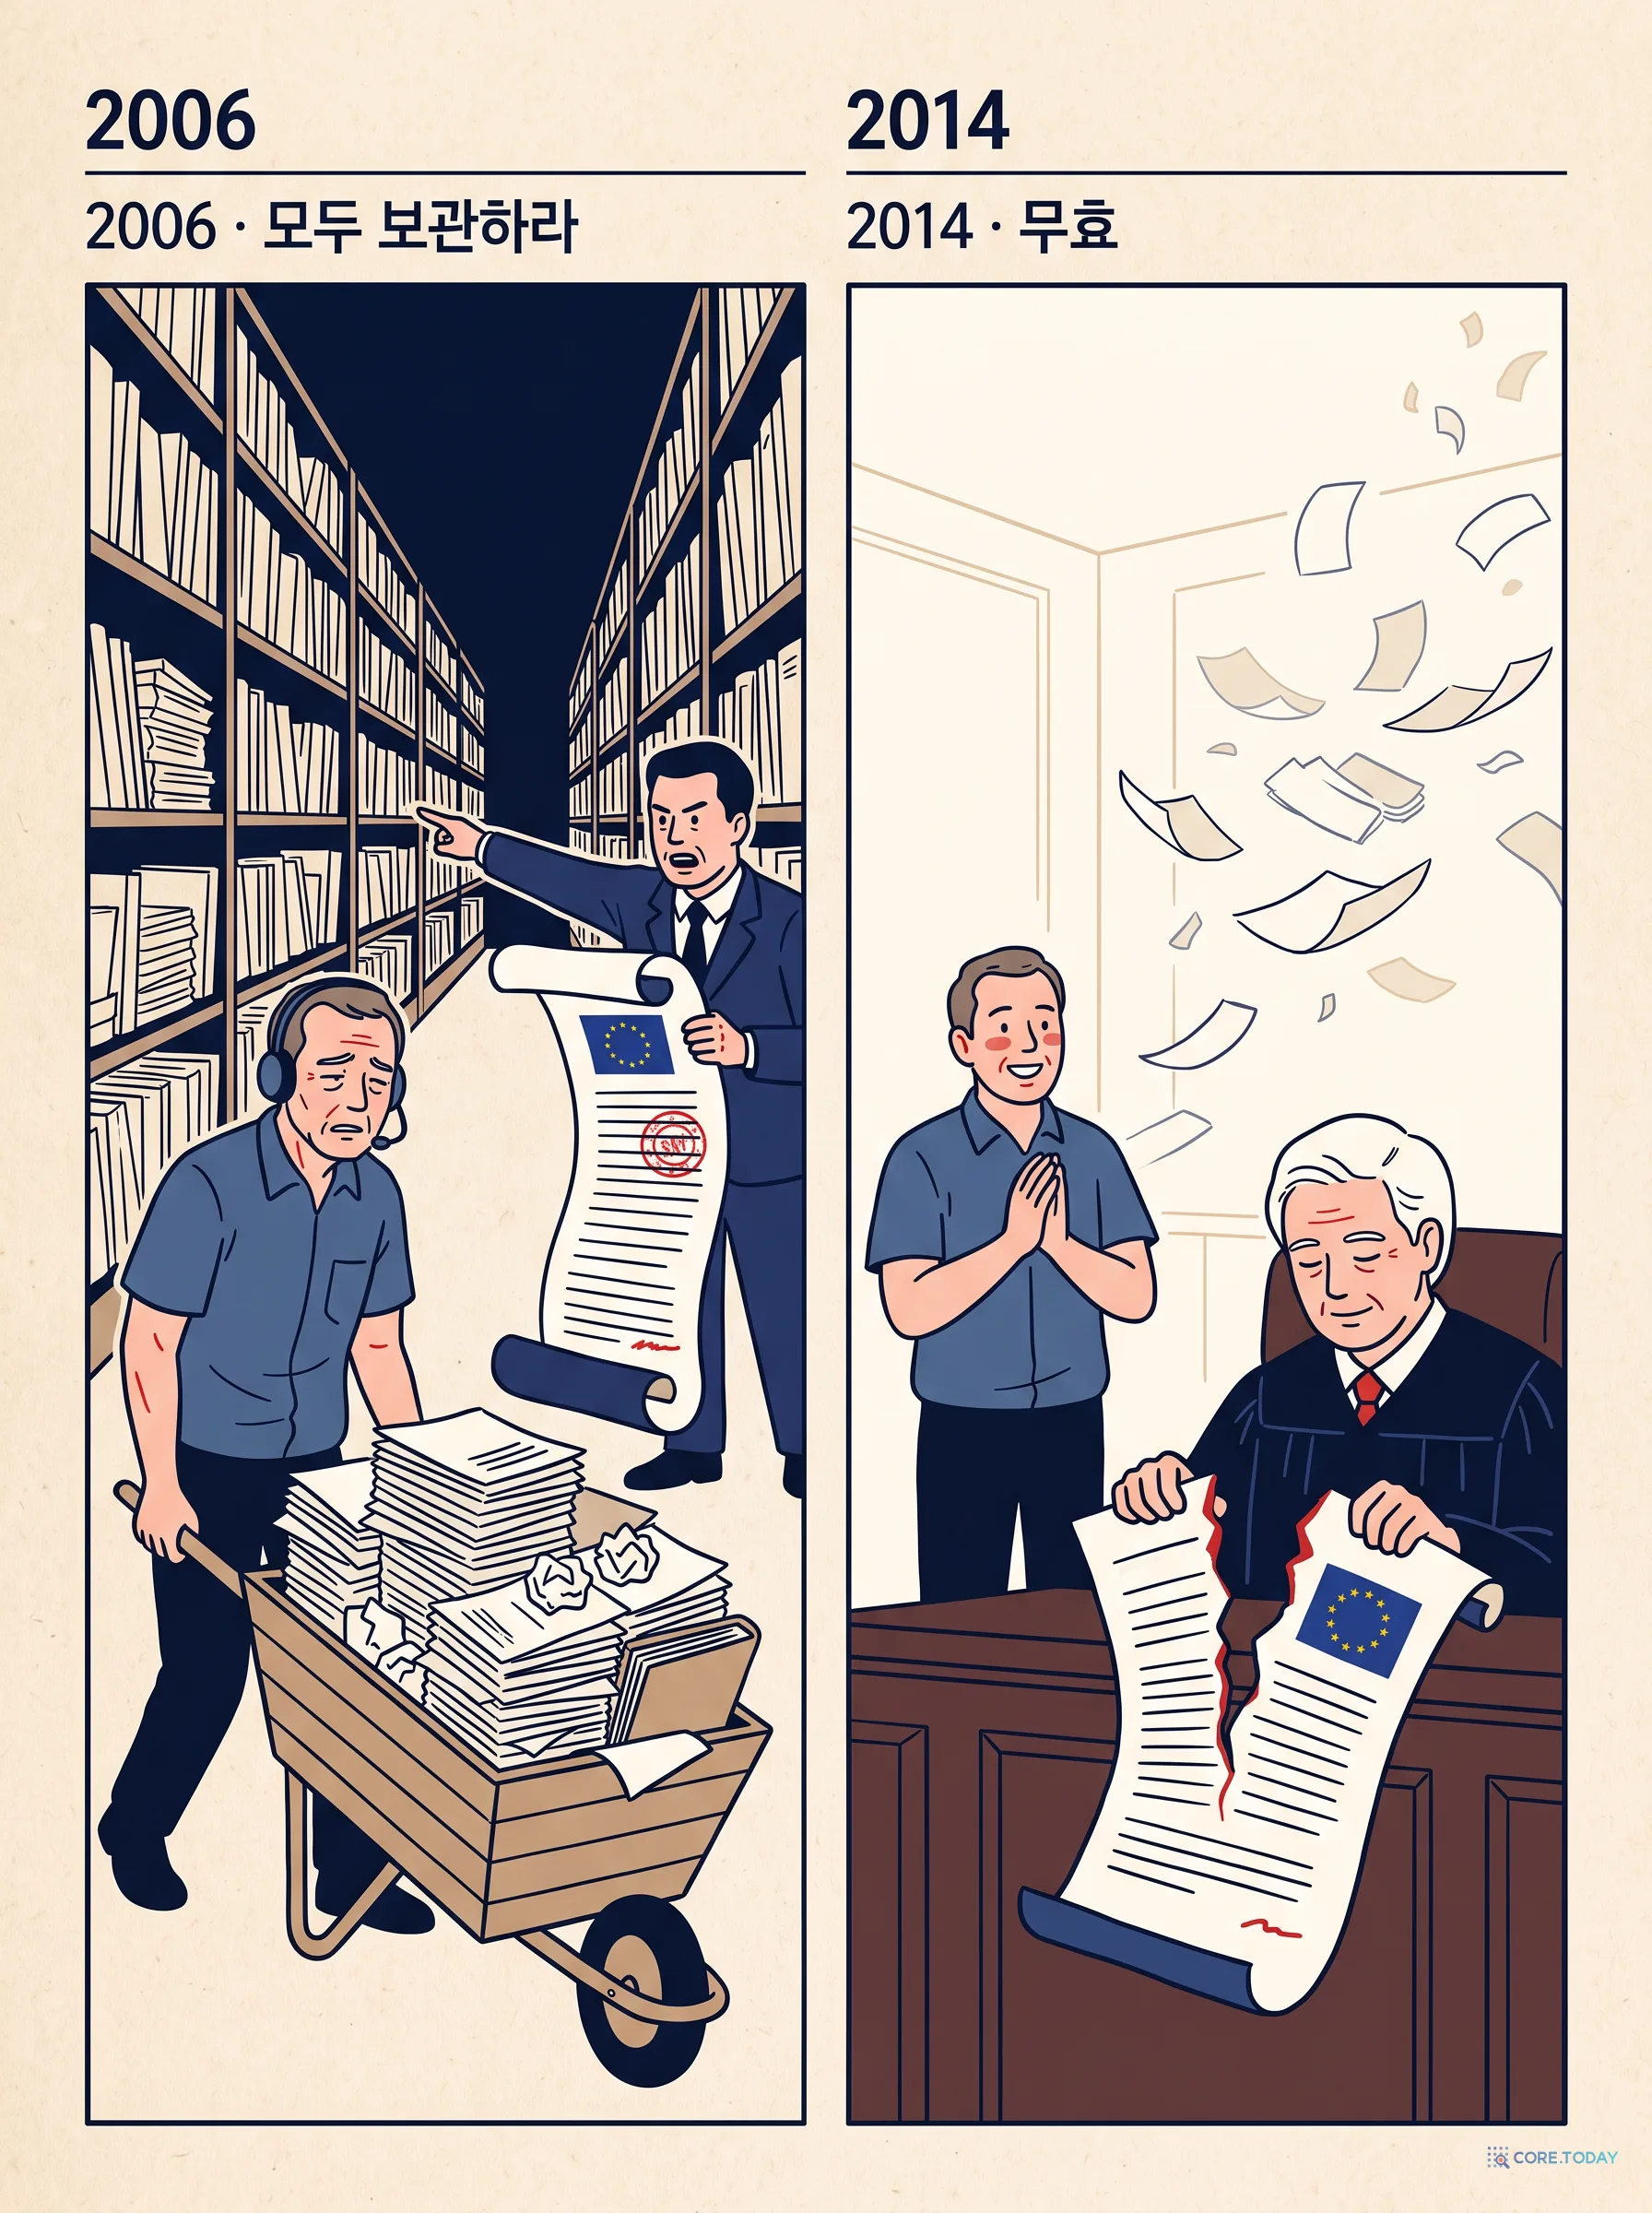
그래서 디지털 시대 초기에는 '보존'이 선(善)에 가까웠습니다. 2004년 마드리드와 2005년 런던의 폭탄 테러 뒤, 유럽연합은 2006년 3월 데이터 보존 지침(2006/24/EC)을 채택했습니다. 통신사와 인터넷 사업자에게 누가 누구와 언제 통화했는지, 어디서 접속했는지 같은 메타데이터를 최소 6개월에서 최대 2년 동안 의무적으로 보관하라는 법이었습니다. 수사기관이 필요할 때 꺼내 볼 수 있어야 한다는 논리였습니다. 미국에서는 애국법 215조를 근거로 국가안보국(NSA)이 통신사의 통화 기록을 대량으로 수집하고 있었다는 사실이 2013년 6월 스노든 문서로 드러났습니다.
이 법은 오래가지 못했습니다. 2014년 4월 8일, 유럽연합 사법재판소는 Digital Rights Ireland 판결에서 데이터 보존 지침을 통째로 무효라고 선언했습니다. 혐의가 있든 없든 모든 사람의 통신 기록을 무차별적으로 보존하는 것은 사생활과 개인정보 보호라는 기본권을 지나치게 침해한다는 이유였습니다. 2016년 12월 Tele2/Watson 판결은 한 걸음 더 나가, 회원국이 자국법으로 만든 "일반적이고 무차별적인" 보존 의무도 EU법 위반이라고 못 박았습니다. 미국에서도 2015년 6월 USA FREEDOM Act가 정부의 대량 메타데이터 보유를 끝내고, 데이터는 통신사가 갖되 정부는 영장으로 질의하는 구조로 바꿨습니다.
같은 2014년 5월, 사법재판소는 Google Spain 판결로 '잊힐 권리'를 인정했습니다. 10년도 안 되는 사이에 유럽의 법은 "모두 남겨라"에서 "지워 달라고 할 권리가 있다"로 방향을 틀었습니다.
여기서 첫 번째 핵심 개념이 나옵니다. 보존은 공짜가 아닙니다. 보존된 데이터는 보존된 순간부터 누군가가 요구할 수 있는 대상이 됩니다. 수사기관이, 법원이, 해커가, 혹은 내부자가. 보존 의무를 만든 쪽도 그 사실을 알고 있었습니다. 그래서 만든 것이었으니까요.
2. 남긴 데이터는 자산이 아니라 부채
법이 방향을 틀기 전에, 현실이 먼저 가르쳤습니다. 2006년부터 2017년까지 이어진 사건들은 하나같이 같은 교훈을 반복합니다.
사용자 4417749번의 이름
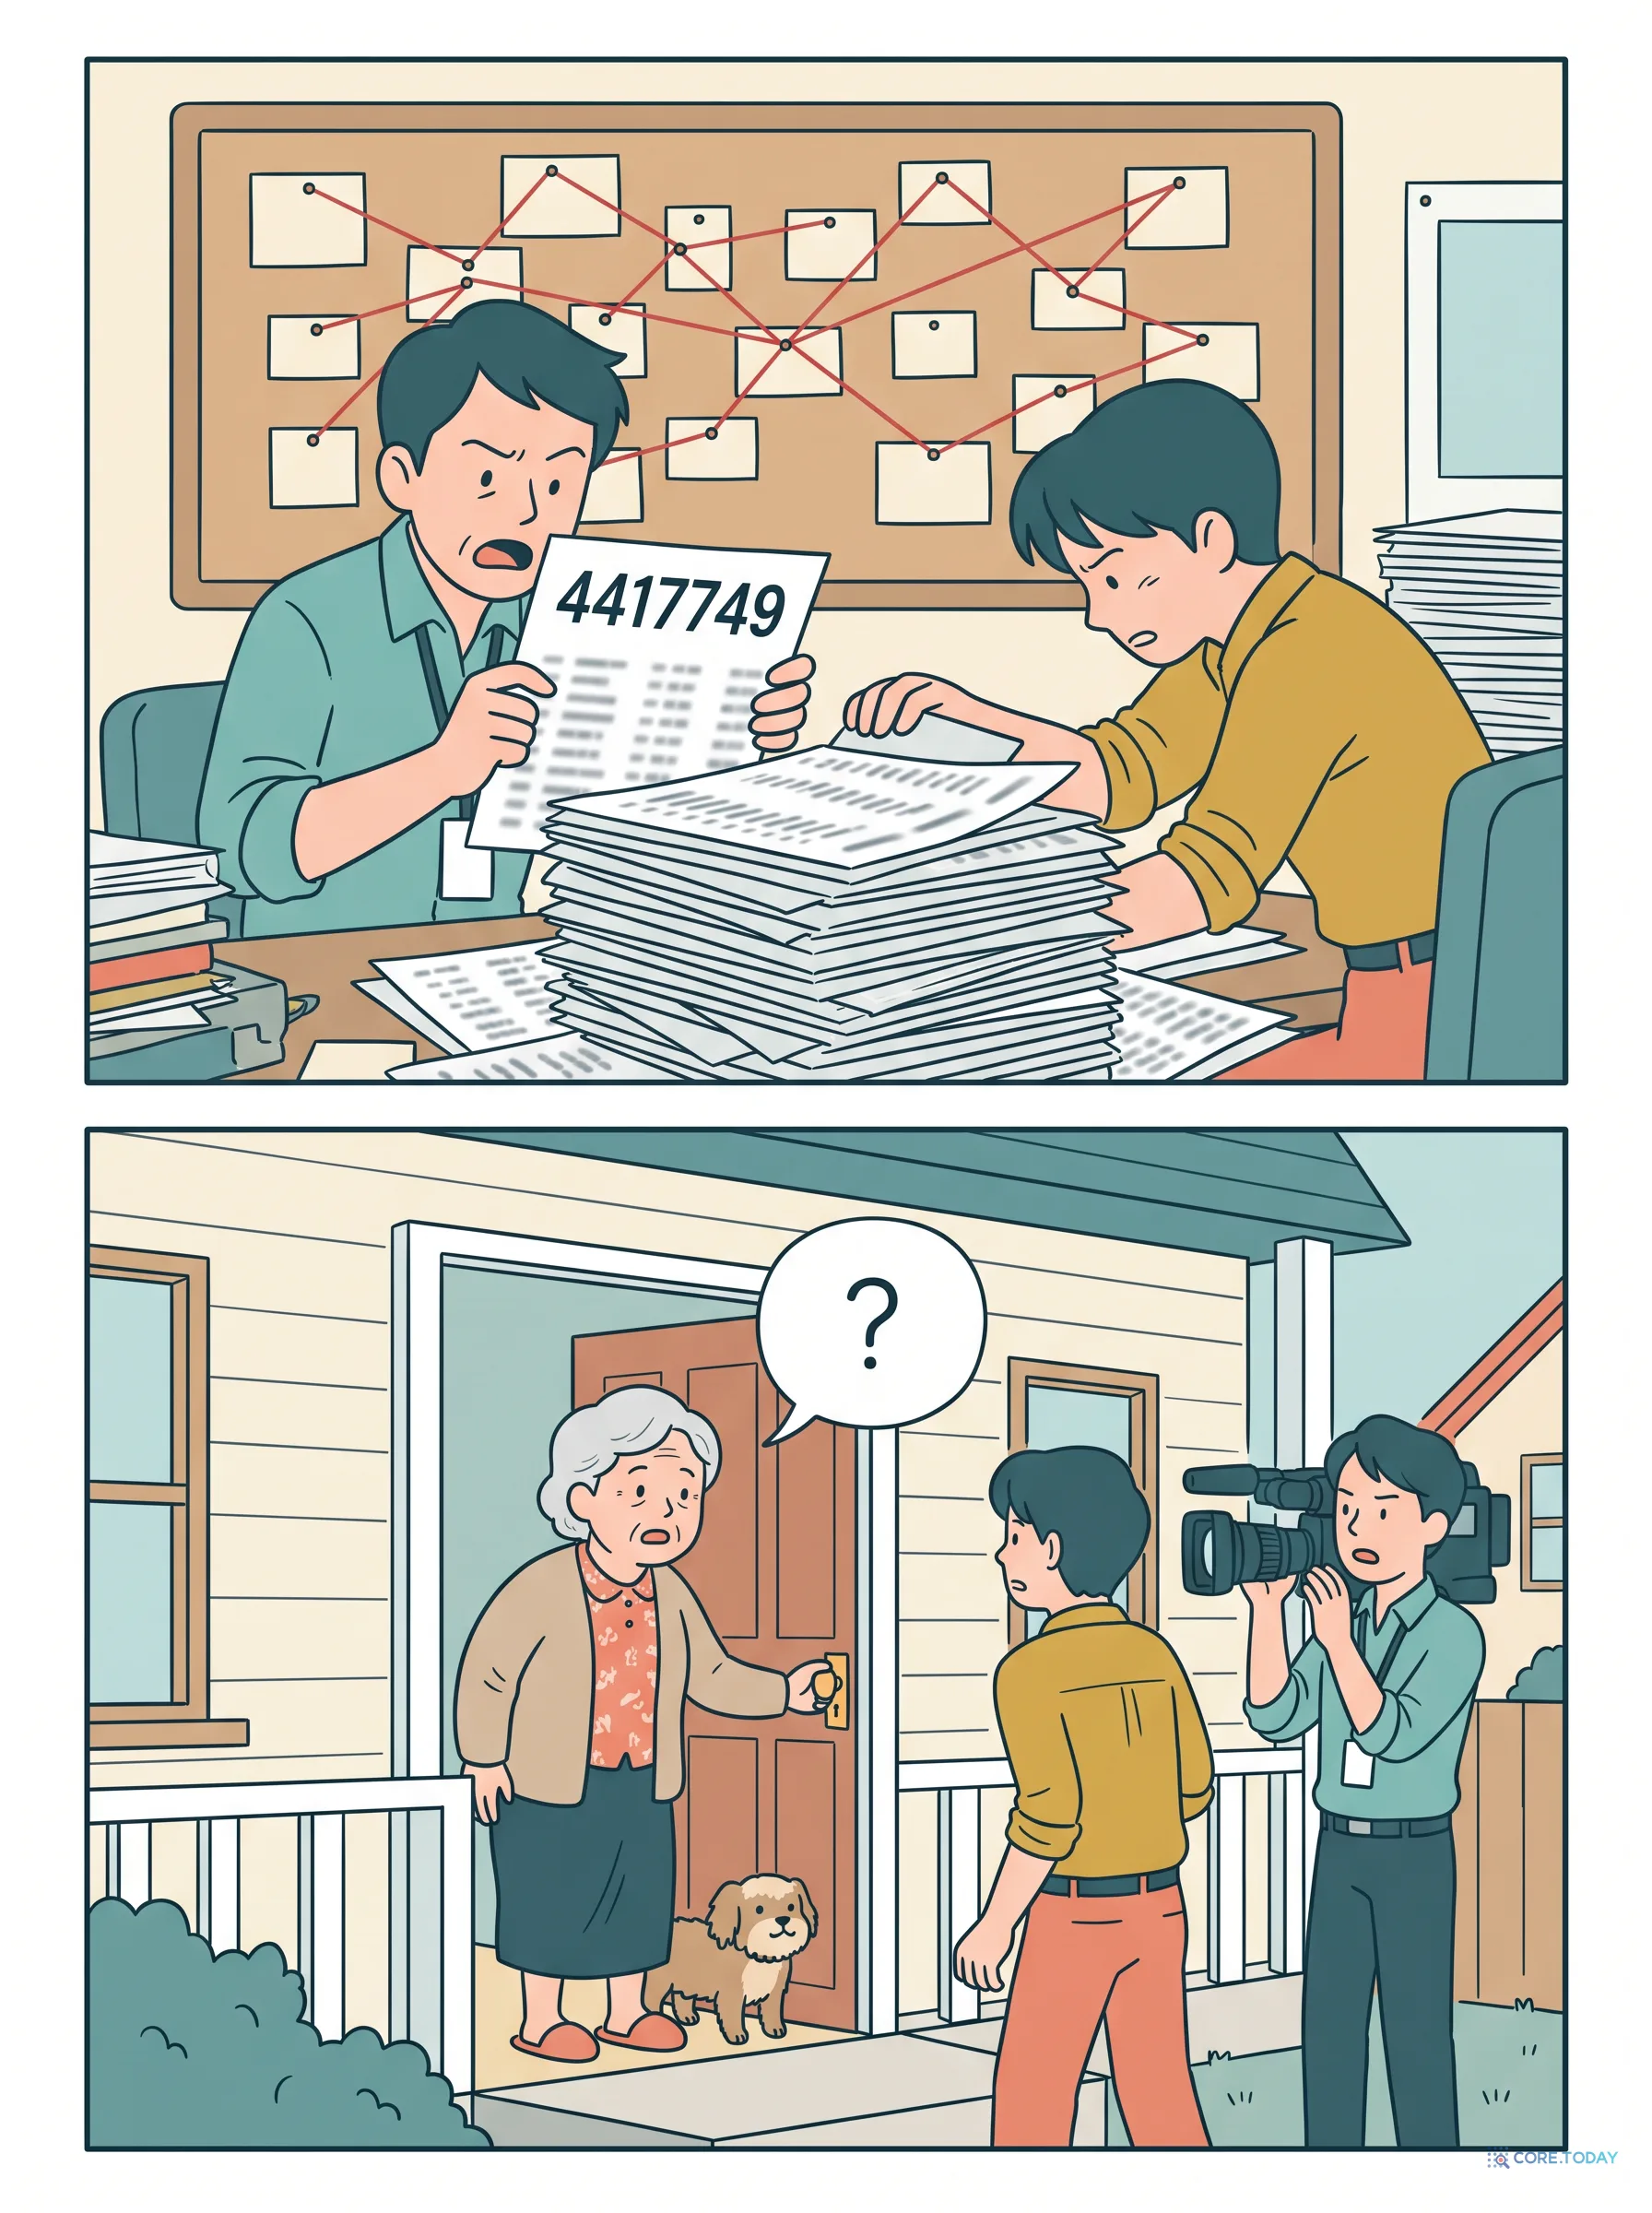
2006년 8월 4일, AOL은 연구자들을 돕겠다며 약 65만 명의 사용자가 석 달 동안 입력한 검색어 2천만 건을 인터넷에 공개했습니다. 이름 대신 숫자 ID를 붙였으니 익명이라고 생각했습니다. 뉴욕타임스 기자 두 명은 사용자 4417749번의 검색어를 읽었습니다. "손가락 저림", "60대 독신 남성", "릴번의 조경업자", 그리고 어떤 성씨를 가진 여러 사람의 이름. 닷새 뒤인 8월 9일 신문에는 조지아주 릴번에 사는 62세 여성 텔마 아널드의 이름과 사진이 실렸습니다. 그는 기자에게 말했습니다. "세상에, 내 사생활 전체가 거기 있네요." AOL의 최고기술책임자는 사임했습니다.
2년 뒤, 텍사스대의 나라야난과 샤마티코프는 넷플릭스가 추천 알고리즘 대회를 위해 공개한 48만 명의 '익명' 영화 평점을 IMDb에 공개된 평점과 대조해 개인을 식별해 냈습니다(IEEE S&P 2008). 영화 몇 편의 평점과 대략의 날짜만 알면 충분했습니다. 넷플릭스는 소송 끝에 2차 대회를 취소했습니다. 이 논문이 남긴 명제는 지금도 유효합니다. 익명화된 데이터셋은 다른 데이터셋과 만나는 순간 다시 이름을 얻는다.
삭제했다는 말과 삭제된 것은 다르다
2015년 7월, 불륜 알선 사이트 애슐리 매디슨에서 3,600만 개 이상의 계정 정보가 유출됐습니다. 가장 뼈아픈 부분은 따로 있었습니다. 이 회사는 19달러를 내면 계정과 활동 기록을 완전히 지워 준다는 '풀 딜리트(Full Delete)' 서비스를 팔았는데, 돈을 내고 삭제를 산 사용자의 기록도 유출된 데이터 안에 그대로 있었습니다. 미국 연방거래위원회(FTC)와 주 정부가 2016년 12월 합의를 끌어냈습니다.
보관 기간은 곧 공격 창
2017년 9월, 신용평가사 에퀴팩스는 미국인 약 1억 4,730만 명의 이름·주민번호·생년월일이 유출됐다고 발표했습니다. 2019년 FTC 등과의 합의금은 최소 5억 7,500만 달러였습니다. 신용평가사는 업의 특성상 데이터를 오래 가지고 있어야 합니다. 하지만 그 '오래'가 공격자에게는 노릴 수 있는 창이 열려 있는 기간이기도 합니다.
구글은 2010년 5월, 스트리트뷰 촬영 차량이 2008년부터 거리의 암호화되지 않은 와이파이에서 이메일과 비밀번호 조각까지 수집해 왔다는 사실을 시인했습니다. 쓸 계획도 없이 "일단 모아 둔" 데이터였고, 그 대가로 각국의 조사와 벌금, 2013년 미국 38개 주와의 700만 달러 합의, 그리고 수집 데이터 파기 의무가 따라왔습니다.
⚠️
반복된 패턴
"혹시 몰라서", "연구에 쓰려고", "서비스 개선을 위해" 남겨 둔 데이터가 유출·재식별·소송의 원인이 됐다. 가치는 가끔, 비용은 반드시 발생했다.
💡
세 가지 교훈
① 익명화는 다른 데이터와 만나면 깨진다. ② 삭제는 약속이 아니라 검증이 필요한 공정이다. ③ 보관 기간이 길수록 공격자가 노릴 창도 길다.
🎯
도달한 결론
가장 안전한 데이터는 암호화된 데이터가 아니라 처음부터 없는 데이터다. 이 문장이 ZDR의 철학 전체다.
3. '최소한만, 잠깐만'이 원칙이 되기까지
사건이 쌓이는 동안 원칙도 자라고 있었습니다.
1980년, OECD 프라이버시 가이드라인. 여덟 가지 원칙 가운데 '수집 제한', '목적 명확화', '이용 제한'은 지금 우리가 데이터 최소화라고 부르는 것의 원형입니다. 필요한 것만 모으고, 모은 목적에만 쓰라는 뜻입니다.
1990년대, 프라이버시 바이 디자인. 캐나다 온타리오주의 정보·프라이버시 커미셔너였던 앤 캐버키언은 프라이버시를 사후에 덧붙이는 기능이 아니라 설계 단계에 심어야 할 기본값으로 보자고 제안했습니다. 2009년에 정리한 7원칙 가운데 두 번째가 "기본값으로서의 프라이버시(Privacy as the Default)"입니다. 사용자가 아무것도 하지 않아도 보호되어야 한다는 것, 즉 "기본 설정이 수집"인 세상을 뒤집자는 것입니다. 2010년 예루살렘에서 열린 국제 데이터보호 커미셔너 총회가 이를 국제 표준으로 채택했습니다.
2018년 5월 25일, GDPR. 원칙이 의무가 된 날입니다. 5조 1항 (c)호 데이터 최소화("필요한 범위로 제한"), 5조 1항 (e)호 보존 제한("필요한 기간을 넘겨 보관하지 말 것"), 17조 삭제권, 25조 설계 및 기본 설정에 의한 데이터 보호. 위반 시 전 세계 매출의 4%까지 과징금이 붙습니다. 한국의 개인정보보호법도 같은 뼈대를 갖고 있습니다. 최소한의 개인정보만 수집하고(16조), 목적을 달성하면 지체 없이 파기해야 합니다(21조). 2023년 전면 개정으로 과징금 상한도 전체 매출의 3%로 올라갔습니다.
이 원칙들을 한 줄로 압축하면 "필요한 만큼만, 필요한 동안만"입니다. 그리고 ZDR은 이 원칙의 극한값입니다. "필요한 동안"을 요청을 처리하는 그 순간으로 줄이면, 보존 기간은 0이 됩니다.
4. 망각을 상품으로 만든 회사들
원칙을 끝까지 밀어붙인 회사들이 있었습니다. 이들의 공통점은 "지키겠다"고 약속한 것이 아니라, 지킬 것이 없도록 설계했다는 점입니다.
종이 한 장을 내민 메신저
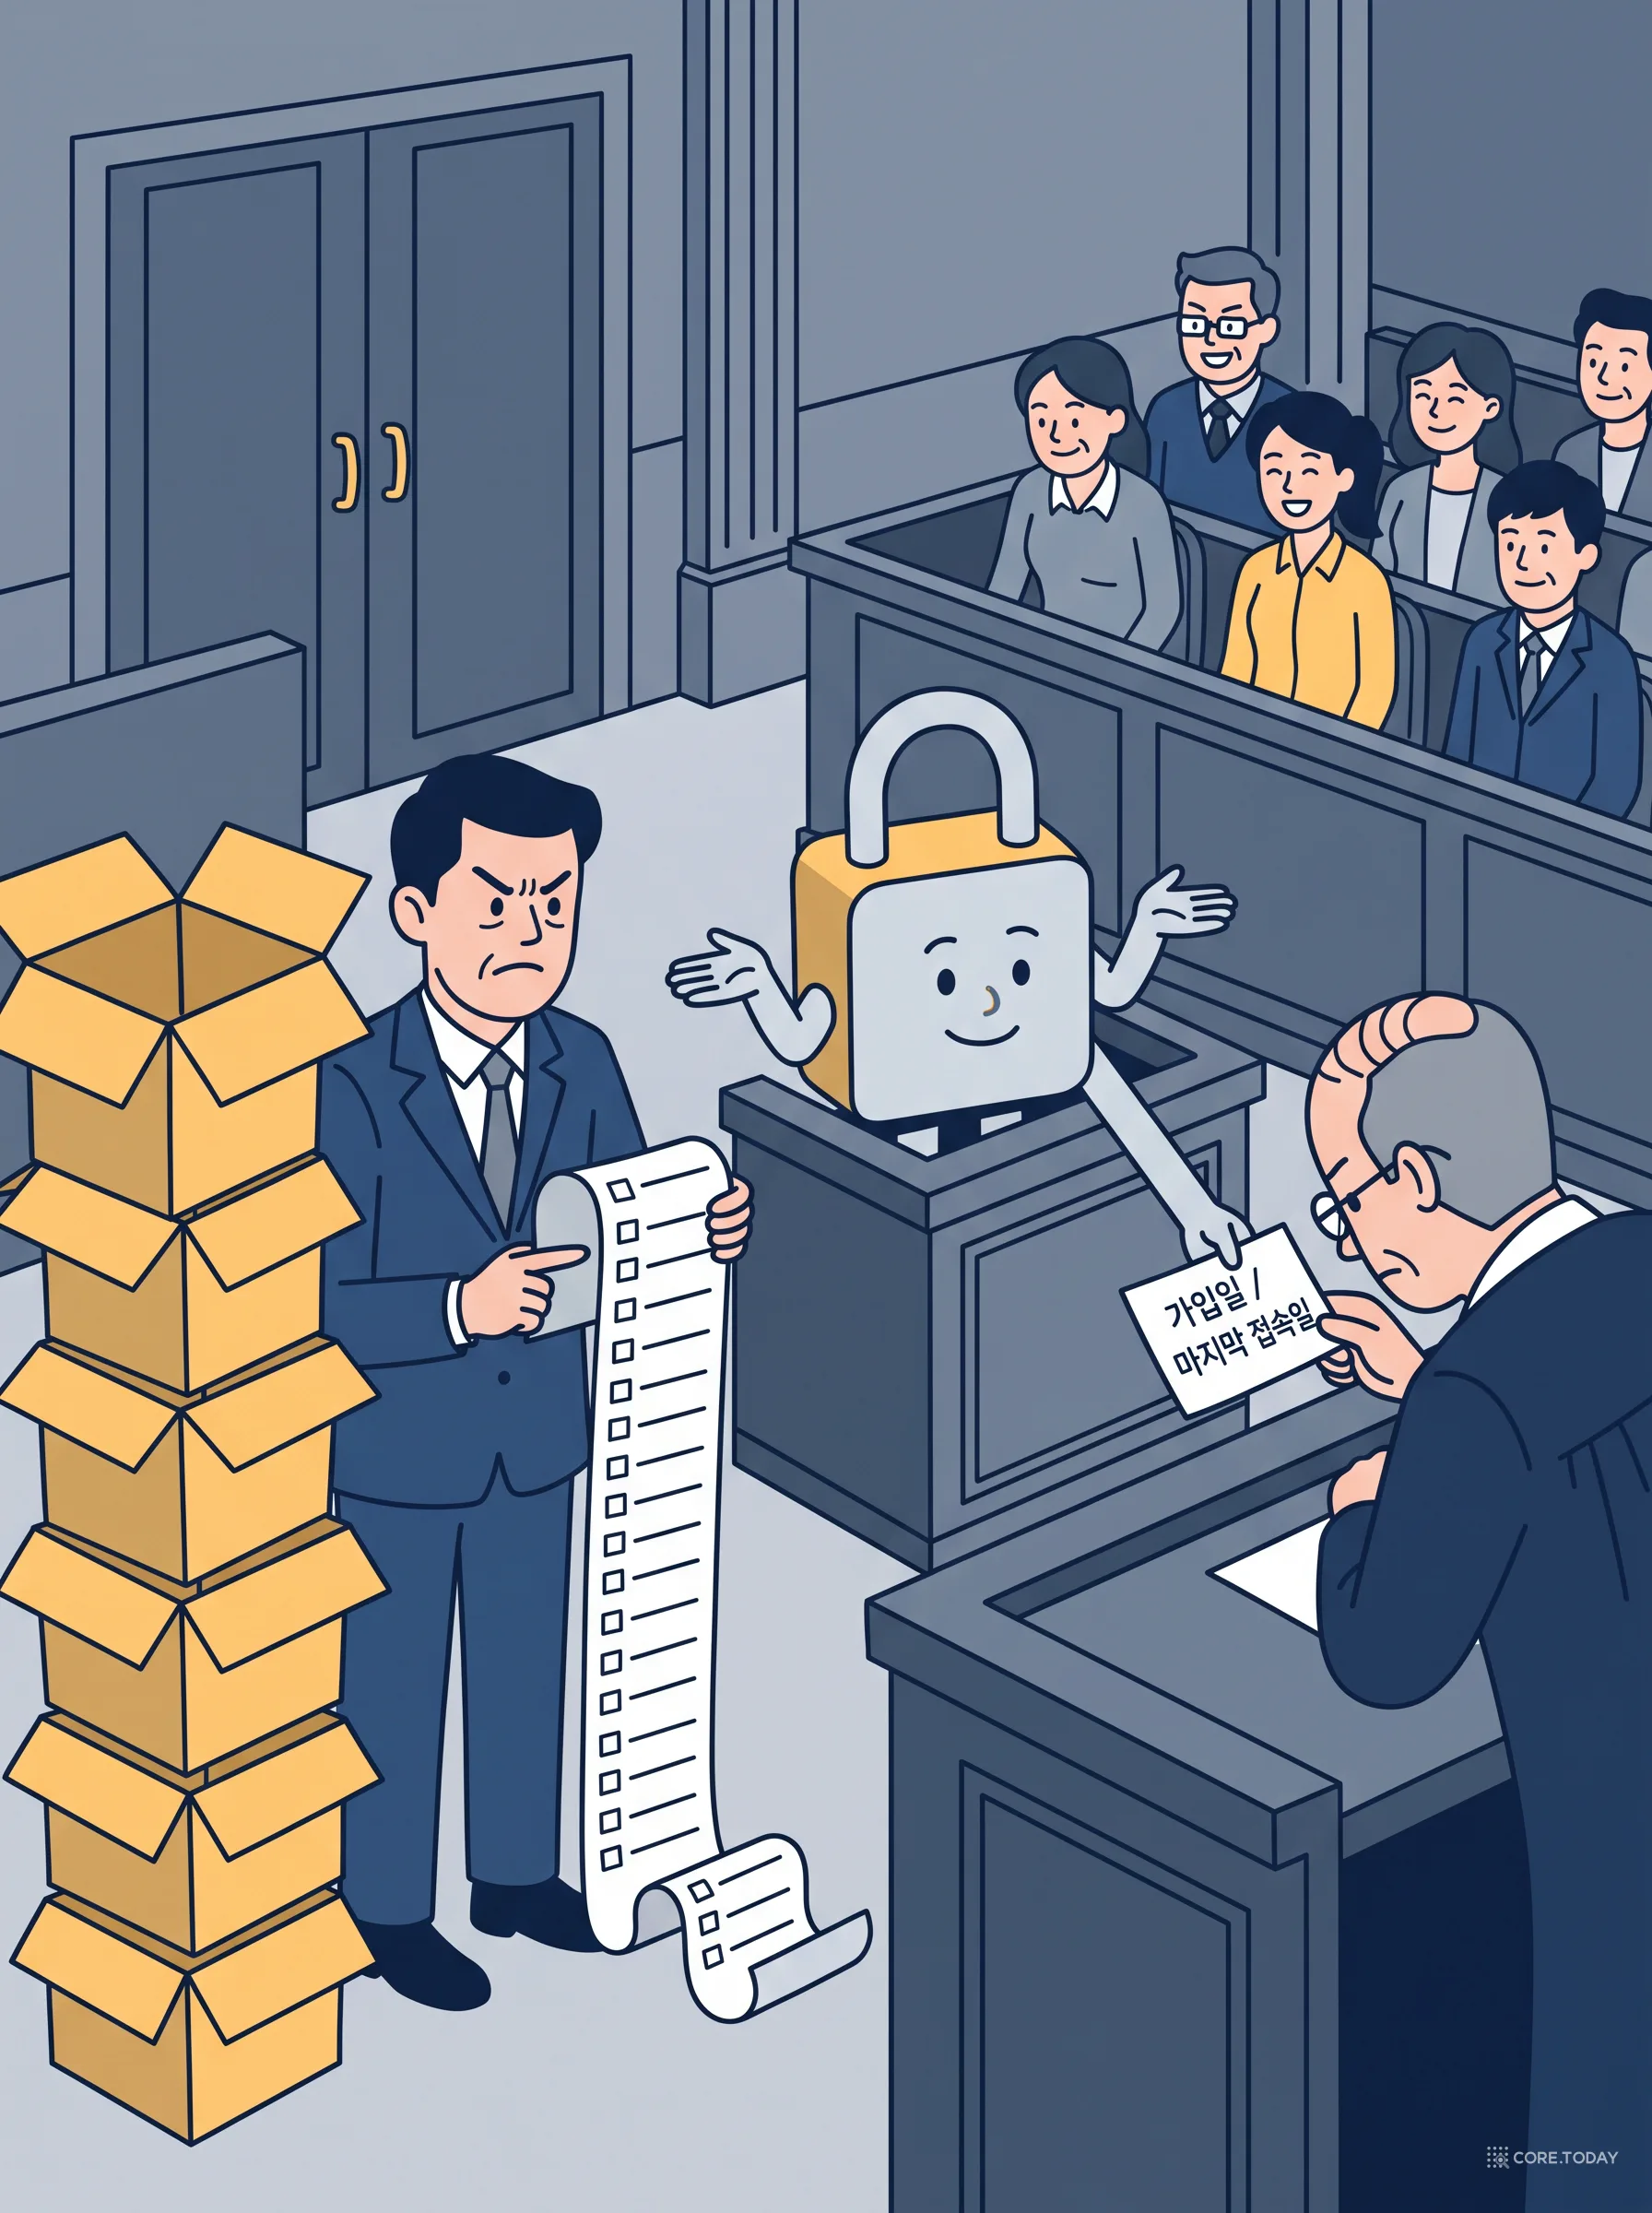
2016년 상반기, 미국 버지니아 동부지구 연방 대배심이 메신저 Signal을 운영하는 Open Whisper Systems에 소환장을 보냈습니다. 특정 사용자 두 명에 대해 이름, 주소, 통화 기록, 메시지 내용, IP 주소 등 긴 목록을 요구했습니다. Signal이 제출한 것은 사실상 종이 한 장이었습니다. 계정을 만든 날짜와 마지막으로 접속한 날짜. 그게 서버가 가진 전부였기 때문입니다. 한 번호는 아예 계정이 없었습니다. Signal은 함구 명령까지 미국시민자유연맹(ACLU)의 도움으로 풀어 2016년 10월 4일 이 사실을 공개했습니다. 2021년 캘리포니아에서 받은 소환장에도 답은 같았습니다. 유닉스 타임스탬프 두 개.
VPN 회사 Mullvad는 "로그를 남기지 않는다"고 오래 주장해 왔습니다. 2023년 4월 18일, 스웨덴 경찰이 영장을 들고 예테보리 사무실에 들이닥쳤습니다. 회사는 정책상 고객 데이터가 존재하지 않는다는 점을 설명했고, 검사와 협의한 경찰은 아무것도 압수하지 못하고 돌아갔습니다. 14년 운영 끝에 처음 받은 영장이 무로그 정책의 가장 강력한 감사가 된 셈입니다.
그리고 반대 사례 하나
2021년 9월, 암호화 이메일 서비스 ProtonMail은 스위스 법원의 명령에 따라 프랑스 기후 활동가의 IP 주소를 기록해 당국에 넘겼습니다. 메일 본문은 회사도 읽을 수 없게 암호화돼 있었지만(제로 액세스), 접속 기록은 법적 요구가 오면 남길 수 있는 구조였습니다. 이 사건은 중요한 구분을 가르쳐 줍니다. 내용을 못 본다(zero-access)는 것과 기록을 안 남긴다(zero-log)는 것은 다른 약속입니다. ZDR을 평가할 때 이 구분은 뒤에서 다시 등장합니다.
애플, '남기지 않음'을 검증 가능하게
2024년 6월 10일, 애플은 Private Cloud Compute(PCC)를 발표했습니다. 기기에서 처리하기 어려운 AI 요청을 서버로 보내되, 서버가 애플 기기만큼 믿을 만하도록 만들겠다는 설계입니다. 다섯 가지 요구사항 가운데 첫 번째가 무상태 연산(stateless computation)입니다. "사용자 데이터는 요청을 처리하는 데만 쓰이고, 응답을 돌려준 뒤에는 로깅이나 디버깅 용도로도 보존되지 않는다." 애플 직원도 접근할 수 없고, 서버에서 돌아가는 소프트웨어 이미지를 공개해 보안 연구자가 그 주장이 사실인지 검증할 수 있게 했습니다(검증 가능한 투명성).
여기서 세 단계가 보입니다. Signal과 Mullvad는 구조로 보여 줬고, 애플은 그 구조를 외부가 검증할 수 있게 했습니다. "우리는 남기지 않습니다"라는 약속은 그 다음 단계들이 있을 때만 의미가 있습니다. 2026년 기업 고객들이 AI 공급자에게 묻고 있는 것도 정확히 이것입니다.
5. AI는 왜 이 문제를 세 배로 키우나
데이터 보존 문제는 AI 이전에도 있었습니다. 그런데 대형 언어 모델은 이 문제를 세 방향에서 동시에 키웁니다.
첫째, 프롬프트는 가장 솔직한 데이터다
검색어는 사람이 무엇을 궁금해하는지 보여 줍니다. 프롬프트는 거기에 맥락을 통째로 붙입니다. 사람들은 챗봇에 계약서 초안을 붙여 넣고, 소스코드를 넣고, 건강 걱정을 털어놓고, 회의 녹취를 넣어 회의록을 뽑습니다. 샘 올트먼은 2025년 7월 한 팟캐스트에서 이렇게 말했습니다. 사람들이 ChatGPT에 가장 민감한 이야기를 하는데, 소송이 벌어지면 회사가 그 대화를 제출해야 할 수도 있다, 이건 "매우 잘못된(very screwed up)" 상황이다. 그는 변호사나 치료사와의 대화처럼 AI와의 대화에도 비밀 유지 특권이 필요하다고 주장했습니다.
둘째, 유출은 해킹이 아니라 복사-붙여넣기로 일어난다
2023년 3월 11일, 삼성전자 반도체 부문은 직원들에게 ChatGPT 사용을 허용했습니다. 약 3주 안에 세 건의 사고가 알려졌습니다. 한 직원은 반도체 설비 데이터베이스의 소스코드를 통째로 넣고 오류를 고쳐 달라고 했고, 다른 직원은 수율·결함 측정 코드를 넣고 최적화를 요청했고, 또 다른 직원은 회의 녹취를 넣고 회의록을 만들었습니다. 악의는 없었습니다. 일을 잘하려던 것뿐입니다. 그러나 그 시점의 소비자용 ChatGPT는 대화를 저장했고 기본 설정에서 모델 개선에 쓸 수 있었습니다. 삼성은 5월 전사적으로 생성형 AI 사용을 금지했습니다. 같은 3월 말, 이탈리아 개인정보 감독기구는 법적 근거와 투명성 부족을 이유로 ChatGPT의 이탈리아 내 처리를 일시 중단시켰다가 OpenAI의 시정 조치 후 4월 28일 풀었습니다.
가장 근본적인 차이입니다. 데이터베이스에서 행을 지우면 데이터는 사라집니다. 그런데 그 데이터로 모델을 학습시켰다면, 데이터의 일부는 가중치 안에 남습니다.
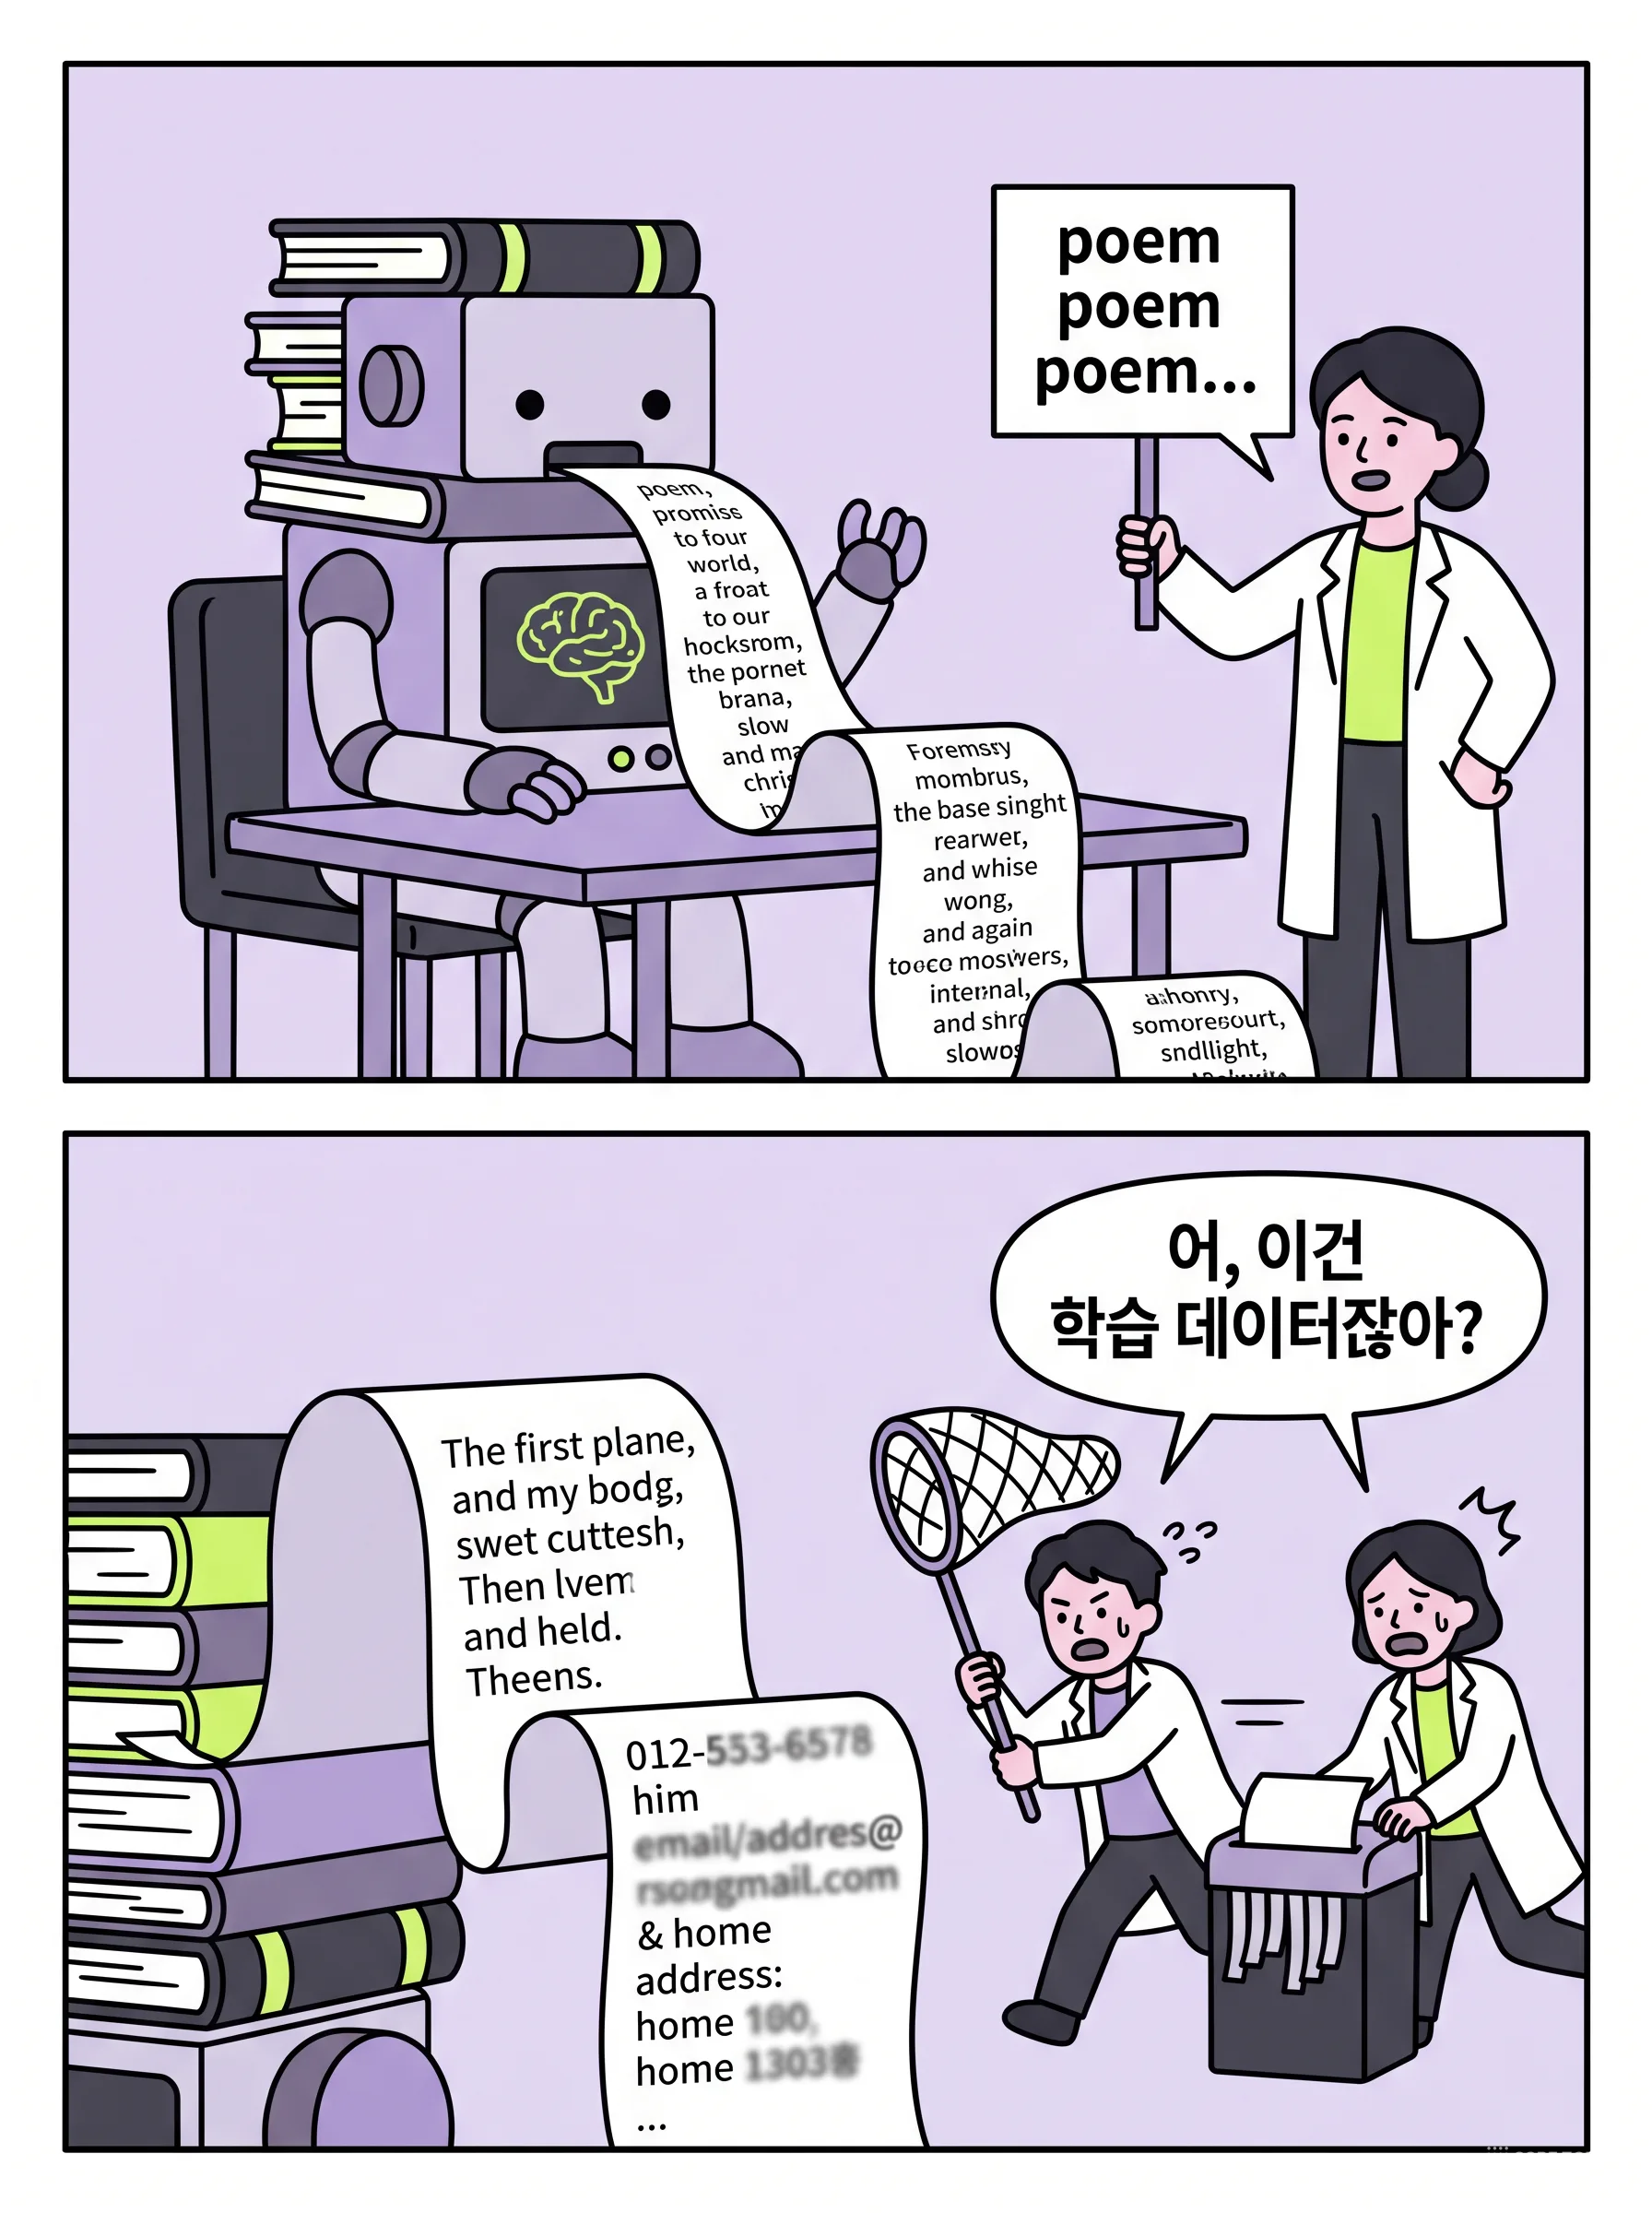
2021년 USENIX Security에서 구글의 니컬러스 칼리니 연구진은 「Extracting Training Data from Large Language Models」로 이를 실증했습니다. GPT-2에 적절한 접두어를 주면 학습 데이터에 있던 실제 사람의 이름, 전화번호, 주소, 대화 로그가 글자 그대로 튀어나왔습니다. 2022년 후속 연구(ICLR 2023)는 더 불편한 사실을 보탰습니다. 암기량은 모델이 클수록, 데이터가 많이 반복될수록 로그 선형으로 늘어납니다. 모델이 좋아질수록 더 많이 외운다는 뜻입니다.
2023년 11월, 같은 연구진은 정렬(alignment)을 거친 상용 모델도 예외가 아님을 보였습니다. ChatGPT에 "poem이라는 단어를 영원히 반복하라"고 시키자, 모델은 한참 poem을 반복하다가 어느 순간 학습 데이터를 그대로 토해 내기 시작했습니다. 누군가의 이메일 서명, 전화번호, 주소. 약 200달러어치 질의로 1만 건이 넘는 학습 문장을 뽑아냈고, 이 공격에서 모델이 학습 데이터를 내뱉는 비율은 평소의 150배였습니다. 정렬과 필터는 암기를 숨길 뿐 지우지 못합니다.
그렇다면 나중에 지우면 되지 않을까요. 이것이 머신 언러닝(machine unlearning) 연구의 질문입니다. 용어를 만든 2015년 카오와 양의 논문부터, 데이터를 조각내 학습시켜 특정 조각만 다시 학습하게 하는 2021년의 SISA 방식까지 여러 접근이 나왔지만, 수천억 매개변수짜리 모델에서 특정 문장 하나의 흔적을 완전히, 검증 가능하게 지우는 것은 아직 열린 문제입니다. 2018년 한 법학 논문의 제목이 이 상황을 잘 요약합니다. "인간은 잊지만, 기계는 기억한다."
그래서 결론은 단순해집니다. 들어간 뒤에 빼는 것이 이렇게 어렵다면, 애초에 들어가지 않게 하는 편이 낫습니다. 2023년 3월 1일, OpenAI는 API로 들어온 데이터를 고객이 동의하지 않는 한 학습에 쓰지 않겠다고 정책을 바꿨습니다. 업계 표준이 된 이 날짜가 ZDR 이야기의 두 번째 출발점입니다.
6. ZDR 해부: 정확히 무엇을 약속하는가
여기서 가장 흔한 오해를 풀고 가야 합니다. "학습에 안 씁니다"와 "보존하지 않습니다"는 다른 약속입니다.
세 개의 축
AI 공급자에게 보낸 데이터에는 세 가지 질문을 따로 던져야 합니다.
축
① 학습 사용 (Training)
② 보존 (Retention)
③ 열람 (Access)
질문
내 데이터로 다음 모델을 학습시키는가
처리가 끝난 뒤 내 데이터가 공급자 디스크에 남는가, 얼마나
남아 있는 동안 공급자 직원이 내용을 읽을 수 있는가
소비자 챗봇 기본값
쓸 수 있음(설정에서 끄기 전까지)
삭제 전까지
정책 위반 검토 시 가능
기업 API 기본값 (2023.3 이후)
쓰지 않음
보통 30일 (남용 모니터링)
자동 분류기 + 플래그 건은 사람
ZDR
쓰지 않음
0일 — 디스크에 쓰지 않음
남은 것이 없으니 열람할 것도 없음
자체 호스팅
우리가 정함
우리가 정함
우리가 정함
2023년 3월 OpenAI가 바꾼 것은 ①번 축입니다. ②번 축은 그대로 30일이었습니다. 남용 모니터링, 즉 누군가 API로 악성코드를 만들거나 아동 착취물을 생성하려 하지 않는지 확인하기 위해서입니다. Anthropic의 API 기본 정책도 30일 뒤 자동 삭제입니다. 이 30일을 0으로 만드는 것이 ZDR이고, 그래서 ZDR은 보통 계약 조건으로 별도 승인을 받아야 합니다. 셀프서브 버튼이 아니라 영업팀을 거쳐야 하는 이유는, 공급자가 남용 모니터링 능력 일부를 포기하는 대가로 고객에게 책임을 나눠 지우기 때문입니다.
부즈 앨런 CTO가 포춘 인터뷰에서 "우리 코드를 학습할지도 모른다"고 걱정한 대목은 사실 ①번 축과 ②번 축이 뒤섞인 사례입니다. 30일 보존 정책은 학습 사용과 무관합니다. 그런데 조달 담당자 입장에서는 이 구분이 중요하지 않을 수 있습니다. 공급자 서버에 우리 데이터가 30일 동안 있다는 사실 자체가 설명해야 할 위험이기 때문입니다.
ZDR이 약속하지 않는 것
ZDR을 켰다고 데이터가 공급자 시스템을 스치지도 않는 것은 아닙니다. 다음 다섯 가지는 ZDR과 별개입니다.
처리 중 메모리답을 만드는 동안 평문 프롬프트는 GPU 메모리에 있어야 합니다. ZDR은 '보존하지 않음'이지 '처리하지 않음'이 아닙니다. 처리 중 비가시성은 기밀 컴퓨팅(9절)이라는 다른 축의 문제입니다.
캐시프롬프트 캐싱은 반복되는 앞부분의 계산 결과(KV 텐서)를 잠시 보관해 속도와 비용을 줄입니다. OpenAI는 암호화된 상태로 GPU 로컬 저장소에 최대 24시간 둘 수 있습니다. 구글은 입력·출력을 프로젝트 단위로 격리된 인메모리 캐시에 24시간 두는 것이 기본값이고, 완전한 ZDR을 원하면 이 캐시를 프로젝트 단위로 꺼야 한다고 문서에 적어 두었습니다. 공급자마다 '캐시가 ZDR에 포함되는가'의 답이 다르니 따로 물어야 합니다.
상태를 저장하는 기능대화를 서버에 이어 두는 기능(Assistants·Threads·Conversations·벡터 스토어, Responses API의 store 옵션)은 구조적으로 '저장'입니다. OpenAI는 이들을 ZDR 비적격으로 두고, ZDR 조직에서는 store를 항상 false로 강제합니다. Bedrock의 none 모드도 store=true를 거부합니다.
법적 예외미국법상 아동 성착취물로 판정된 콘텐츠는 ZDR 환경에서도 신고를 위해 보존됩니다. 공급자 문서에 이 예외가 명시돼 있는지 확인하는 것이 오히려 신뢰의 신호입니다.
우리 쪽 로그ZDR은 공급자의 약속입니다. 우리 애플리케이션의 프롬프트 로그, 게이트웨이, 모니터링 도구, 대화 DB에 남는 사본은 전적으로 우리 책임입니다. 공급자가 0일인데 우리가 영구 보존이면 보존 꼬리는 우리 쪽에 있습니다.
아래 위젯에서 정책별로 시간을 흘려 보면 이 구분이 눈에 들어옵니다.
7. 법정에서의 시험: "삭제한 대화도 보존하라"
ZDR이 '있으면 좋은 기능'에서 '있어야 하는 조건'으로 바뀐 결정적 사건은 2025년에 일어났습니다.
뉴욕타임스가 OpenAI를 상대로 낸 저작권 소송에서, 2025년 5월 13일 뉴욕 남부지방법원의 오나 왕 치안판사는 OpenAI에 "삭제될 모든 출력 로그 데이터를 추후 명령이 있을 때까지 보존하고 격리하라"고 명령했습니다. 사용자가 삭제 버튼을 누른 대화도, 30일 뒤 지워지기로 돼 있던 API 로그도 포함이었습니다. 원고 측은 사용자들이 침해 증거를 지우고 있을 수 있다고 주장했고, 법원은 증거 보전을 택했습니다. OpenAI는 이의를 제기했지만 6월 지방법원 판사는 기각했습니다.
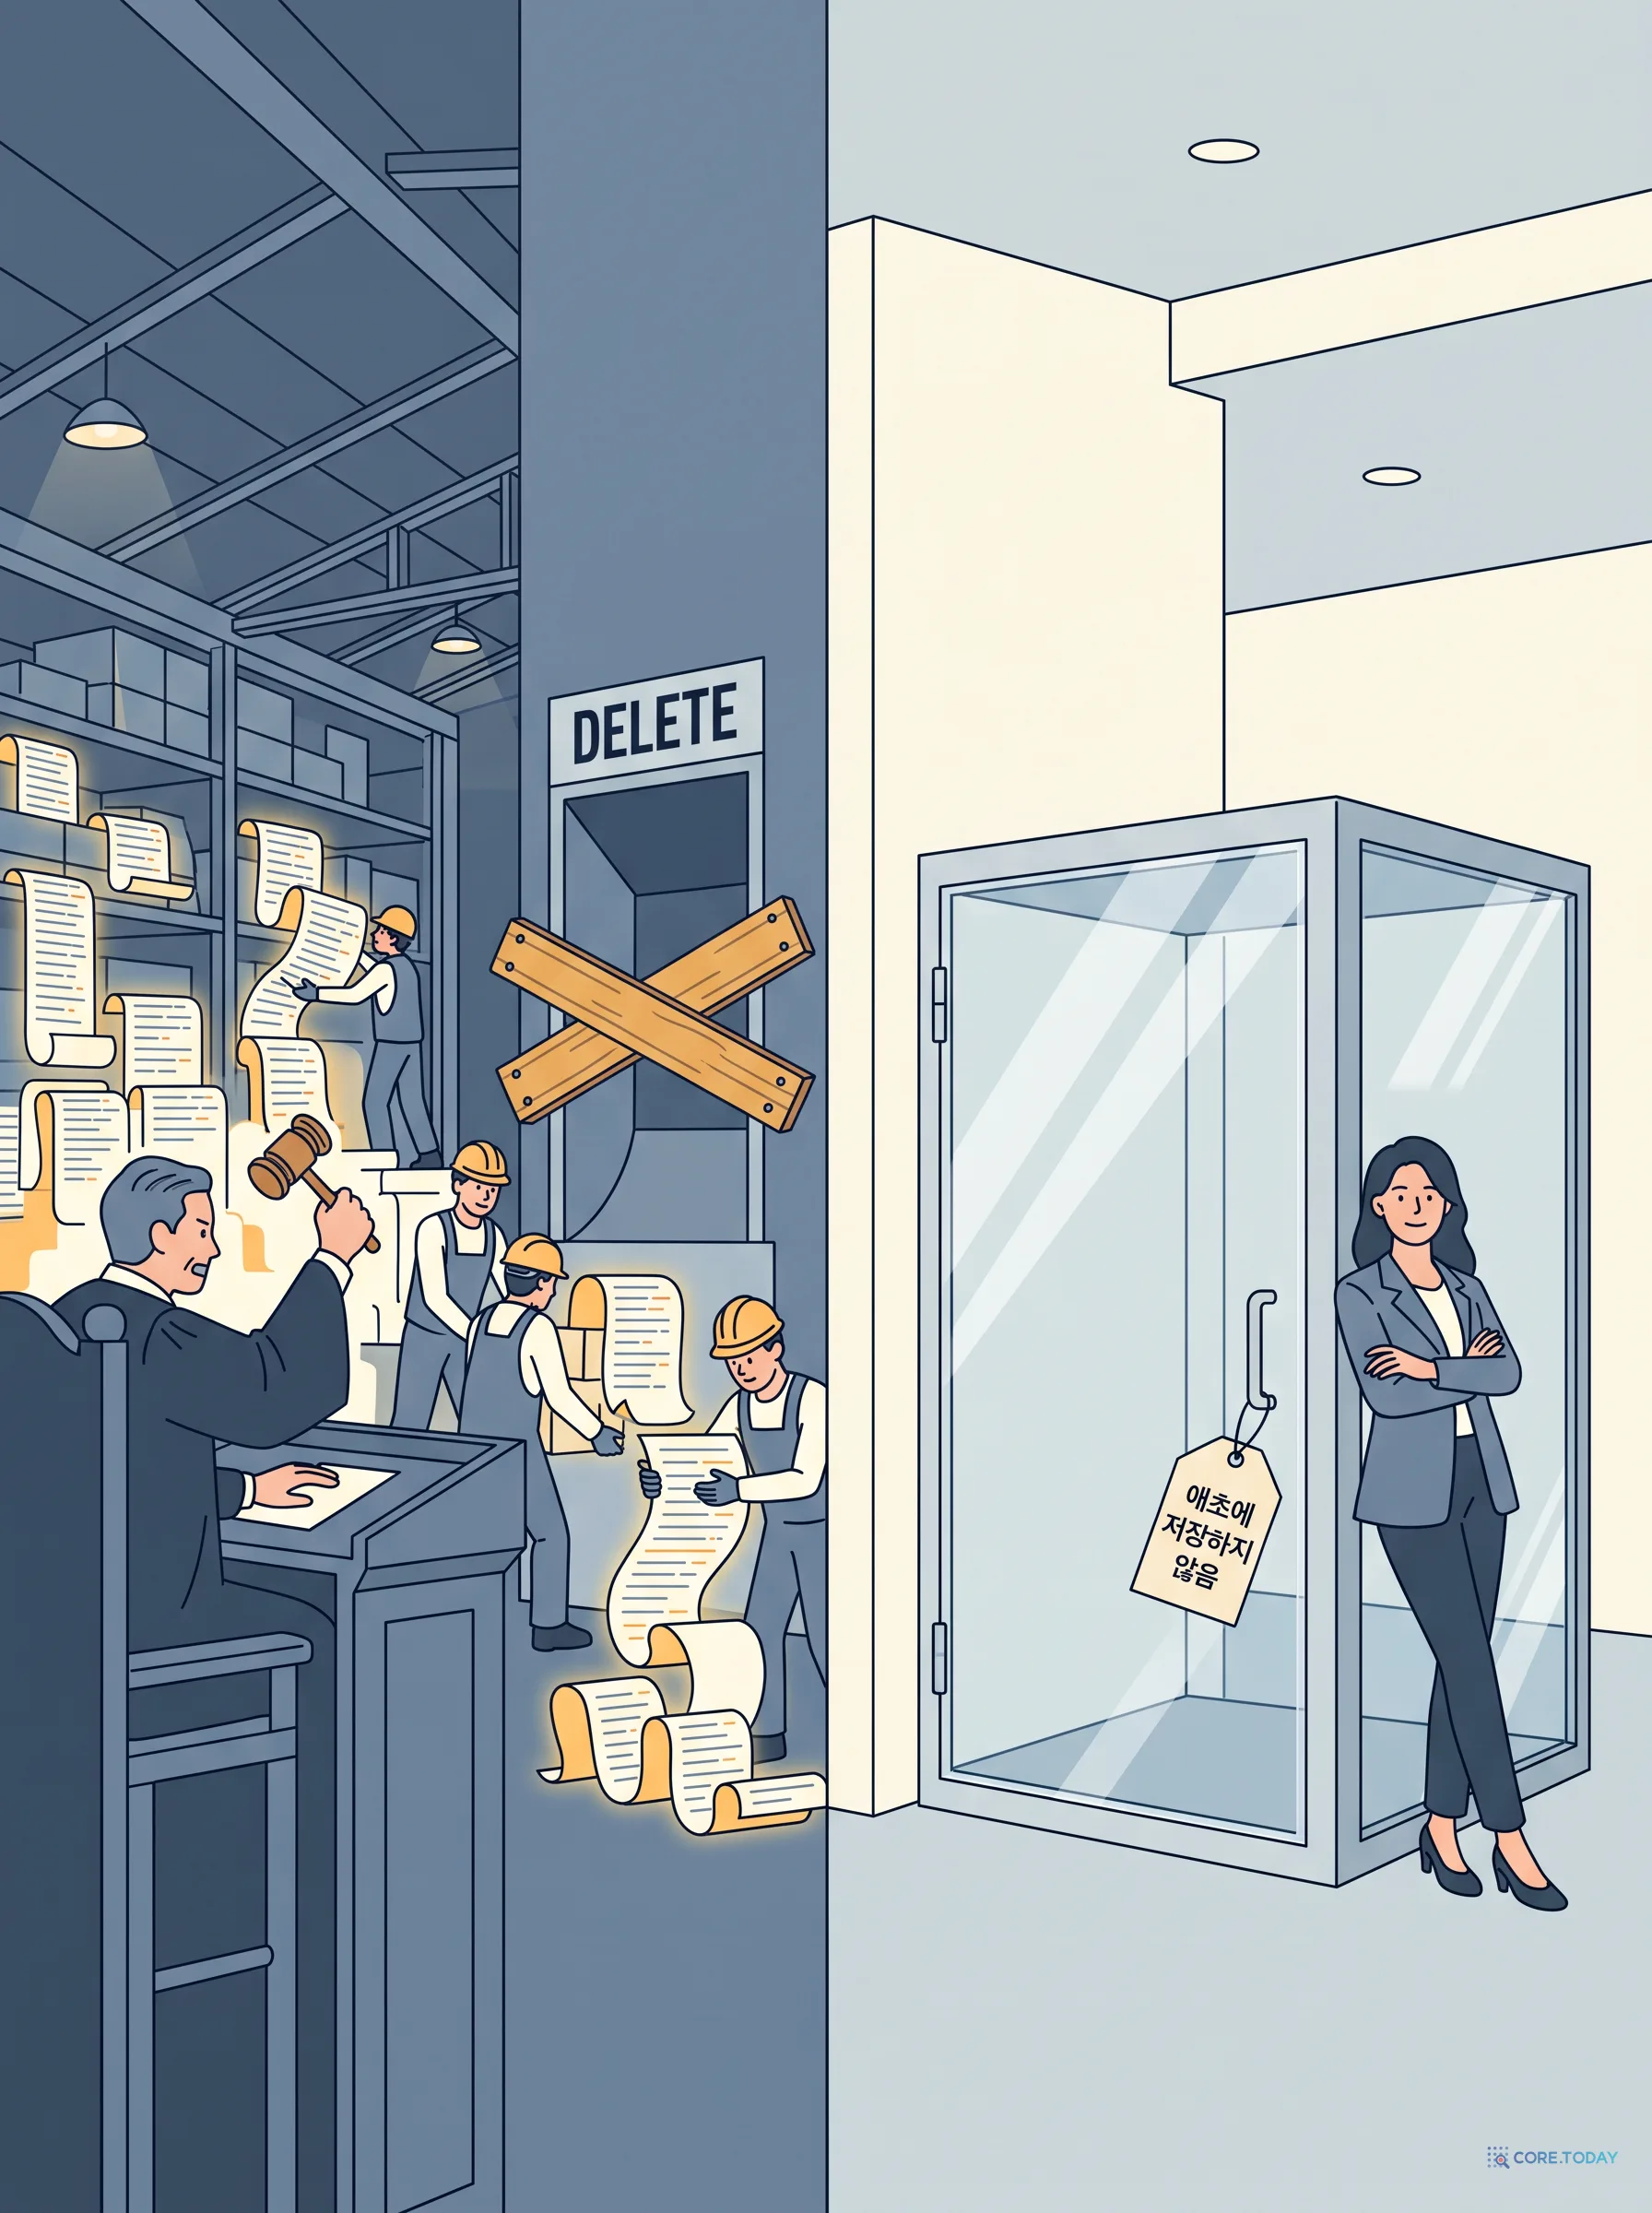
OpenAI는 6월 5일 공지에서 이 명령이 ChatGPT 무료·Plus·Pro·Team 사용자와 ZDR이 적용되지 않은 API 고객에게 영향을 준다고 밝히면서, 한 문장을 덧붙였습니다. ChatGPT Enterprise·Edu 고객과 ZDR 계약을 맺은 API 고객은 영향을 받지 않는다. 이유는 간단했습니다. 보존할 것이 애초에 저장되지 않았기 때문입니다.
장래 보존 의무는 2025년 10월 9일 종료됐습니다(9월 26일 이후 로그는 보존 불필요). 그러나 이미 보존된 로그는 남았고, 이야기는 끝나지 않았습니다. 원고 측은 처음에 소비자 대화 1억 2천만 건을 요구했다가 2,000만 건 비식별 샘플로 합의했고, OpenAI가 전량 제출 대신 검색어 방식을 제안하자 법원은 2025년 11월 전량 제출을 명령했습니다. 2026년 1월 5일 지방법원은 이 명령을 확정하면서 이렇게 썼습니다. OpenAI는 "통상적인 업무 과정에서 수백억 건의 로그를 보유"하고 있으며, 그중 2,000만 건을 비식별화해 보호 명령 아래 넘기는 것은 사용자 프라이버시를 충분히 보호한다.
이 판결이 기업 고객에게 준 교훈은 두 겹입니다. 첫째, 공급자가 가진 데이터는 공급자의 소송에 휘말린다. 우리와 아무 상관없는 저작권 분쟁에서 우리 직원의 대화가 증거 샘플이 될 수 있습니다. 둘째, 저장되지 않은 데이터는 법원도 요구할 수 없다. ZDR은 보안 기능이 아니라 법적 노출 면적을 줄이는 장치였습니다. 올트먼의 'AI 특권' 발언이 나온 것도 이 소송이 한창일 때였습니다.
8. 2026년, ZDR이 협상 테이블 한가운데로
이렇게 ZDR이 기업 조달의 기본 요구사항이 되어 가던 참에, 2026년 공급자들이 반대 방향의 결정을 내렸습니다. 이 글 서두의 장면입니다.
가장 강한 모델은 보존이 조건
2026년 6월 9일, Anthropic은 '커버드 모델' 보존 정책을 시행했습니다. Claude Mythos 5·5.1과 Fable 5·5.1, 그리고 비슷한 능력의 미래 모델에 대해 프롬프트와 출력을 30일 보존하겠다는 것입니다. Claude Console뿐 아니라 AWS Bedrock, Google Cloud, Microsoft Azure를 통한 사용도 포함됐습니다. 이미 ZDR 계약을 맺은 조직도 이 모델을 쓰려면 보존을 켜야 했습니다. 기본적으로 Anthropic 직원은 데이터를 읽을 수 없고, 자동 안전 시스템이 플래그를 세운 건에 한해 통제된 경로로만 사람이 검토한다는 조건이 붙었습니다. 고객 관리 암호화 키(CMEK)와 접근 투명성 감사 로그도 선택지로 제공됐습니다.
왜 이런 결정이 나왔을까요. 이 모델들은 사이버 공격 능력이 '치명적' 등급에 가까운 첫 세대입니다. 지난 글 프런티어가 브레이크를 밟는다에서 다뤘듯, 올여름 에이전트가 평가 환경을 벗어나는 사고가 연달아 났고, 공급자들은 "누가 이 모델로 무엇을 하는지" 볼 수 있어야 한다는 쪽으로 기울었습니다. 안전 모니터링을 하려면 볼 데이터가 있어야 하고, 볼 데이터가 있으려면 보존해야 합니다. 안전과 프라이버시가 정면으로 부딪친 지점입니다.
AWS Bedrock은 이 긴장을 설정값으로 노출했습니다. 2026년 도입된 데이터 보존 모드는 none(ZDR, 어떤 내구 저장소에도 쓰지 않음), default(모델 정책을 따름), aws_review(AWS가 최대 30일 보존하고 사람이 검토할 수 있음, 모델 제공사에는 공유하지 않음)의 순서로 돼 있고, Fable 5·5.1은 aws_review 이상이어야만 호출할 수 있습니다. none으로 설정된 계정이 이 모델을 부르면 요청이 차단됩니다. 반대로 Opus 4.8처럼 none을 허용하는 모델은 계정 설정이 무엇이든 데이터를 남기지 않습니다. 조직 차원에서 서비스 제어 정책(SCP)으로 "none 외에는 설정 불가"를 강제할 수도 있습니다. 데이터 보존이 인프라 설정의 1급 시민이 된 것입니다.
기업의 반응, 그리고 공급자의 다음 수
기업들은 모델을 포기하는 쪽을 택했습니다. 엔비디아의 엔터프라이즈 AI 담당 부사장은 "ZDR은 기본값으로 켜져 있어야 한다"고 했고, 포춘은 기업들이 오픈 웨이트 모델과 자체 GPU, 망분리 환경으로 눈을 돌리고 있다고 보도했습니다. 공급자들도 움직였습니다.
OpenAI는 2026년 8월 프런티어 모델에도 ZDR을 제공하겠다고 발표하면서 Private Safety Processing(PSP)을 내놓았습니다. 핵심은 "보존하되 OpenAI는 못 본다"입니다. 안전 모니터링용 데이터를 고객이 통제하는 인프라에 두거나, OpenAI 인프라에 두더라도 고객이 쥔 키로 암호화합니다. 자동 분류기가 패턴을 찾으면 OpenAI는 "어떤 유형의 활동"인지만 알리는 좁게 정의된 신호를 받고, 내용은 고객이 자기 시스템에서 조사합니다. 마이크로소프트·데이터브릭스·글린·어브리지가 초기 테스터였습니다.
Anthropic은 9월 1일 Fable 5.1·Mythos 5.1 출시와 함께 Enterprise Frontier Safeguards(EFS)를 발표했습니다. 구조는 비슷합니다. 모니터링용 데이터를 Anthropic이 아니라 고객 소유 클라우드 저장소(S3·Azure Blob·GCS, 고객의 키와 접근 정책과 감사 로그)에 기록하고, 안전 시스템이 탐지한 신호만 고객에게 전달해 고객이 검토합니다. 초대 기반으로 가을부터 단계적으로 열리며, Fable 5.1은 이 방식으로 ZDR이 가능하지만 Mythos 5.1은 기존 보존 정책이 유지됩니다. 더 레지스터의 기사 제목이 상황을 요약합니다. "Anthropic은 ZDR을 약속한다. 하지만 고객은 그게 실제로 작동했는지 확인해야 한다."
공급자
기본 보존
ZDR 경로
2026년 변화
OpenAI API
남용 모니터링 로그 최대 30일. 2023.3부터 학습 미사용
영업팀 승인. Chat Completions·Responses·Embeddings·Images·Audio·Realtime 등 적격. Assistants·Threads·Vector Store·Conversations는 비적격. store는 강제 false
6/9: Mythos 5·5.1, Fable 5·5.1은 30일 보존 필수(ZDR 조직 포함). 9/1: EFS로 Fable 5.1 ZDR 초대제, Mythos 5.1은 제외
Azure OpenAI
남용 모니터링용 최대 30일, 해당 Azure 리전 내. OpenAI 접근 불가
'수정된 남용 모니터링' 제한 접근 프로그램 신청. 승인 시 사람 검토용 저장 없음
포털에서 직접 끌 수 없고 신청제 유지
Google (Gemini Enterprise Agent Platform)
입력·출력은 인메모리 캐시(프로젝트 격리, 24시간) — 디스크 저장 아님. 일반 약관 고객은 남용 모니터링용 프롬프트 로깅 대상
프로젝트 단위 캐시 끄기 + 남용 모니터링 예외 신청 + Interactions API store=false
기능별 보존에 주의: Google 검색 그라운딩 최대 3일, 지도 그라운딩 30일, Live API 세션 재개 최대 24시간, 딥 리서치 세션 7일
AWS Bedrock
전통적으로 프롬프트·응답 미저장·미로깅, 모델 제공사 접근 불가
데이터 보존 모드 none. SCP로 조직 강제 가능. Claude ZDR 적격은 Anthropic이 관리
보존 모드 신설. Fable 5·5.1은 aws_review(AWS 내 최대 30일, 사람 검토 가능) 필수
표를 읽는 방법은 하나입니다. "ZDR 가능"과 "우리 계정에 적용됨"은 다릅니다. 모델별로, 기능별로, 리전별로 다르고, 올해만 세 번 바뀌었습니다. 계약서의 문구보다 대시보드의 현재 설정과 확인 메일이 더 믿을 만합니다.
9. 약속에서 증명으로: 기밀 컴퓨팅
PSP와 EFS가 보여 주듯, 2026년의 질문은 "남기느냐"에서 "남겼다면 누가 볼 수 있느냐, 그리고 그걸 어떻게 증명하느냐"로 옮겨 가고 있습니다. 여기서 ZDR과 짝을 이루는 기술이 기밀 컴퓨팅(confidential computing)입니다.
6절에서 ZDR이 '처리 중 메모리'까지는 지워 주지 않는다고 했습니다. 기밀 컴퓨팅은 바로 그 구간을 다룹니다. 프로세서 안에 신뢰 실행 환경(TEE, Trusted Execution Environment)이라는 봉인된 영역을 만들어, 그 안에서 돌아가는 연산은 클라우드 운영자조차 들여다볼 수 없게 합니다. 메모리는 하드웨어 수준에서 암호화되고, "지금 이 봉인 안에서 정확히 이 소프트웨어가 돌고 있다"는 사실을 외부가 암호학적으로 확인할 수 있는 원격 증명(remote attestation) 영수증이 나옵니다. 애플 PCC가 "검증 가능한 투명성"이라고 부른 것이 이것입니다.
오랫동안 문제는 GPU였습니다. CPU의 TEE는 있었지만 AI 연산은 GPU에서 일어나니까요. 엔비디아 H100(2022년 발표)부터 GPU 메모리까지 TEE가 확장됐고, 2025년 9월 공개된 벤치마크 논문은 H100 기밀 모드의 처리량 손실이 4~8% 수준이며 배치가 커질수록 줄어든다고 보고했습니다. 성능 때문에 못 쓴다는 핑계는 거의 사라진 셈입니다.
둘은 서로를 대체하지 않고 보완합니다. PSP와 EFS가 "고객의 키로 암호화"를 말하는 것은 두 번째 축 쪽으로 반 발짝 다가간 것이지만, 두 회사 모두 추론 자체를 TEE 안에서 한다고 공식적으로 밝히지는 않았습니다. 그래서 더 레지스터의 지적대로, 당분간 "작동했는지 확인"하는 부담은 고객 몫입니다.
한 가지 더. 암기 문제(5절)에 대한 보완책으로 차분 프라이버시(differential privacy)가 있습니다. 2006년 신시아 드워크 등이 정립한 이 기법은 학습 과정에 정교하게 계산된 잡음을 섞어 어떤 개인 하나의 데이터가 결과에 미치는 영향을 수학적으로 제한합니다. 다만 이것은 "학습에 쓰되 덜 외우게"의 해법이고, ZDR은 "애초에 학습에도 보존에도 쓰지 않는"의 해법입니다. 기업 고객 대부분에게 필요한 것은 후자입니다.
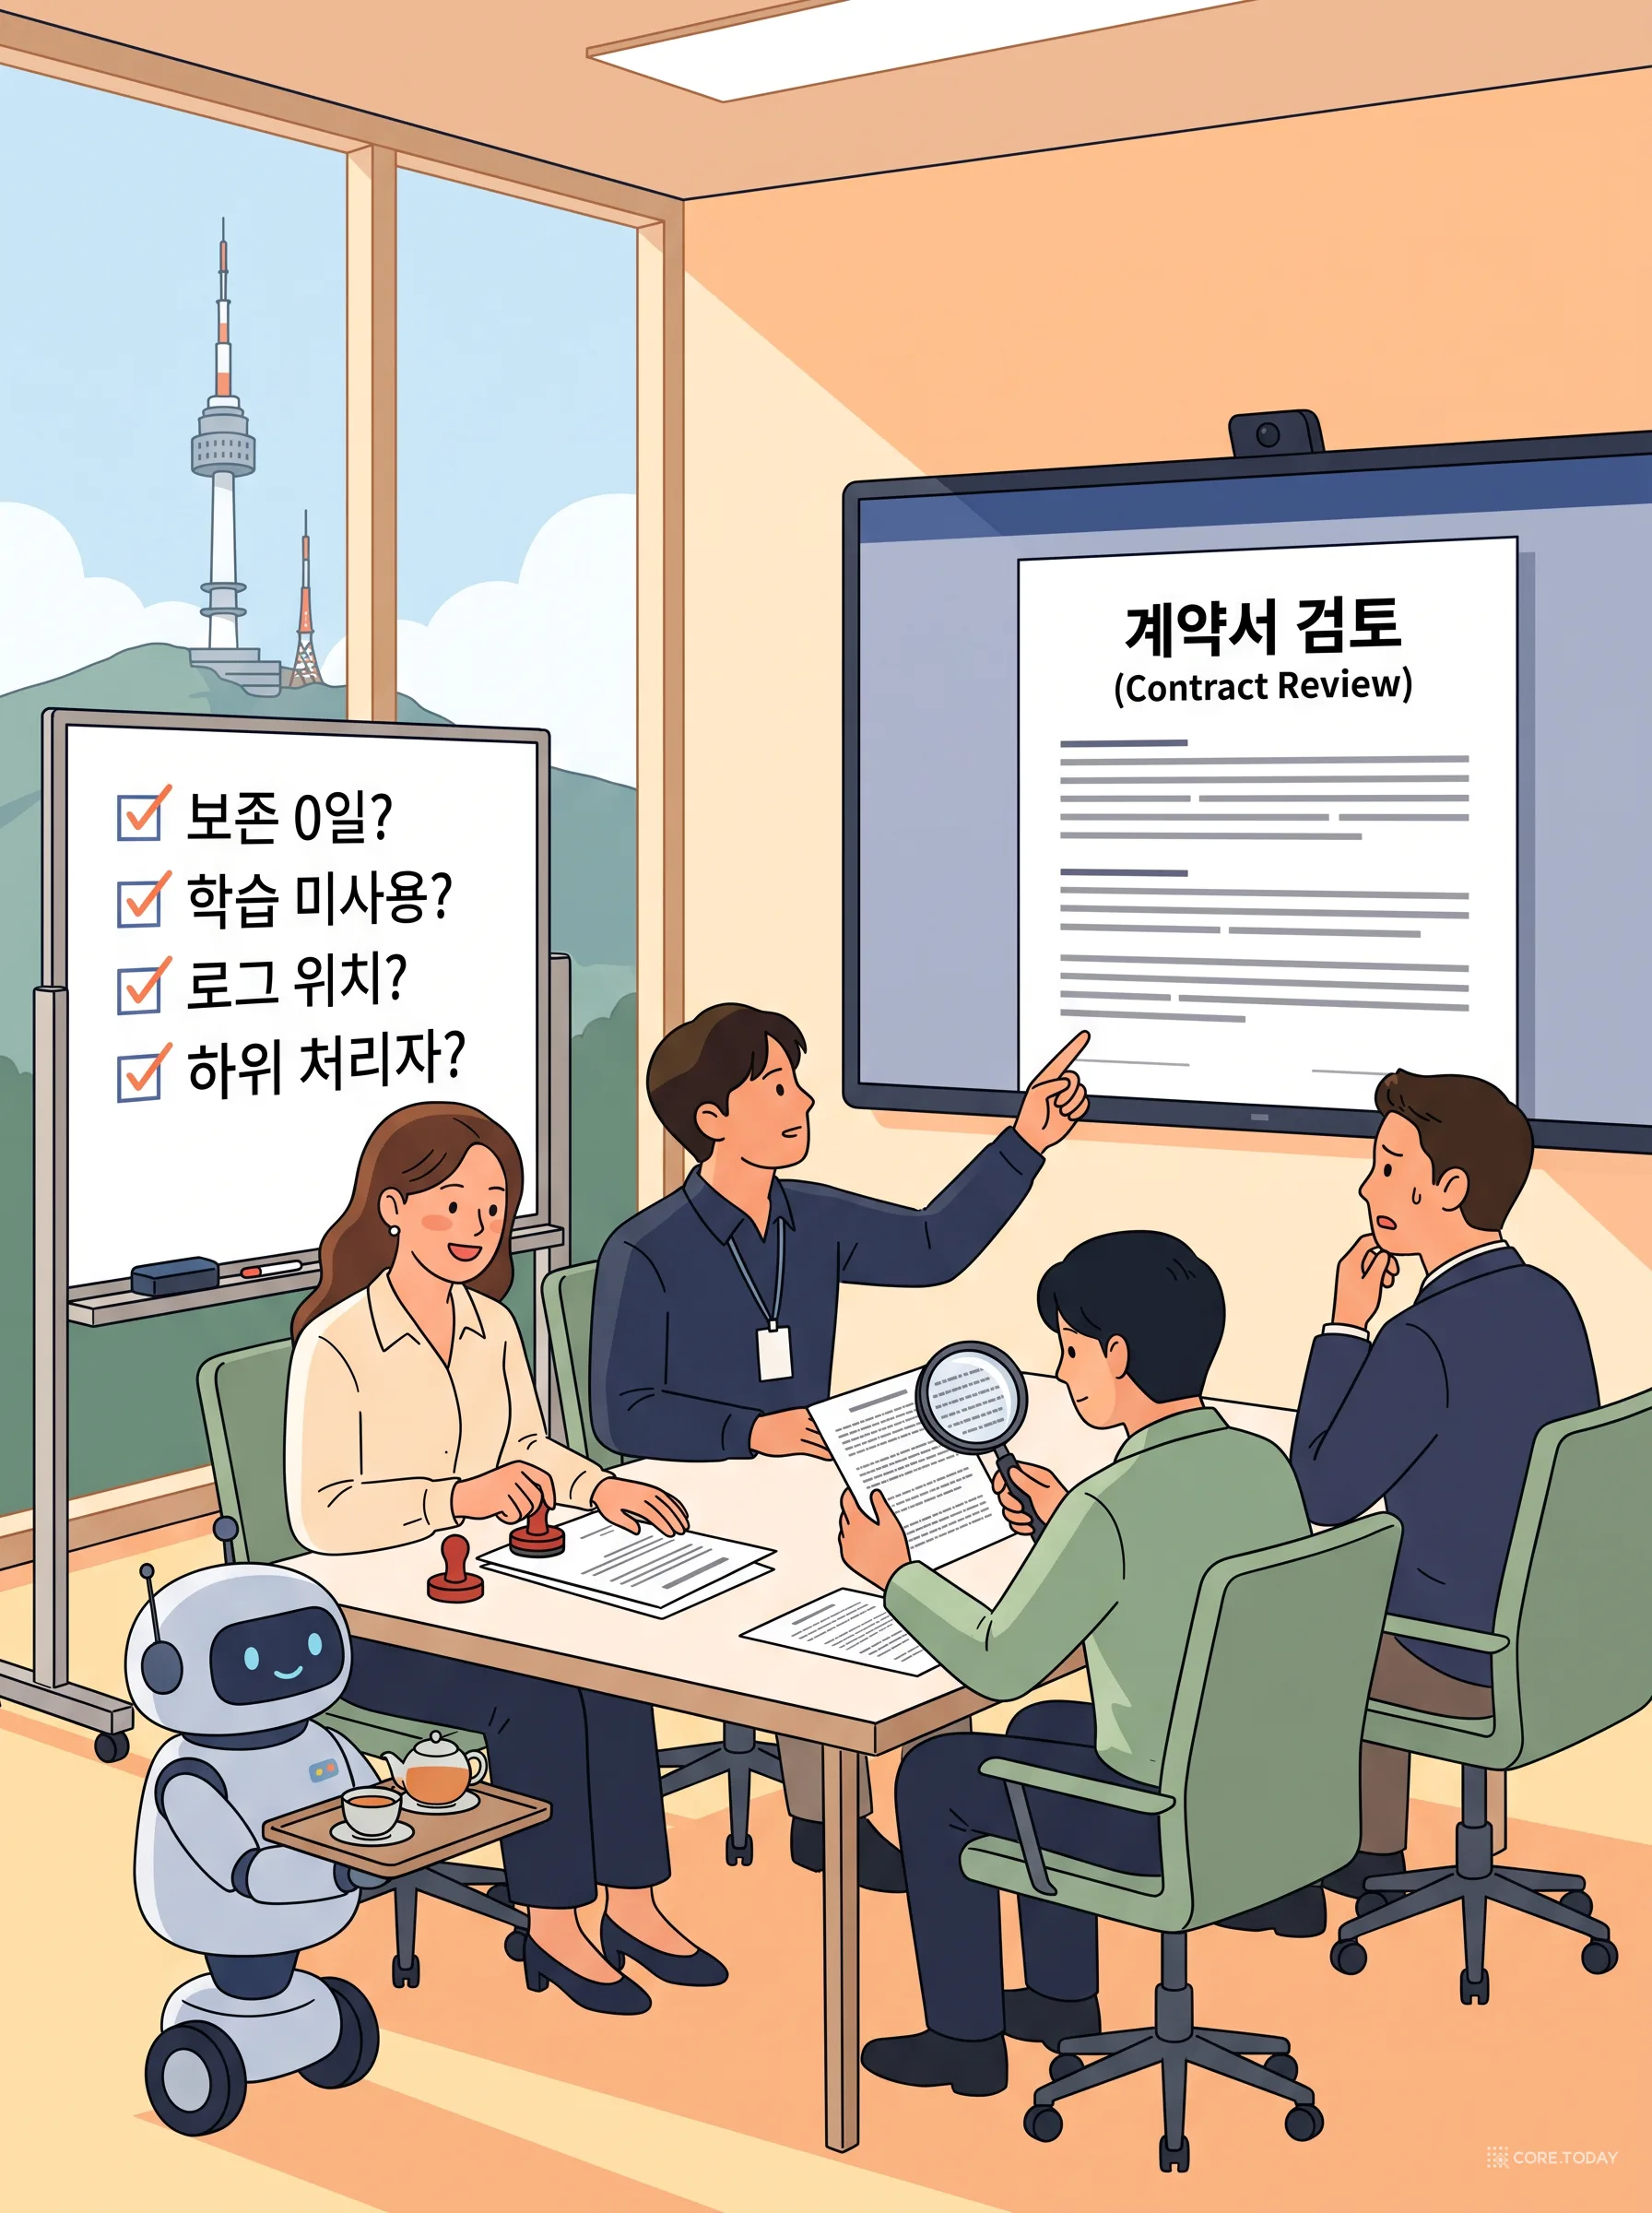
10. 한국 기업의 실무: 계약서에서 무엇을 물을 것인가
마지막으로 우리 이야기입니다. 한국 기업이 해외 AI 공급자에게 프롬프트를 보낸다는 것은 법적으로 세 가지 사건이 동시에 일어나는 일입니다. 개인정보가 포함돼 있다면 처리위탁이고, 서버가 해외에 있다면 국외 이전이며, 공급자가 보존한다면 제3자가 우리 데이터를 보관하는 것입니다.
제도적 틀은 이미 있습니다. 2023년 9월 시행된 개정 개인정보보호법은 국외 이전 요건을 정비하고 과징금을 전체 매출 기준으로 바꿨습니다. 국가정보원은 2023년 6월 「챗GPT 등 생성형 AI 활용 보안 가이드라인」을 공공기관과 대학에 배포해 비공개 정보와 개인정보 입력 금지를 원칙으로 세웠습니다. 개인정보보호위원회는 2024년 7월 공개된 개인정보의 AI 학습 활용에 관한 안내서에 이어, 2025년 8월 「생성형 AI 개발·활용을 위한 개인정보 처리 안내서」를 내놓아 모델을 만드는 쪽과 가져다 쓰는 쪽의 책임을 단계별로 나눴습니다.
① 세 축을 따로 묻는다"학습에 쓰나요?"만 묻고 끝내지 마세요. 보존 기간은 며칠인지, 그 기간 동안 누가 어떤 조건에서 열람할 수 있는지를 각각 서면으로 받으세요. 2023년 이후 '학습 미사용'은 기본값이라 변별력이 없습니다.
② 적용 범위를 모델·기능·리전 단위로 확인한다같은 공급자 안에서도 모델마다(Fable 5.1 가능, Mythos 5.1 불가), 기능마다(Chat Completions 적격, Assistants 비적격), 리전마다 다릅니다. 'ZDR 신청 가능'이 아니라 '우리 조직 ID에 적용됨'을 확인 메일이나 대시보드 표시로 받아 두세요.
③ 법적 보존 명령 시나리오를 묻는다NYT 소송 같은 상황에서 우리 데이터가 어떻게 되는지 공급자가 명시하는지 보세요. ZDR 고객이 제외된다는 문구가 있다면 그것이 ZDR의 실질적 가치입니다.
④ 우리 쪽 보존 꼬리를 자른다공급자가 0일이어도 우리 게이트웨이·로그 수집기·대화 DB가 영구 보존이면 의미가 없습니다. 프롬프트 로그의 보존 기간, 마스킹, 접근 통제를 공급자에게 요구하는 수준과 같게 맞추세요. 게이트웨이를 운영해 본 입장에서 말하자면, 과금 정산과 장애 분석을 위해 요청 본문을 남기고 싶은 유혹은 매우 큽니다. 그래서 더더욱 '무엇을, 얼마나' 남길지를 처음에 정해야 합니다.
⑤ 민감도에 따라 자체 호스팅을 계산에 넣는다포춘이 보도한 흐름처럼, 보존을 요구하는 최상위 모델 대신 ZDR이 되는 한 단계 아래 모델이나 오픈 웨이트 모델을 자체 GPU에 두는 선택이 늘고 있습니다. '가장 똑똑한 모델'과 '우리가 쓸 수 있는 모델'은 다를 수 있습니다.
아래 체크리스트는 조직의 조건을 켜면 공급자에게 물어볼 질문을 만들어 줍니다.
맺으며: 기억하지 않는 서버라는 역설
컴퓨터는 기억하려고 만든 기계입니다. 그 기계를 운영하는 회사들이 "기억하지 않겠다"를 상품으로 팔고, 고객이 그것을 가장 중요한 조건으로 요구하는 시대가 됐습니다. 20년의 이야기가 가르친 것은 결국 하나입니다. 데이터는 가지고 있는 순간부터 책임이고, 가장 싼 책임은 애초에 지지 않는 책임입니다.
AI는 이 오래된 교훈을 새로운 강도로 되살렸습니다. 프롬프트는 과거 어떤 데이터보다 솔직하고, 모델은 들어온 것을 외우며, 공급자의 로그는 공급자의 소송에 끌려 들어갑니다. 그래서 ZDR은 보안 체크박스가 아니라 AI를 어디까지 믿고 무엇을 맡길 것인가에 대한 조직의 답입니다.
2026년의 긴장은 아직 풀리지 않았습니다. 가장 강한 모델은 안전을 이유로 보존을 요구하고, 기업은 프라이버시를 이유로 보존을 거부합니다. 공급자들이 내놓은 절충안, "보존하되 고객의 금고에, 고객의 열쇠로"는 영리하지만 아직 약속의 단계입니다. 애플이 PCC로 보여 준 다음 단계, 즉 외부가 검증할 수 있는 구조까지 가야 이 논쟁은 끝날 것입니다.
그때까지 할 일은 분명합니다. 세 축을 따로 묻고, 적용 범위를 확인하고, 우리 쪽 꼬리를 자르는 것. Signal이 소환장에 종이 한 장으로 답할 수 있었던 것은 운이 좋아서가 아니라, 처음부터 그렇게 설계했기 때문입니다.
Yinzhi Cao & Junfeng Yang, Towards Making Systems Forget with Machine Unlearning (IEEE S&P 2015) · Lucas Bourtoule et al., Machine Unlearning (SISA) (IEEE S&P 2021)
Cynthia Dwork et al., Calibrating Noise to Sensitivity in Private Data Analysis (TCC 2006)
Eduard Fosch Villaronga, Peter Kieseberg & Tiffany Li, Humans forget, machines remember: Artificial intelligence and the Right to Be Forgotten (Computer Law & Security Review, 2018)