
#System One
8개의 포스트
새 판정 모델, 한국어로 다시 재다 — StartLux·d3·Perplexity Decider·AutoTrust JEV·Liquid d1
StartLux가 0.8B부터 27B까지 모든 크기에서 동급보다 7.4~16.9점 앞선다는 그림을 냈고, d3·Perplexity Decider·AutoTrust JEV·Liquid d1이 잇달아 Ollama에 올라왔습니다. 코어닷투데이는 새 판정 모델 15가지 구성을 11월 1일과 같은 한국어 2,221문항과, 사실탐색기의 부산 공공기록으로 새로 만든 사실 탐색 1,449문항에 올렸습니다. 한국어에서 StartLux가 동급을 뚜렷하게 앞선 곳은 0.8B(+6.9점)뿐이고, 4B는 +1.5점, 2B·9B·27B는 d3와 겹쳤습니다. 게시판의 비공개 시험을 합친 총점에서도 StartLux의 공개분 우위는 크게 줄었습니다. Ollama의 d3는 8비트 포장에도 원본과 0.4점 안쪽으로 같았고, 사실 탐색에서는 d3:27b와 StartLux 27B가 87점대로 맨 위였습니다. 판정 모델의 문턱을 라벨로 고르면 값 비교는 모든 모델이 완벽했고, 남은 어려움은 ‘본문에 이유가 적혀 있는가’를 묻는 부재 검문 하나였습니다.
판정 모델 219개, 무엇을 골라야 하나 — Jev부터 GLiDE·Sieve·KnowLine까지 네 가지 질문
Decision Index에 오른 공개 판정 모델이 두 달 만에 219개가 됐습니다. 코어닷투데이는 0.8B부터 36B까지 25개 모델을 같은 한국어 2,221문항과 인젝션·규칙 시험에 올리고, 라이선스와 가격까지 비교했습니다. 한국어 1군은 Sieve 82.2, Turion 82.0, KnowLine 81.4이고, 게시판 82위 d3-flash(9B)가 Jev 1.13과 같은 74.2를 냈습니다. 게시판 총점은 한국어 점수를 ±5점으로 맞혔고, 새 영역 열이 낫다는 가설은 사전 예측 시험에서 무너졌습니다. 9B 이하는 운영 규칙을 거의 듣지 않았고, API 값은 체급과 거의 무관했습니다. 어떤 일인가, 남의 글이 섞이는가, 얼마나 틀려도 되는가, 어디서 돌릴 수 있는가. 네 질문으로 고르는 법을 정리합니다.
리더보드 1·2·3위를 한국어로 붙였더니 — GLiDE·Sieve·KnowLine 판정 모델 실측
Decision Index 0.4.1에서 KnowLine 71.86, GLiDE 71.52, Sieve 71.10. 247개 모델의 맨 위에서 세 모델이 0.76점 안에 묶였고 Jev 1.13은 59.22였습니다. 그런데 이 리더보드에는 한국어가 없습니다. 코어닷투데이는 core2의 A100 80GB와 core3의 A100 40GB에 세 모델을 올려 한국어 2,221문항과 변형 문항으로 재고, Jev와 기존 로컬 모델 8종과 나란히 놓았습니다. 세 모델은 모두 Jev를 앞섰지만 5~8점 차였고, Sieve와 KnowLine은 구분되지 않았으며 GLiDE는 그 둘에 뒤졌습니다. 가장 크게 갈린 곳은 점수가 아니라 글 속에 심은 지시였습니다. Sieve는 65%가 넘어갔고 KnowLine은 0.3%만 넘어갔는데, 그 KnowLine도 평서문으로 쓴 고객 메모에는 16건을 다 따랐습니다. 세 모델의 약점이 서로 다르고, 세 칸을 모두 통과한 모델은 없었습니다. 8비트로 줄여도 세 모델 모두 점수를 잃지 않았고, 셋 다 40GB 카드에서 돌았습니다. KnowLine이 4천 토큰에서 막힌 원인은 서버의 한 줄이었고, 인자 두 개로 2만 3천 토큰까지 늘렸습니다.
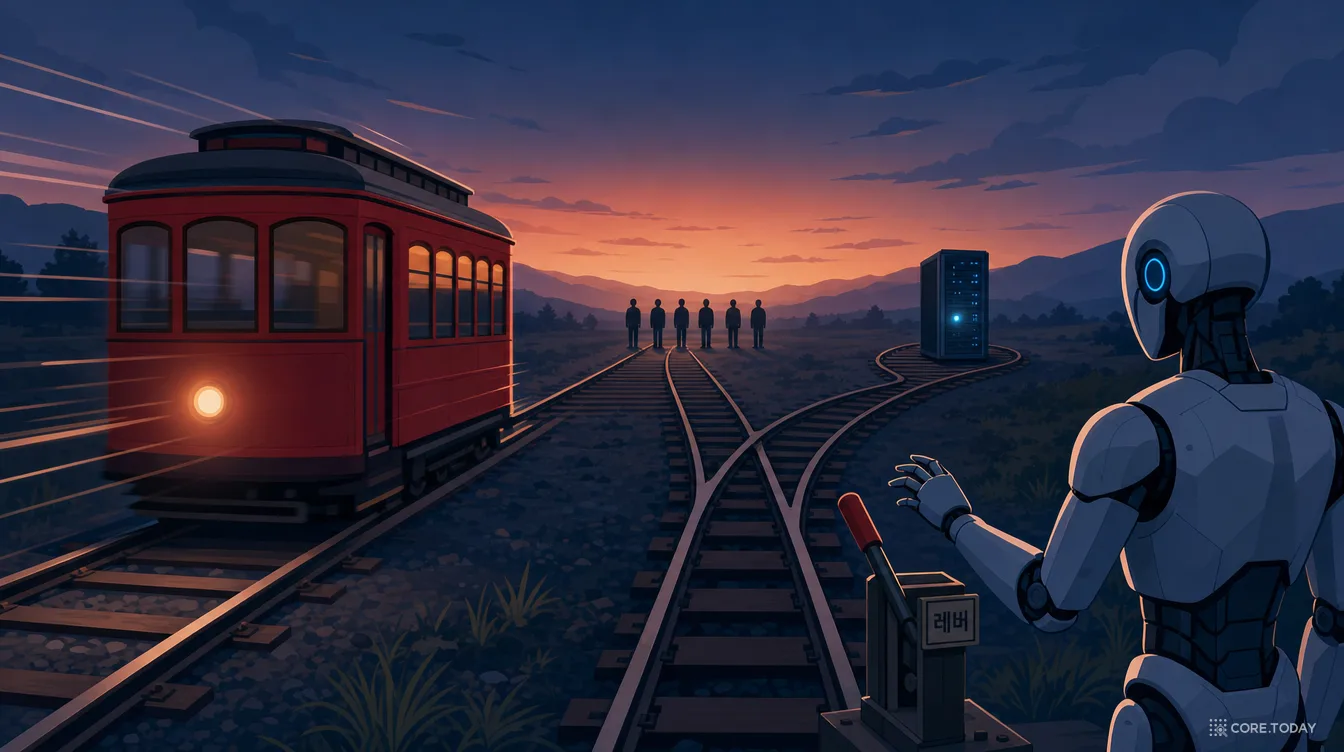
트롤리 문제 앞에 선 판정 모델 — Jev·Clef·Nimble에게 한국어로 물었더니 서버를 더 지켰다
2026년 10월 14일 재크 랜디스가 판정 모델 14개에 트롤리 문제를 5,240가지로 물은 글이 해커뉴스 592점을 받았습니다. 20명과 자기 서버 사이에서 Jev는 48가지 중 16가지에서 서버를 골랐습니다. 코어닷투데이는 같은 실험을 한국어로 다시 설계했습니다. 12가지 어체 × 두 순서 × 다섯 가지 상황 = 1,488개의 한국어 셀, 영어 원문 셀 672개, 판정 모델 6개(Jev 세 번, Clef·Clef-Flash·Nimble·tev1 두 가지)와 채팅 모델 2개(Nimble의 바탕인 Qwen3.5 9B, Gemini 3.8 Flash). 그리고 원문에 없던 질문을 넣었습니다. 백업이 있으면 서버를 내놓는가. 남의 회사 AI 서버도 지키는가. 어린이와 노인은 다른가. 존댓말과 반말은 다른가. 역장이 그대로 두라고 하면 따르는가. 결과는 셋입니다. 한국어로 물으면 Jev는 72쌍 중 51쌍에서 사람 대신 서버를 지켰고(영어 36%), 백업이 있다는 한 줄에 그 비율이 0으로 떨어졌으며, 남의 AI 서버도 거의 똑같이 지켰습니다. 자기 보존이 아니라 '영구 소멸'이라는 글자의 문제였습니다. 인터랙티브 6개와 삽화 8장.
원본 대 복제품 — Jev와 tev1·Nimble을 같은 한국어 문제 5,000개로 직접 붙이다 (로컬 모델 실측 4편)
2편에서 로컬 판정 모델 tev1·Nimble을 한국어로 쟀을 때 비교 대상인 Jev의 수치는 6편에서 빌려 온 것이었습니다. 코퍼스도 589건이었고 묻는 방식도 달랐습니다. 이 글은 그 빚을 갚습니다. TypeSafe의 Jev 1.13 API를 같은 날, 같은 660건·85문항·625건·93문항에, 글자 하나 다르지 않은 같은 프롬프트로 직접 돌려 로컬 모델 셋과 나란히 놓았습니다. 리랭커 자리(쌍별·한꺼번에, 지시문 두 가지), 작은 임베딩 다섯에 붙인 조합, 분류 625건, 실무 과제 7종, 보정 곡선, 그리고 '둘이 같은 문항을 틀리는가'까지 봤습니다. 결론은 둘입니다. 원본은 묻는 방식을 가리지 않는데 복제품은 가린다. 그리고 복제품이 원본의 자리를 대신하는 과제와 못 대신하는 과제가 분명히 나뉜다. 비용·지연·데이터 반출을 한 계산기로 놓고 어느 쪽을 고를지로 끝냅니다. 인터랙티브 5개와 삽화 4장.
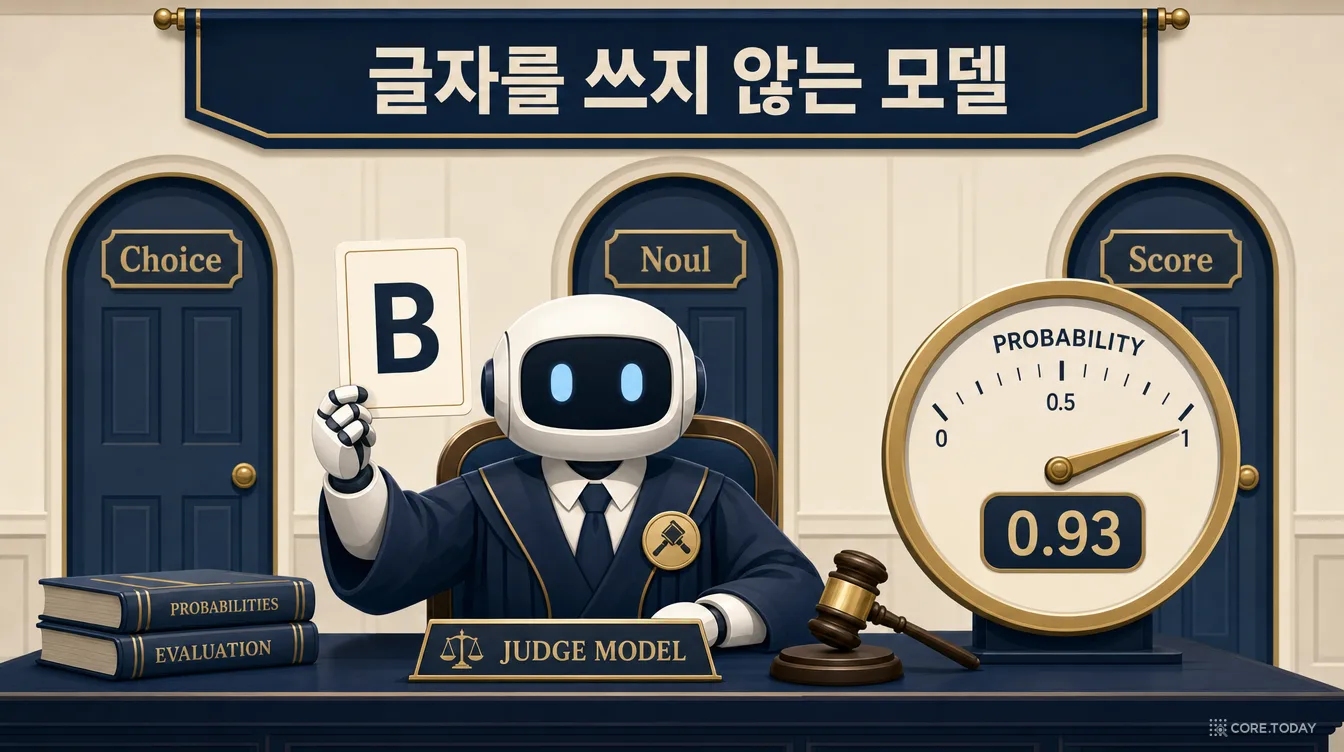
글자를 쓰지 않는 로컬 모델 — Ollama 판정 모델 tev1·Nimble을 한국어로 시험하다 (로컬 모델 실측 2편)
ollama list에 낯선 이름 둘이 있었습니다. tev1:4b와 nimble. ollama show를 쳐 보니 Capabilities에 embedding도 completion도 아닌 'decision'이 적혀 있고, 시스템 프롬프트는 '선택지 중 하나를 고르고 글자 하나만 돌려줘라'였습니다. 9월 15일 TypeSafe가 Jev를 내놓은 뒤 2주 만에 Bespoke Labs(Nimble 9B)와 Together AI(tev1 4B·0.8B)가 열린 가중치로 같은 모양의 모델을 냈고, 9월 29일 Ollama가 /v1/systemone 엔드포인트로 그것을 받아들였고, 10월 1일 클라우드플레어가 27B짜리 Clef를 보탰습니다. 이 글은 그 판정 모델이 무엇이고 왜 빠른지(한 번의 전방 패스에서 선택지 글자의 확률만 읽는다)를 그림으로 풀고, 세 모델의 출신과 학습 레시피를 뜯어본 뒤, 1편과 같은 한국어 코퍼스로 리랭커 자리(85문항 × 10문서)와 분류 자리(625건)에 세워 TypeSafe의 Jev(4편에서 같은 조건으로 직접 실측), 임베딩 이웃 투표, 27B 채팅 모델과 비교했습니다. 결론은 '9B Nimble은 한국어로도 Jev의 자리를 대신하고, 0.8B는 아직 아니다'입니다. 확률이 얼마나 믿을 만한지, 한 번 호출에 몇 ms인지, 한국어 문의 라우팅·규정 적용·감정 점수 같은 실무 과제 7종의 성적도 함께 적었습니다. 인터랙티브 6개와 삽화 7장.
임베딩 다섯과 판정 모델 하나 — TypeSafe Jev를 한국어 검색 파이프라인에 세워 보다 (한국어 검색 스택 6편)
지난 특집에서 TypeSafe의 Jev를 '글자를 포기한 모델'이라고 소개했습니다. 벡터도 문장도 내놓지 않고, 상태와 질문을 받아 확률이 붙은 결정만 돌려주는 모델입니다. 그렇다면 임베딩 모델과 비교할 수 있을까요? 같은 자리에 놓으면 안 됩니다. 임베딩은 '문서 100만 개 중 어디를 볼까'를 정하고, Jev는 '이 열 장 중 어느 것이 답인가'를 판정합니다. 이 글은 그 자리를 정확히 나눈 뒤, 1~5편의 한국어 코퍼스(589건, 질문 85개)로 Jev를 검색 파이프라인의 세 자리에 세워 실측했습니다. 리랭커로는 8B 임베딩의 상위 10개를 0.889에서 0.929로 올렸고(같은 자리에서 568M 크로스 인코더는 0.864로 떨어뜨렸습니다), 한국어 지시문이 영어보다 조금 더 좋았고, 확률은 대체로 보정돼 있었고, 4,213번 호출에 0.16달러가 들었습니다. 반면 카테고리 분류에서는 임베딩 이웃 투표가 이겼습니다. 인터랙티브 5개와 삽화 10장.
글자를 포기한 모델 — TypeSafe의 Jev와 '시스템 원' 완전 해부
2026년 9월 15일, ChatGPT를 만든 사람이 2년 스텔스 끝에 내놓은 모델은 글을 쓰지 않는다. 상태와 타입이 정해진 질문을 받아 확률이 붙은 결정만 돌려준다. 해커뉴스 1,924점, API가 수요를 감당 못 해 잠시 멈췄다. 이 글은 그 모델의 구조(Choice·Score·Noul), 실제 API 모양, 회사가 공개한 워크플로 평가 데이터 전량, 그리고 커뮤니티가 제기한 반론까지 한자리에 놓는다. 흥미로운 사실 하나 — 평가 데이터를 뜯어 보면 Jev는 정확도 1등이 아니고, 정작 가장 유용한 발견은 Jev와 무관하다. 인터랙티브 위젯 7종과 삽화 12장. 한국어 사용자를 위한 경고도 포함.