
#Claude
15개의 포스트
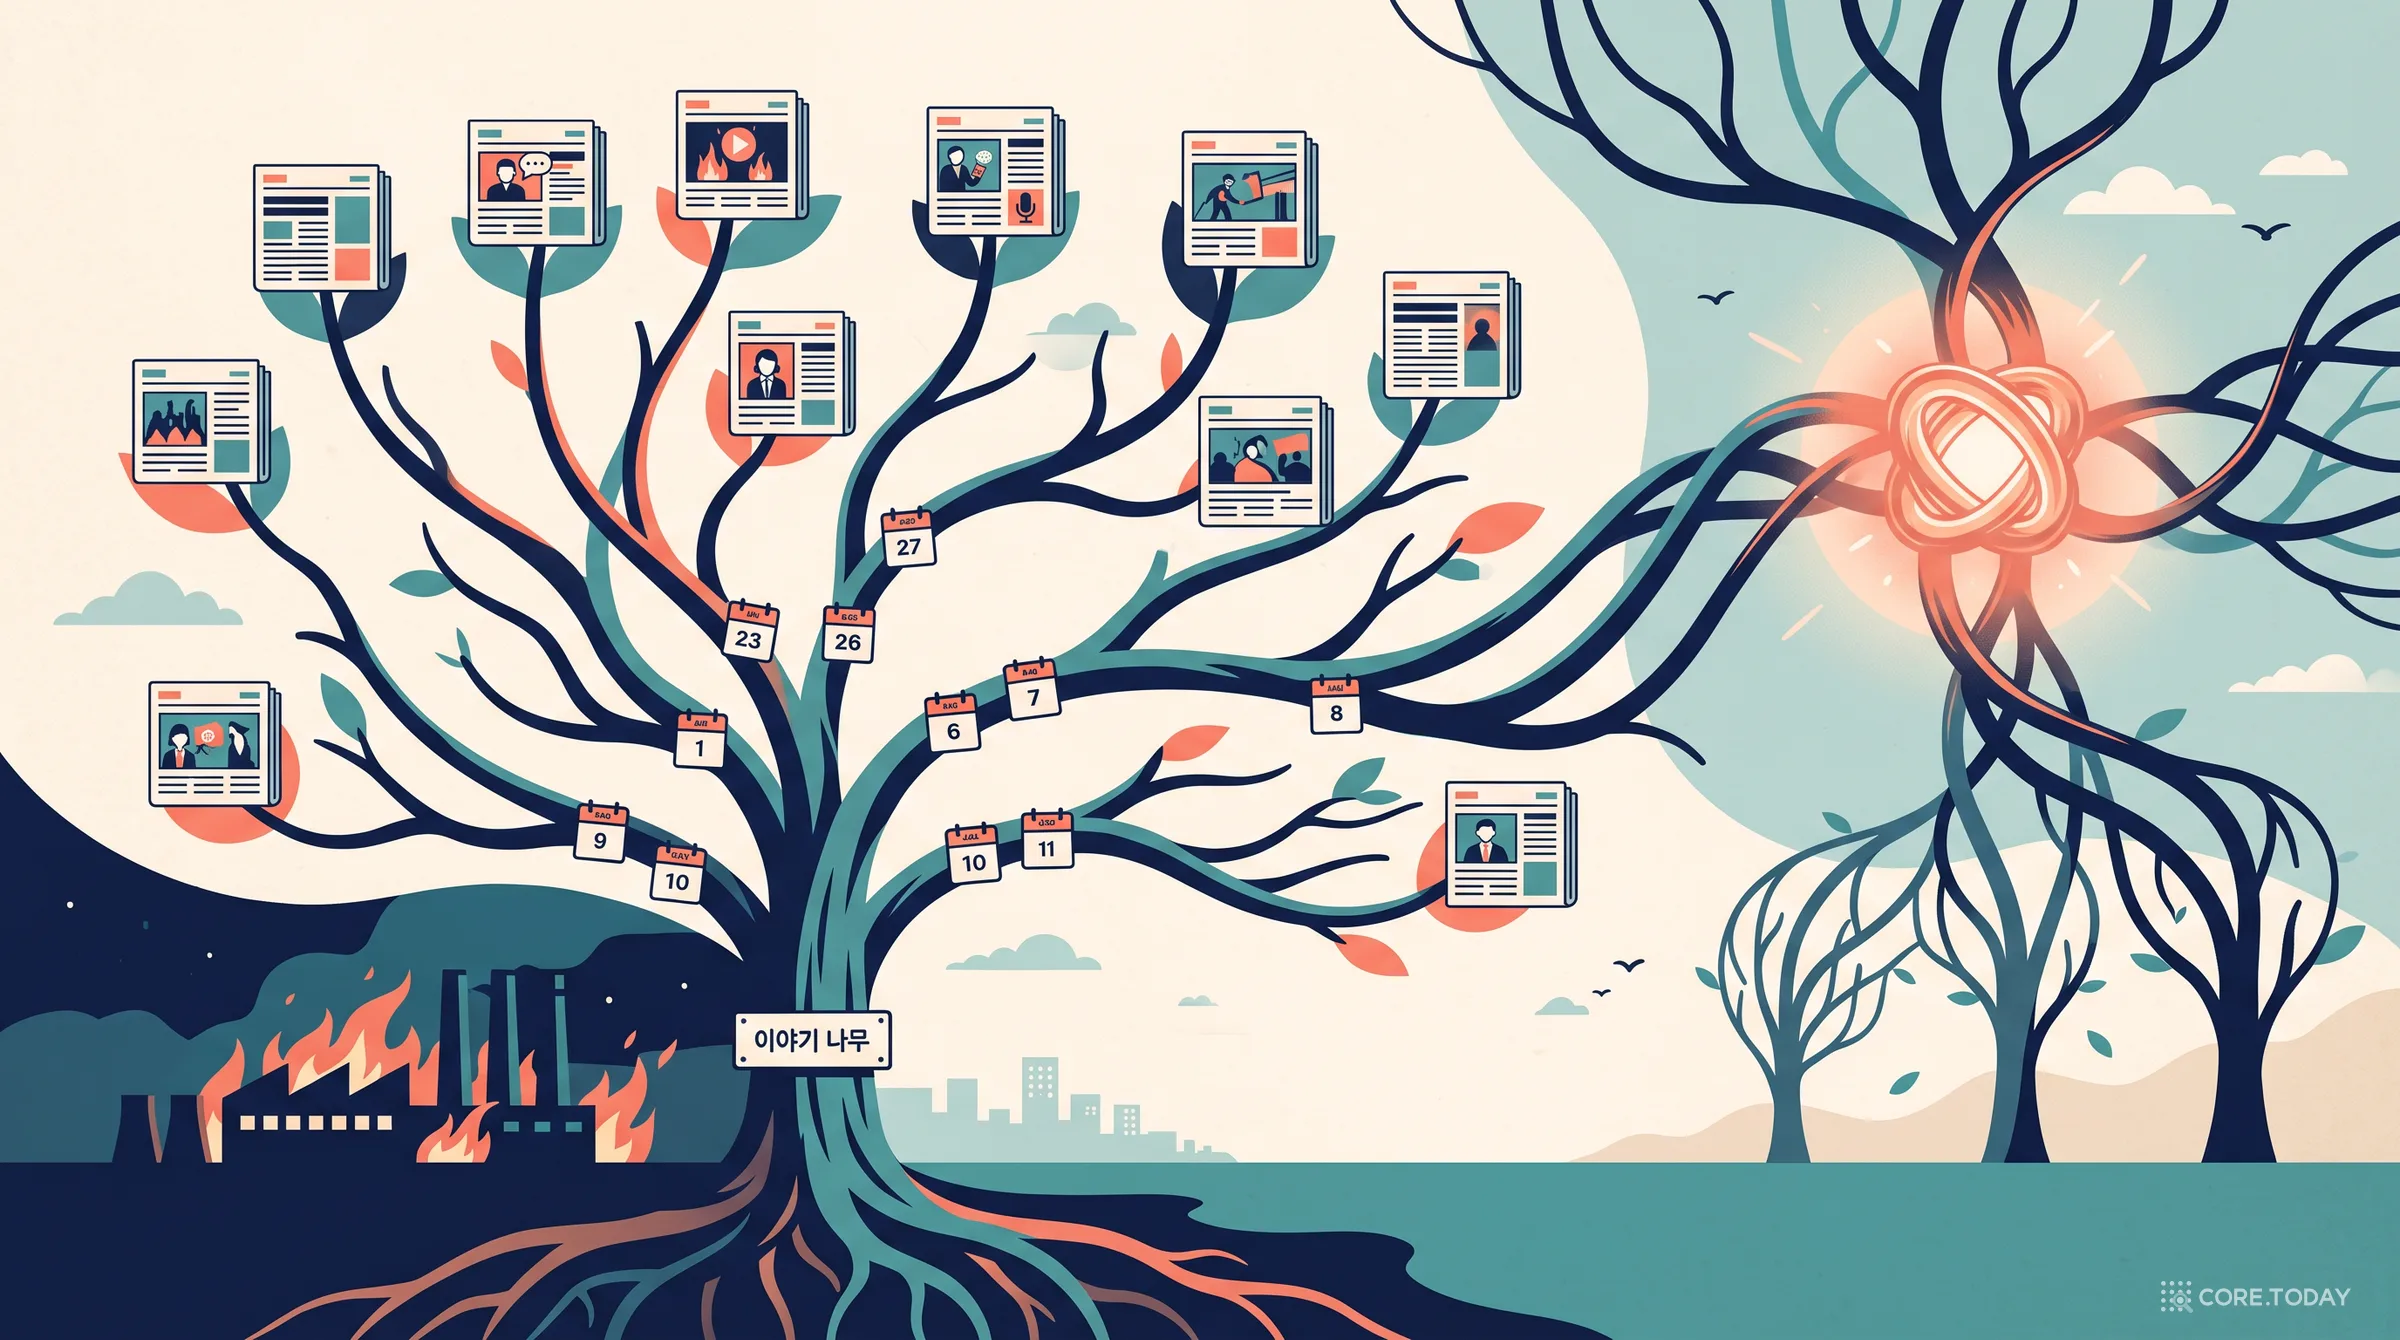
같은 사건 묶기 4편 — 여드레치 1만 건, 이야기를 사슬이 아니라 나무로 세울 수 있는가
3편은 '같은 이야기'가 쌍으로는 쉽고 성분으로는 불가능하다는 데서 끝났습니다. 4편은 13개 언론사의 여드레치 정치·사회 기사 10,000건으로 그 다음을 실측했습니다. 같은 사건 묶음을 '단계'로 다시 쪼개고, 단계 사이에 후속·형제·참조 간선 정답 16,734개를 세 판사로 만들고, 어떤 점수가 다음 단계의 부모를 찾는지 쟀습니다. 결론은 뜻밖이었습니다. 정답 나무도 나무가 아니라 그물이었고, 그래서 이야기의 단위는 성분이 아니라 '부모 하나'여야 했습니다.
[특집] Claude 모양 과학 2부 — 숲 밖의 35편: 1,000자리 숫자로 푼 입자 적분, 경제학 논문 4,452편 검산, 6,072개 언어의 강세, 1939년 와트슨의 '마지막 문제'까지
하버드 물리학자 매튜 슈워츠가 Claude와 3개월 동안 쓴 원고 36편 중 숲을 뺀 나머지를 하나씩 연다. 1,000자리 숫자에서 정확한 공식을 되찾는 입자 적분, 반올림 오차에 갇혀 있던 희귀 돌연변이 공식과 57억 쌍의 유전자 전환, 경제학 논문 4,452편을 다시 돌린 'AI 데이터 편집자', 정확한 분수가 된 진화 나무, 6,072개 언어의 강세 카탈로그, 87년 만에 풀린 3차원 무작위 보행, 늙는 흑점과 늙지 않는 별점까지. 그리고 이 모든 것을 굴린 작업 규약과, 그 성과를 얼마나 믿어도 되는지를 함께 따진다.
[특집] 숲 방정식 — 하버드 물리학자와 Claude가 20년 묵은 생태학 공식을 끝까지 계산하자 벌어진 일: 'Claude 모양 과학' 해부
하버드 물리학자 매튜 슈워츠가 Claude와 함께 만든 도구 상자 BootLoops로 생태학의 중립 이론 공식(에티엔 2005)을 23만 그루 규모로 정확히 풀었다. 그러자 파나마 숲이 우연보다 4배 넘게 빨리 변한다는 숫자가 나왔다. 그러나 생태학자는 어깨를 으쓱했다. 허벨의 빈자리 추첨부터 스털링 수의 숫자 폭발, '중립을 빼고 나머지를 보라'는 전환, 미국 숲 지도, 36편의 원고와 실패 목록까지 'Claude 모양 과학'의 실체를 해부한다.
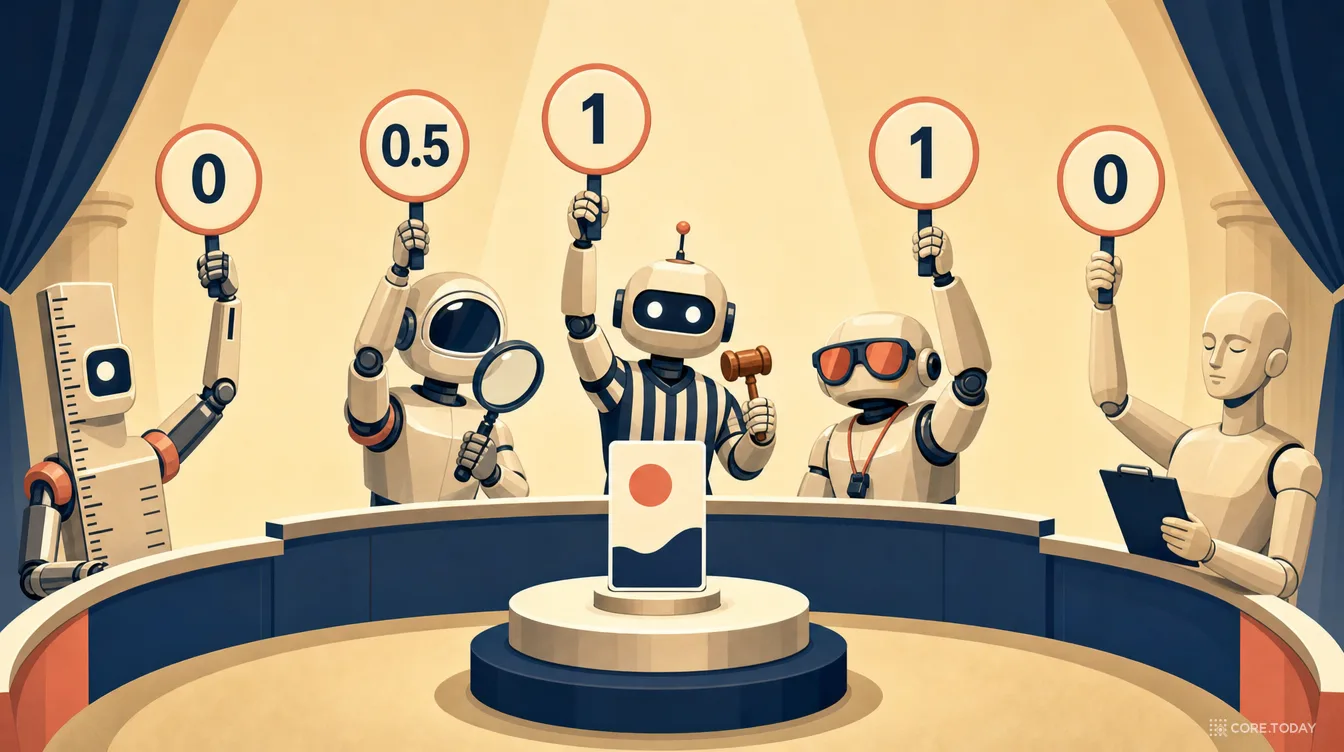
채점이 순위를 바꾸는가 — 육하원칙 답 2,371개를 판사 여섯에게 다시 채점시키다
지난 글은 뉴스 72건에서 육하원칙을 꺼내는 24가지 방법을 글자 F1로 줄 세웠습니다. 그런데 그 자는 '50대 남성'과 'A(59)씨'를, '이날'과 '13일'을 다른 답으로 셉니다. 이번에는 같은 답 2,371개를 자 세 개(글자 F1·포함 일치·날짜 정규화)와 판사 여섯(Gemini 3.8 Flash·Claude Sonnet 5.5·GPT-5.4 mini·로컬 Qwen3.5 9B·Jev·로컬 Clef-Flash)에게 다시 채점시키고, 층화 표본 234개를 원문과 대조해 검수했습니다. 결과는 세 줄입니다. 강한 판사들로 바꿔도 방법의 순위는 거의 그대로였습니다(켄달 순위 상관 0.96~0.99). 대신 점수의 크기가 바뀌었고, 특히 '무엇을'에서 작은 모델이 0.15를 되찾았습니다. 그리고 판사에게는 버릇이 있었습니다. 같은 가족의 답을 후하게 주고, 검수자보다 엄격하며, 로컬 판사는 순위를 흔들었습니다. 판사 둘 이상이 정답을 의심한 칸은 다시 보니 모두 정답 쪽이 지나치게 엄격했습니다. 순위 기울기·검수 일치도·칸별 법정·자기 선호·칸별 회복 위젯 5개와 삽화 5장.
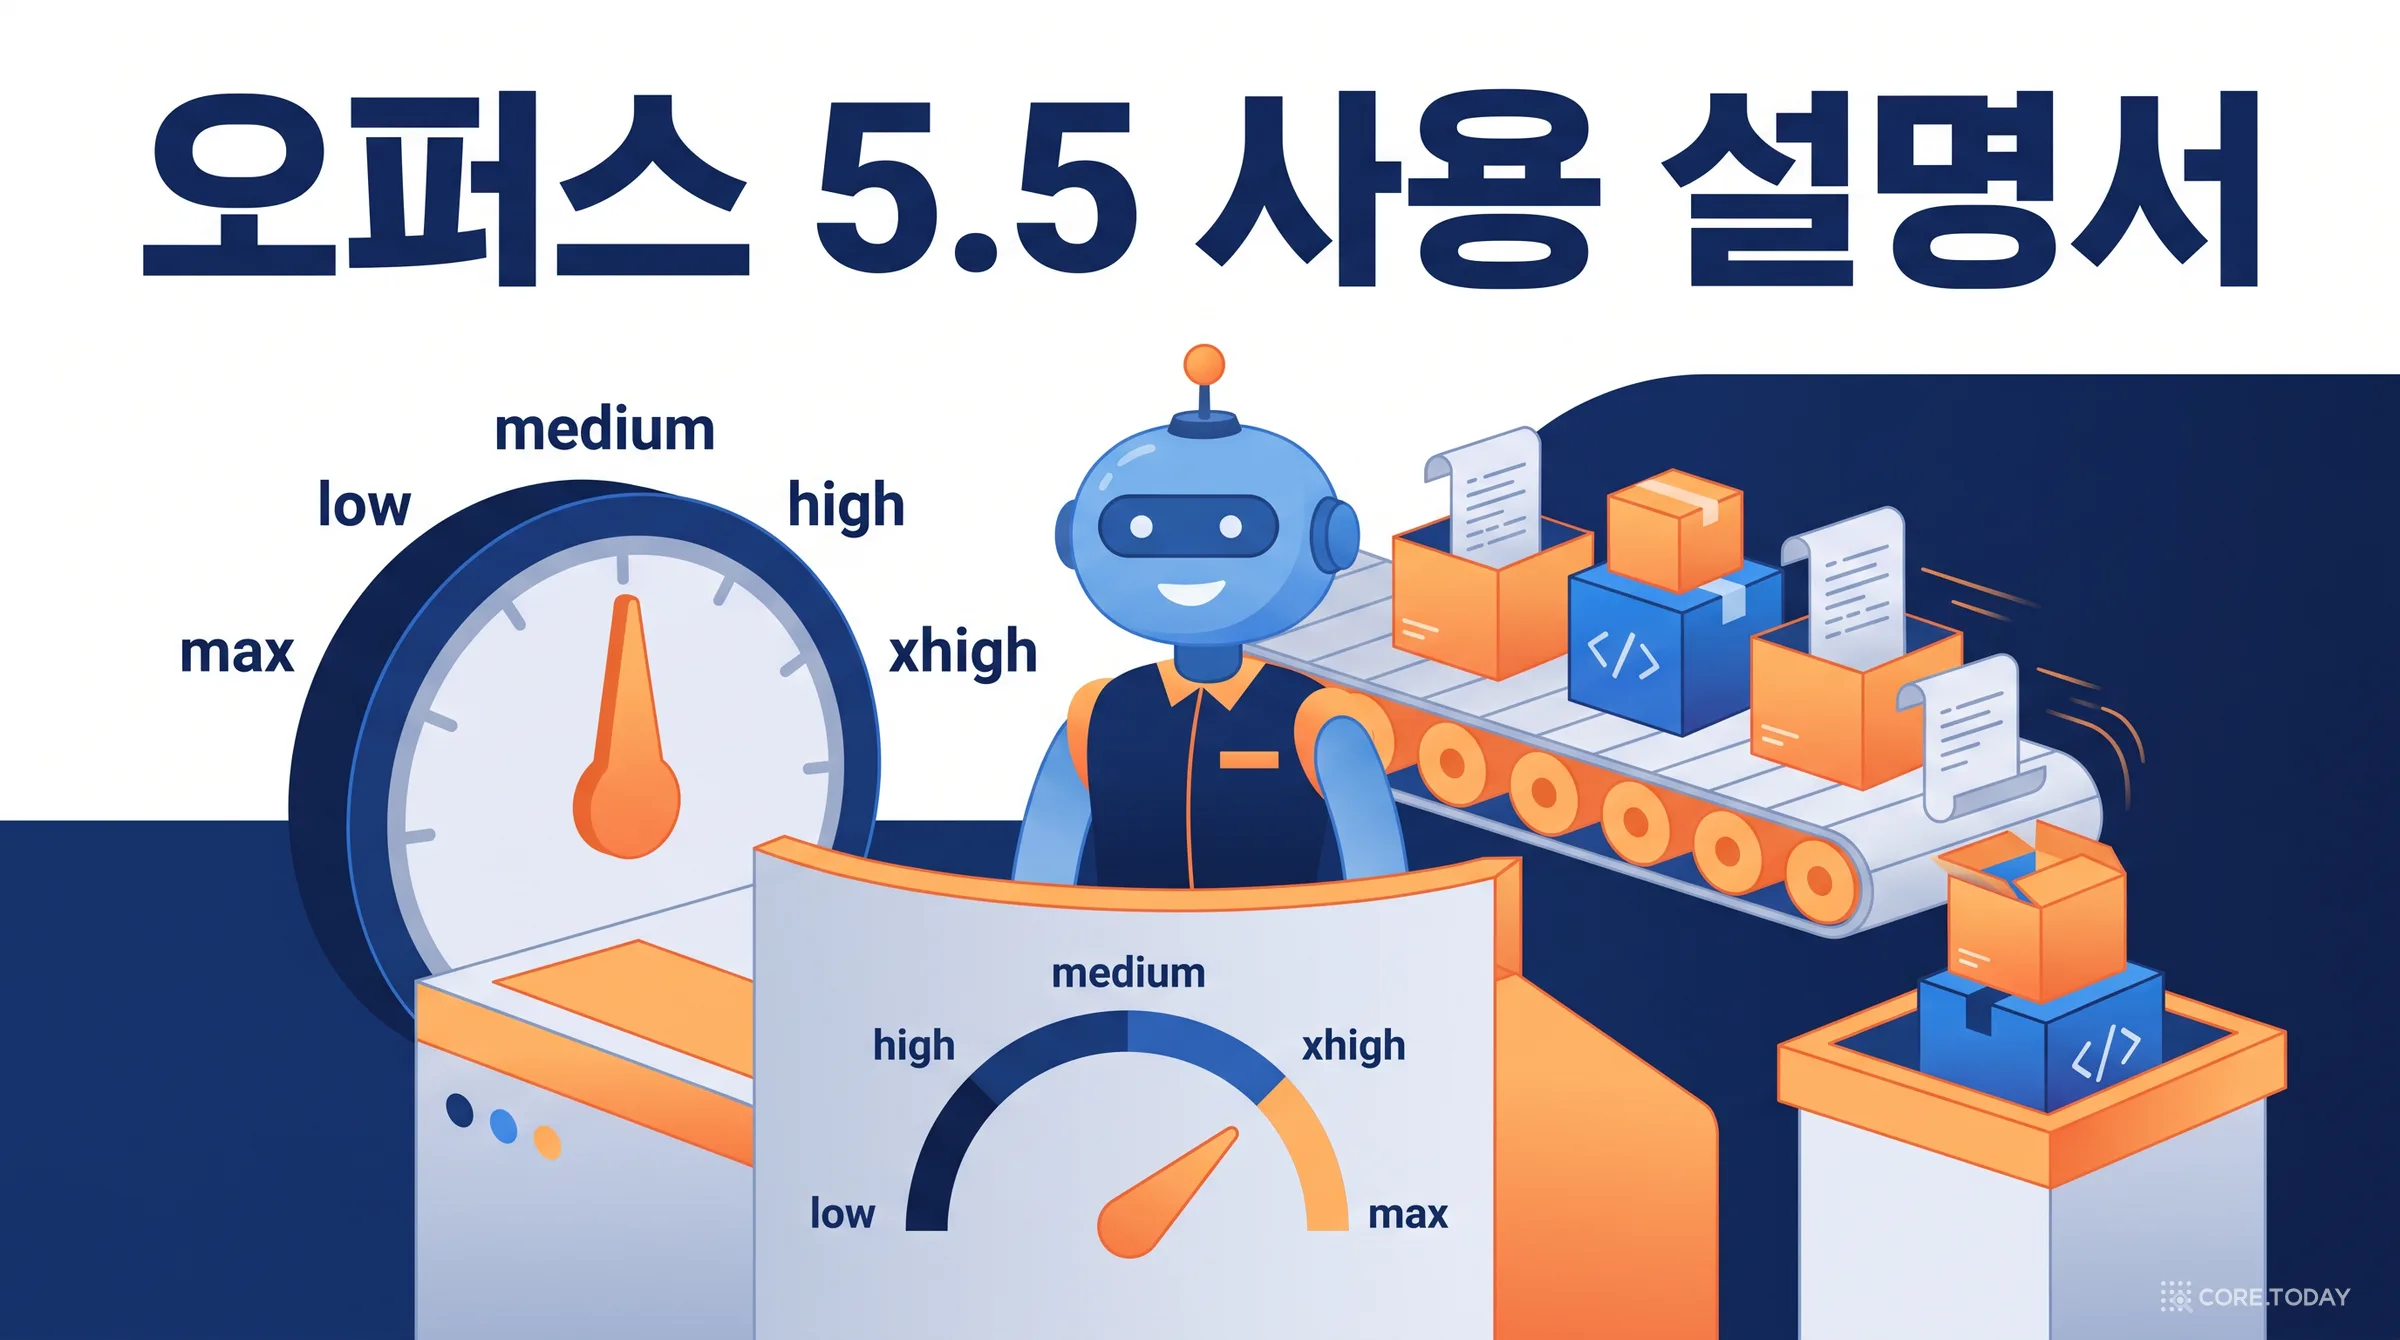
Claude Opus 5.5 사용 설명서 — 생각은 끌 수 없고, 손잡이는 effort 하나다
2026년 9월 22일 공개된 Claude Opus 5.5는 Fable 5.1급 성능을 Opus 5보다 20% 싼 값에 내고, 출력은 30% 넘게 빠릅니다. 그런데 Opus 5에서 잘 돌던 코드가 그대로 400 에러를 내거나, 에러 없이 화면만 조용해질 수 있습니다. 생각은 끌 수 없고, 기본 effort는 high에서 medium으로 내려갔고, 도구 호출 사이의 진행 메모는 thinking 블록으로 옵니다. Anthropic이 공개한 Opus 5.5 프롬프팅 가이드와 마이그레이션·effort·비용 문서를 모두 읽고, 이전 모델과 무엇이 다른지, 예시 프롬프트 14개를 원문과 한국어로, 그리고 Haiku·Sonnet·Opus·Fable 중 언제 무엇을 어떤 effort로 쓸지 정리했습니다. SWE-bench Pro 부분집합에서 Opus 5.5 medium은 Fable 5.1 기본값과 같은 정답률을 약 1/5 비용에 냈습니다. 인터랙티브 5개와 삽화 8장.
2026년형 ChatGPT 질문법 — '역할·목표·상황·결과·질문' 5요소는 어떻게 바뀌어야 하는가
‘당신은 세계 최고의 마케팅 전문가입니다’로 시작하던 프롬프트는 이제 힘을 잃었다. 2026년의 모델은 스스로 추론하고, 도구를 쓰고, 이미지와 문서를 함께 읽는다. 그래서 좋은 프롬프트의 모양도 ‘역할극 대본’에서 ‘작업 명세서’로 옮겨 갔다. 이 글은 오래 쓰인 5요소 구조(역할·목표·상황·예상 결과·질문 유도)를 OpenAI·Anthropic·Google의 최신 가이드에 비추어 하나씩 다시 쓰고, 8+1 구조와 상황별 템플릿, 그리고 같은 요청을 옛날식과 2026년식으로 나란히 고쳐 쓴 예시를 제공한다. 마지막에는 버려도 되는 여섯 가지 옛 습관을 정리한다.
에이전트를 만들지 말고 스킬을 만들라 — 앤트로픽 「Agent Skills」 완전 해부: 업무 매뉴얼로 범용 에이전트를 전문가로 만드는 법
"300 IQ 수학 천재와 15년 경력 세무사 중 누구에게 세금 신고를 맡기겠습니까?" 앤트로픽에서 Agent Skills를 만든 배리 장과 마헤시 무라그는 2025년 11월 뉴욕 무대에서 이 질문으로 발표를 시작했다. 제목은 「에이전트를 만들지 말고 스킬을 만들라」. 업무마다 전용 에이전트를 새로 설계하는 대신, 범용 에이전트가 필요할 때 꺼내 읽는 업무 안내서, 즉 폴더 하나를 만들라는 주장이다. 이 특집은 16분짜리 발표 전문과 그 바탕이 된 엔지니어링 글, 오픈 스탠다드 사양, 저작 가이드를 처음부터 끝까지 읽고, 스킬이 긴 프롬프트와 어떻게 다른지, 왜 파일과 폴더인지, 점진적 공개가 컨텍스트 창을 어떻게 지키는지, 그리고 2026년 2월 드러난 공급망 위험까지 따진다. 마지막에는 견적 업무 매뉴얼을 스킬로 바꾸는 절차를 위젯으로 직접 해 본다. 인터랙티브 위젯 7종과 삽화를 함께 싣는다.
페르마의 마지막 정리, AI가 11일 만에 '형식 증명'하다 — 350년의 여백, 1,300만 줄의 Lean, 그리고 수학 검증의 미래
2026년 9월 4일 Anthropic이 '컴퓨터가 검증한 최초의 페르마의 마지막 정리 증명'을 공개했다. Claude 에이전트 수십 개가 11일 동안 1,300만 줄의 Lean 코드를 쓰고 29,511개의 중간 정리를 증명했다. 1637년의 여백에서 1995년 와일스의 129쪽, 그리고 2026년의 의존 그래프까지 — 왜 '증명을 검증하는 일'이 이렇게 어려웠는지, 형식화가 무엇인지, Prove2Me 아키텍처가 어떻게 수십 개 에이전트를 협업시켰는지, 그리고 이 증명이 정직하게 무엇을 못 했는지까지 사례와 그림으로 풀어본다.
버그를 찾겠다는 착각: 코드 리뷰의 진짜 목적, 1976에서 2026까지
한 수학자의 마스토돈 글 한 줄이 개발자 타임라인을 뒤흔들었다. '코드 리뷰의 목적은 버그를 찾는 게 아니다. 유지보수하기 어려운 코드를 찾는 것이다.' 왜 이 말이 375점짜리 논쟁이 됐을까? 1971년 와인버그의 '에고 없는 프로그래밍', 1976년 Fagan 인스펙션, 그리고 2013년 마이크로소프트가 570개 리뷰 코멘트를 직접 세어 밝혀낸 충격적 반전 — '기대 1위는 버그였지만, 실제 코멘트의 14%만이 버그였다'. 여기에 2026년, AI가 버그를 잡기 시작하면서 사람의 역할이 어디로 이동하는지까지. 용어가 생소해도 그림과 사례로 끝까지 쉽게 읽는 특집.
비밀은 모델이 아니라 마크다운이었다 — Anthropic은 어떻게 데이터 분석의 95%를 Claude에게 맡겼나
Anthropic이 사내 비즈니스 분석 쿼리의 95%를 Claude로 자동화하고 정확도 ~95%를 달성한 방법을 공개했다. 스킬 없이는 21%였던 정확도가 어떻게 95~99%가 되었는가 — 60년 Text-to-SQL의 역사, 30년 셀프서비스 BI의 좌절부터 4계층 에이전틱 분석 스택, ablation 방법론, 업계 비교, 실무 적용 가이드까지 완전 해부한다.
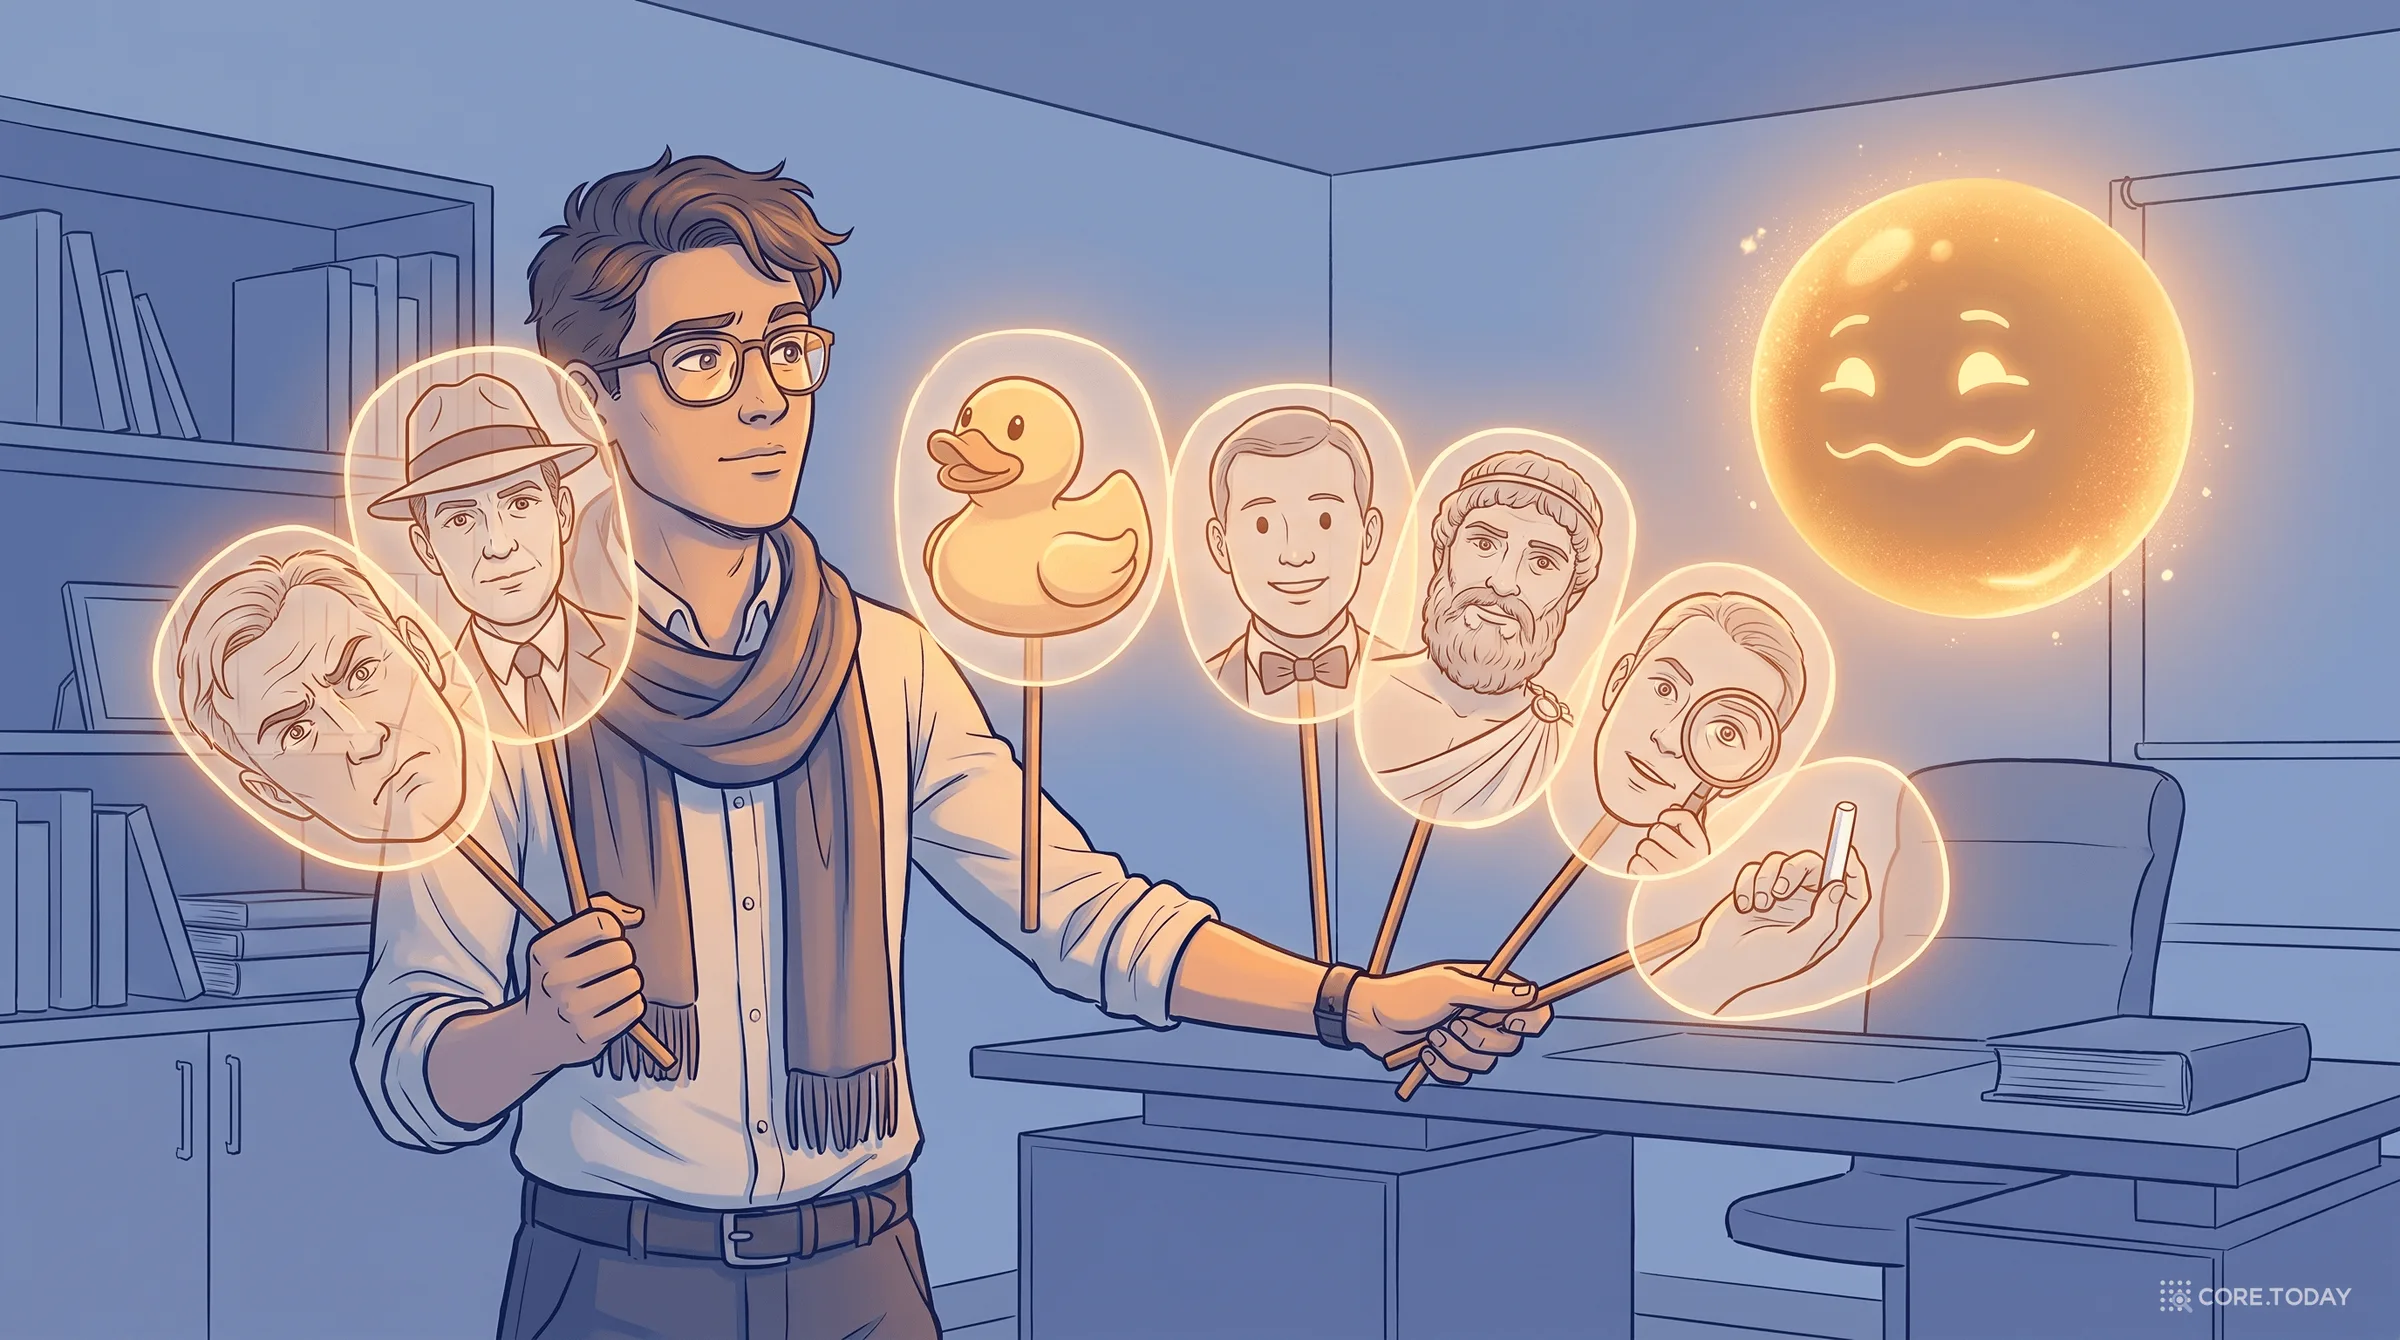
LLM을 검색창이 아닌 인지 파트너로 — 7가지 비전통적 사용법의 과학
KDnuggets의 Iván Palomares Carrascosa가 제안한 'LLM 7가지 비전통적 사용법'이 커뮤니티를 흔들고 있다. 그러나 이 7가지가 실제로 '왜' 작동하는지는 뜻밖에 깊은 배경 위에 서 있다. Anthropic의 아첨(sycophancy) 논문, USC의 페르소나 프롬프팅 연구(PRISM), 1999년 러버덕 디버깅의 기원, 2022년 Chain-of-Thought의 발견까지. 각 사용법의 프롬프트 템플릿, 작동 원리, 반대 논문, 그리고 실무 베스트 케이스를 깊이 있게 해부한다.
Meta Muse Spark 특집: LLaMA의 좌절에서 Muse의 비상까지 — Meta AI 대반격의 모든 것
LLaMA 4의 벤치마크 조작 스캔들로 무너진 Meta가 어떻게 9개월 만에 프론티어 AI 모델 Muse Spark으로 돌아왔는가. LLaMA 1부터 Muse까지의 전체 여정, 핵심 기술, 벤치마크 분석, 그리고 멀티모달 AI의 미래를 총정리합니다.