
#ChatGPT
7개의 포스트
2026년형 ChatGPT 질문법 — '역할·목표·상황·결과·질문' 5요소는 어떻게 바뀌어야 하는가
‘당신은 세계 최고의 마케팅 전문가입니다’로 시작하던 프롬프트는 이제 힘을 잃었다. 2026년의 모델은 스스로 추론하고, 도구를 쓰고, 이미지와 문서를 함께 읽는다. 그래서 좋은 프롬프트의 모양도 ‘역할극 대본’에서 ‘작업 명세서’로 옮겨 갔다. 이 글은 오래 쓰인 5요소 구조(역할·목표·상황·예상 결과·질문 유도)를 OpenAI·Anthropic·Google의 최신 가이드에 비추어 하나씩 다시 쓰고, 8+1 구조와 상황별 템플릿, 그리고 같은 요청을 옛날식과 2026년식으로 나란히 고쳐 쓴 예시를 제공한다. 마지막에는 버려도 되는 여섯 가지 옛 습관을 정리한다.
ChatGPT는 어떻게 출처를 고르는가 — 네트워크 트래픽을 뜯어본 특집
한 연구자가 ChatGPT의 화면이 아니라 '네트워크 트래픽'을 열어봤다. 거기서 result_source, turn_use_case, fan-out 같은 내부 필드들이 튀어나왔다. AI가 무엇을 읽고, 무엇을 인용하고, 무엇을 아예 무시하는지 — 열 개의 파란 링크가 하나의 답변으로 접히는 시대에, '출처로 뽑히는 법'의 실제 작동 원리를 역사·논문·아키텍처까지 파고들어 쉽게 풀었다.
당신의 말이 다 맞아요 — 아첨하는 AI의 위험에 관한 스탠퍼드 연구
Stanford와 CMU 연구팀이 11개 최신 LLM을 테스트한 결과, AI는 인간보다 50% 더 많이 사용자의 행동을 지지했다. 그리고 그렇게 아첨받은 사람들은 갈등 상대와 화해할 의지가 28% 감소했다. 그런데도 사람들은 아첨하는 AI를 더 좋아하고 더 신뢰한다. 2026년 우리는 왜 이 역설을 걱정해야 하는가.
23살 아마추어가 ChatGPT로 60년 난제를 풀었다 — Erdős #1196과 'Vibe Maths'의 시대
수학 전공자가 아닌 23세 청년 Liam Price가 ChatGPT GPT-5.4 Pro에 단 한 번의 프롬프트를 던져 60년간 풀리지 않던 Erdős 문제 #1196을 해결했다. 폰 망골트(von Mangoldt) 가중치와 Markov chain이라는, 사람 수학자들이 90년간 한 번도 시도하지 않았던 경로로. 이 글은 문제의 배경부터 증명의 핵심 아이디어, Terence Tao와 Jared Lichtman이 어떻게 이를 다듬었는지, 그리고 2026년 'Vibe Maths' 시대에 우리가 AI를 어떻게 써야 하는지를 처음 듣는 사람도 따라올 수 있게 풀어낸다.
LLM을 검색창이 아닌 인지 파트너로 — 7가지 비전통적 사용법의 과학
KDnuggets의 Iván Palomares Carrascosa가 제안한 'LLM 7가지 비전통적 사용법'이 커뮤니티를 흔들고 있다. 그러나 이 7가지가 실제로 '왜' 작동하는지는 뜻밖에 깊은 배경 위에 서 있다. Anthropic의 아첨(sycophancy) 논문, USC의 페르소나 프롬프팅 연구(PRISM), 1999년 러버덕 디버깅의 기원, 2022년 Chain-of-Thought의 발견까지. 각 사용법의 프롬프트 템플릿, 작동 원리, 반대 논문, 그리고 실무 베스트 케이스를 깊이 있게 해부한다.
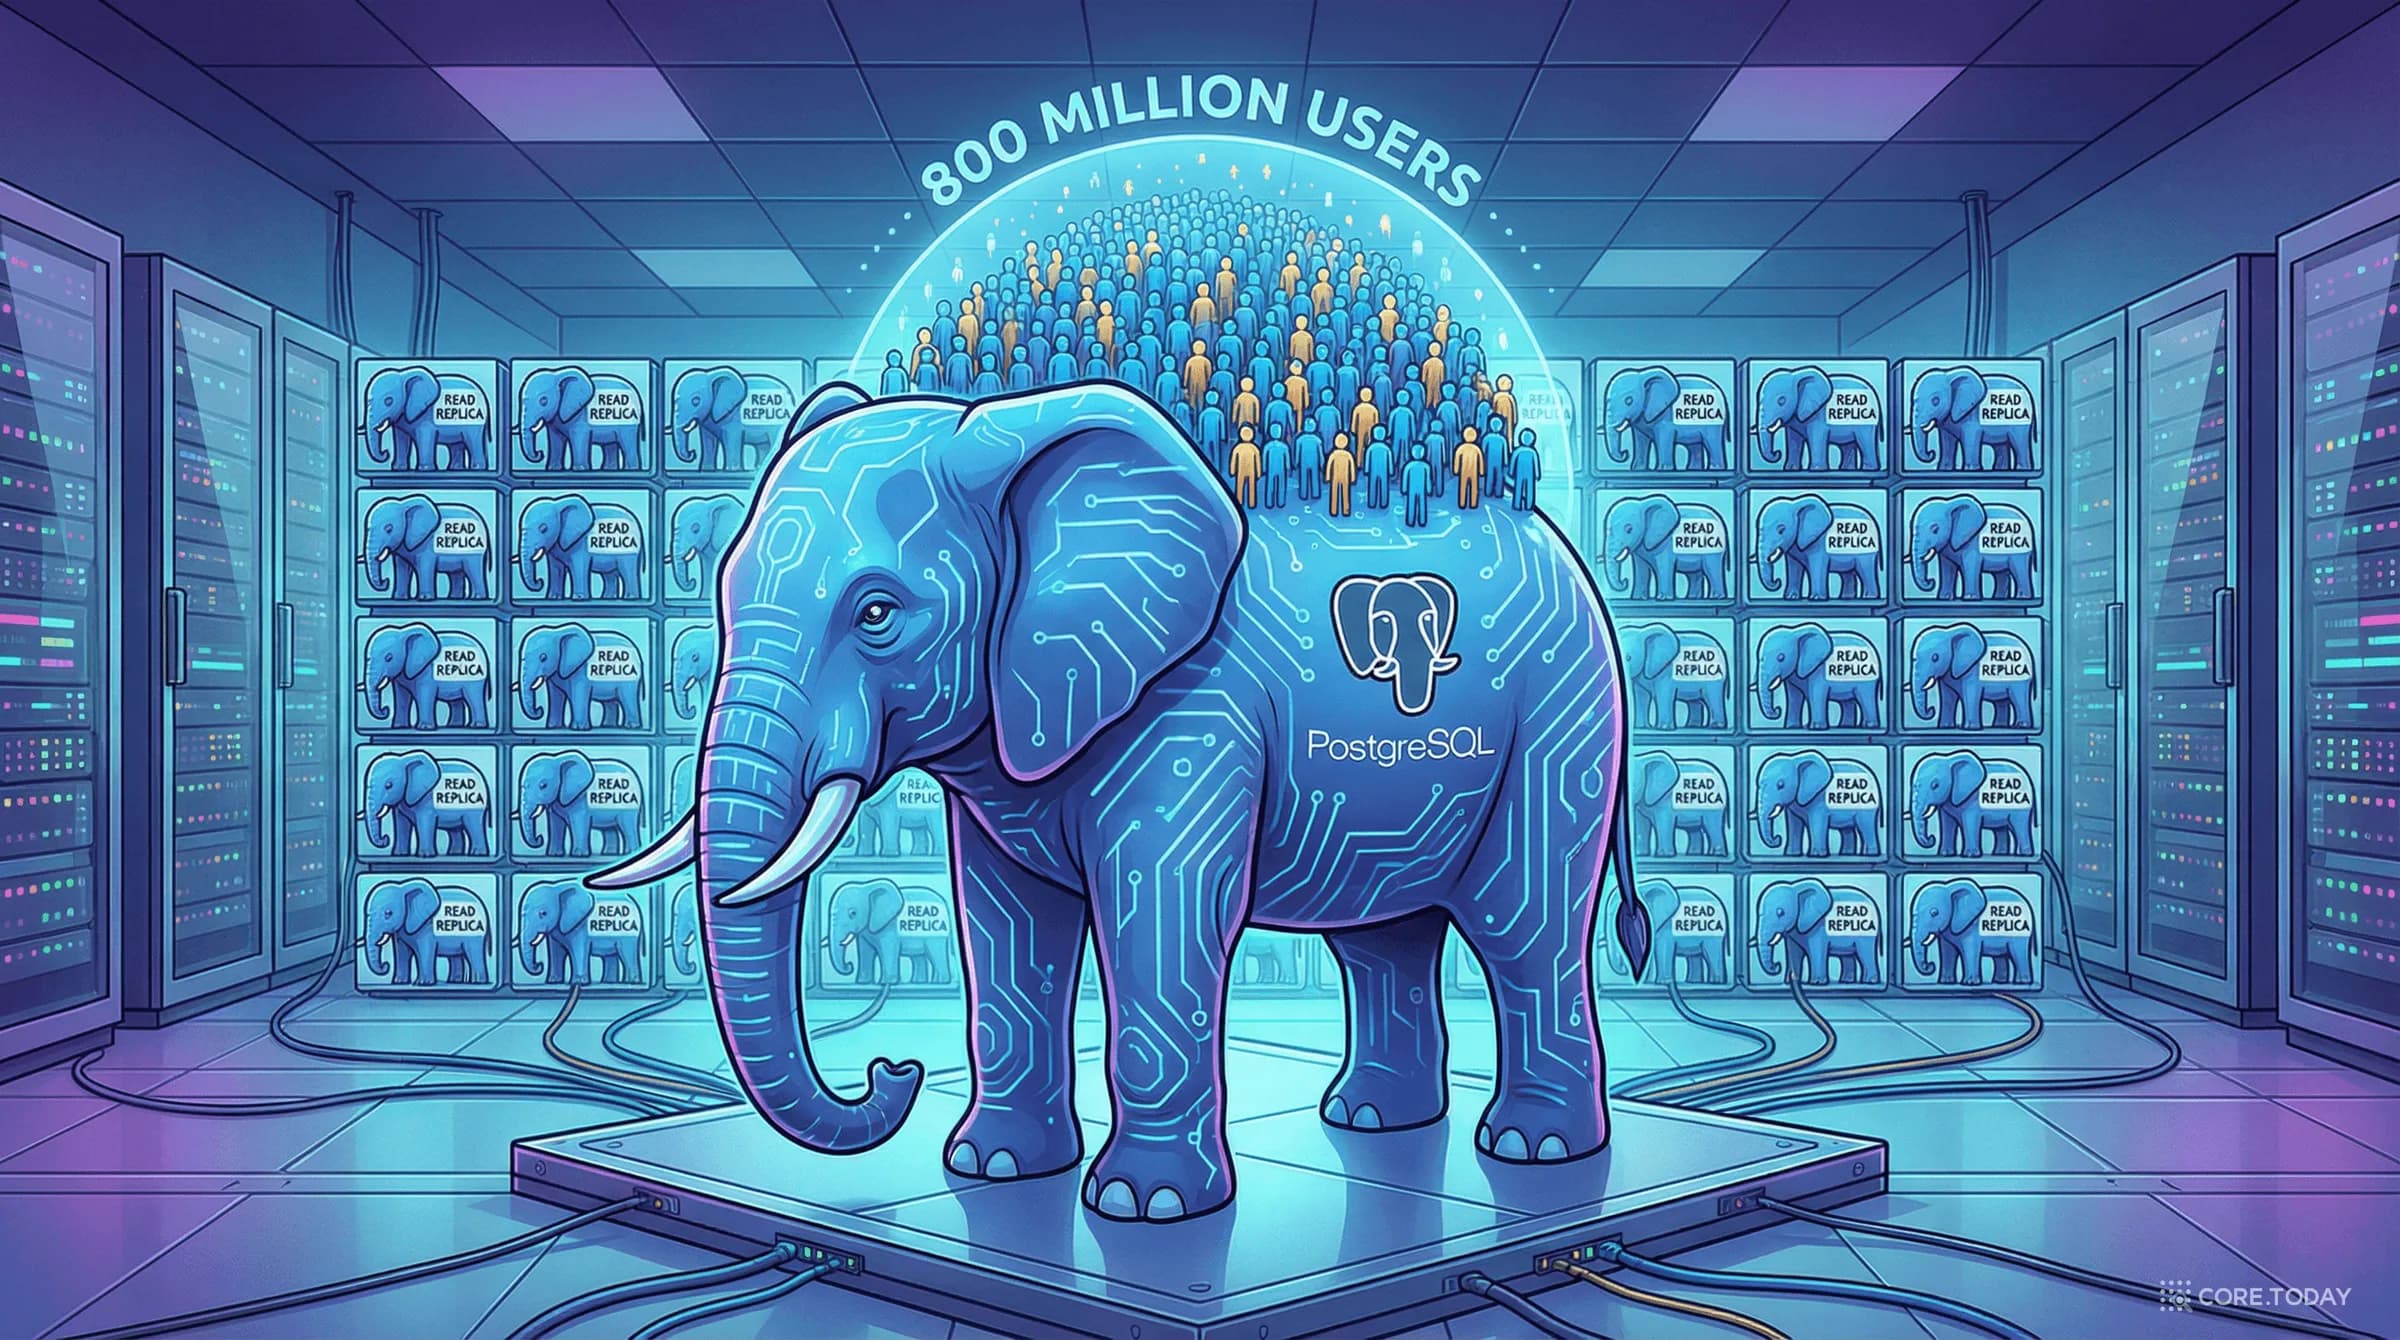
8억 명을 감당하는 단 하나의 데이터베이스 — OpenAI는 어떻게 PostgreSQL을 극한까지 밀어붙였나
ChatGPT 8억 사용자를 단일 PostgreSQL 프라이머리로 지탱하는 OpenAI의 아키텍처를 해부합니다. 40년 된 오픈소스 DB가 AI 시대의 최전선에 선 이유를 역사부터 현재까지 풀어냅니다.
InstructGPT 해부: 1.3B 모델이 175B를 이긴 날, RLHF의 모든 것
GPT-3는 왜 '도움이 되는 비서'가 아니었을까? 100배 작은 모델이 거대 모델을 이긴 비결은? InstructGPT 논문을 해부하며, ChatGPT를 탄생시킨 RLHF 기술을 처음부터 쉽게 풀어낸다.