
#판정 모델
3개의 포스트
지도와 심판 — 임베딩과 판정 모델, 언제 무엇을 쓰나: 업무 12가지와 조합 실측 (로컬 모델 실측 3편)
1편에서 임베딩 모델 아홉 개를, 2편에서 판정 모델 세 개를 같은 맥에서 한국어로 쟀습니다. 3편은 그 둘을 한 자리에 놓고 묻습니다. 어느 일에 어느 쪽을 쓰나. 임베딩은 지도입니다. 수백만 건 중 어디를 볼지 알려 주고, 좌표를 저장해 두고 재사용합니다. 판정 모델은 심판입니다. 눈앞의 후보 몇 개 중 무엇이 맞는지, 규정에 비춰 되는지 안 되는지를 확률과 함께 말합니다. 이 글은 네 가지 질문으로 두 자리를 가르는 진단표, 고객 문의 라우팅·환불 규정·감성 점수·인젝션 탐지·도구 호출 가드·민원 배정·LLM 라우팅 일곱 업무의 실측(판정 모델 세 개 대 임베딩 유사도 대 27B 채팅 모델), 코어닷투데이가 실제로 만나는 업무 열두 가지의 추천 조합·예시·함정, 그리고 '작은 임베딩 + 판정 모델이 큰 임베딩을 따라잡는가'를 1편의 모델 다섯으로 확인한 조합 실험을 담았습니다. 마지막은 메모리·지연·비용·데이터 반출을 한 표로 놓은 운영 체크리스트입니다. 인터랙티브 4개와 삽화 6장.
원본 대 복제품 — Jev와 tev1·Nimble을 같은 한국어 문제 5,000개로 직접 붙이다 (로컬 모델 실측 4편)
2편에서 로컬 판정 모델 tev1·Nimble을 한국어로 쟀을 때 비교 대상인 Jev의 수치는 6편에서 빌려 온 것이었습니다. 코퍼스도 589건이었고 묻는 방식도 달랐습니다. 이 글은 그 빚을 갚습니다. TypeSafe의 Jev 1.13 API를 같은 날, 같은 660건·85문항·625건·93문항에, 글자 하나 다르지 않은 같은 프롬프트로 직접 돌려 로컬 모델 셋과 나란히 놓았습니다. 리랭커 자리(쌍별·한꺼번에, 지시문 두 가지), 작은 임베딩 다섯에 붙인 조합, 분류 625건, 실무 과제 7종, 보정 곡선, 그리고 '둘이 같은 문항을 틀리는가'까지 봤습니다. 결론은 둘입니다. 원본은 묻는 방식을 가리지 않는데 복제품은 가린다. 그리고 복제품이 원본의 자리를 대신하는 과제와 못 대신하는 과제가 분명히 나뉜다. 비용·지연·데이터 반출을 한 계산기로 놓고 어느 쪽을 고를지로 끝냅니다. 인터랙티브 5개와 삽화 4장.
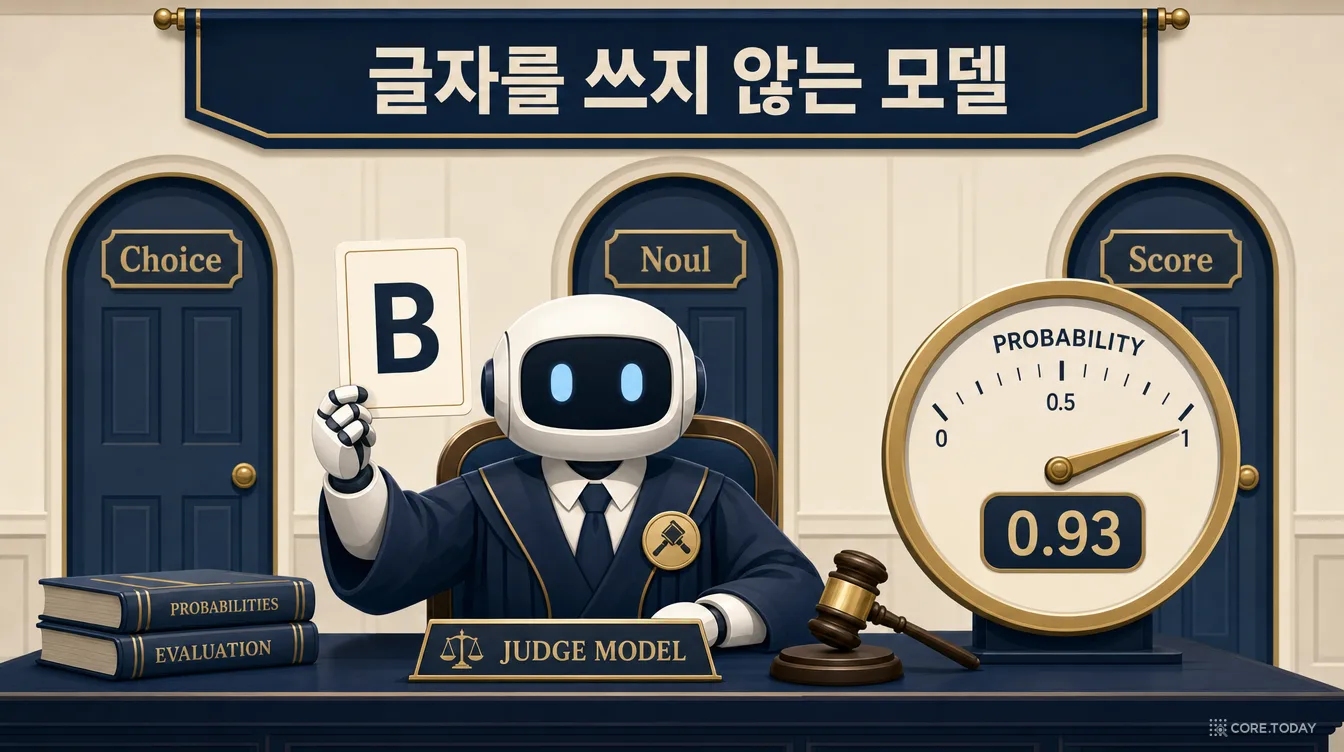
글자를 쓰지 않는 로컬 모델 — Ollama 판정 모델 tev1·Nimble을 한국어로 시험하다 (로컬 모델 실측 2편)
ollama list에 낯선 이름 둘이 있었습니다. tev1:4b와 nimble. ollama show를 쳐 보니 Capabilities에 embedding도 completion도 아닌 'decision'이 적혀 있고, 시스템 프롬프트는 '선택지 중 하나를 고르고 글자 하나만 돌려줘라'였습니다. 9월 15일 TypeSafe가 Jev를 내놓은 뒤 2주 만에 Bespoke Labs(Nimble 9B)와 Together AI(tev1 4B·0.8B)가 열린 가중치로 같은 모양의 모델을 냈고, 9월 29일 Ollama가 /v1/systemone 엔드포인트로 그것을 받아들였고, 10월 1일 클라우드플레어가 27B짜리 Clef를 보탰습니다. 이 글은 그 판정 모델이 무엇이고 왜 빠른지(한 번의 전방 패스에서 선택지 글자의 확률만 읽는다)를 그림으로 풀고, 세 모델의 출신과 학습 레시피를 뜯어본 뒤, 1편과 같은 한국어 코퍼스로 리랭커 자리(85문항 × 10문서)와 분류 자리(625건)에 세워 TypeSafe의 Jev(4편에서 같은 조건으로 직접 실측), 임베딩 이웃 투표, 27B 채팅 모델과 비교했습니다. 결론은 '9B Nimble은 한국어로도 Jev의 자리를 대신하고, 0.8B는 아직 아니다'입니다. 확률이 얼마나 믿을 만한지, 한 번 호출에 몇 ms인지, 한국어 문의 라우팅·규정 적용·감정 점수 같은 실무 과제 7종의 성적도 함께 적었습니다. 인터랙티브 6개와 삽화 7장.