
#벡터 DB
4개의 포스트
4096차원에 HNSW가 필요한 이유 — 전수 비교의 벽, 차원의 저주, 그리고 그래프를 걸어서 찾는 법 (한국어 검색 스택 4편)
1편에서 가장 좋았던 Qwen3-Embedding-8B는 문장 하나를 4,096개 숫자로 바꿉니다. 문서 589건이면 질문 하나에 589번 내적하면 되니 1초도 안 걸립니다. 그런데 문서가 5,000만 건이면? 같은 방식으로는 질문 하나에 2,000억 번 곱셈이고, 서버가 아무리 좋아도 초 단위입니다. 벡터 DB가 HNSW라는 인덱스를 쓰는 이유가 여기 있습니다. 이 글은 왜 고차원에서는 트리 인덱스가 소용없는지(차원의 저주), HNSW가 어떻게 스킵 리스트와 작은 세상 그래프를 합쳐 로그 시간에 근사 최근접을 찾는지, M·ef_construction·ef_search 세 손잡이가 무엇을 바꾸는지를 그림과 장난감 시뮬레이터로 풀고, 4,096차원 벡터 1만·10만·30만 개로 전수 비교와 hnswlib을 직접 재서 비교합니다. 10만 개에서 전수 비교 56ms 대 HNSW 1.3ms(재현율 0.98). 그리고 4,096차원의 진짜 병목은 그래프가 아니라 벡터 자체라는 것, 그래서 3편의 마트료시카 절단과 양자화가 HNSW와 곱해진다는 것을 메모리 계산기로 보입니다. 인터랙티브 4개와 삽화 8장.
RAG는 생각보다 단순합니다 — 벡터 DB 없이 시작하는 6단계 레시피
RAG를 어렵게 느끼는 이유는 개념이 아니라 '처음부터 임베딩·벡터 DB·청킹을 다 갖춰야 한다'는 오해 때문입니다. 오픈북 시험 비유로 RAG의 뼈대를 3분 안에 잡고, 라이트하우스 뉴스레터가 정리한 6가지 RAG 레시피를 전문 검색부터 전체 임베딩까지 계단처럼 올라가며 살펴봅니다. 실제 시스템의 60%는 검색기 하나와 프롬프트 한 장으로 충분합니다. 우리 팀에 맞는 출발점을 고르는 진단 도구와, 같은 질문을 세 방식으로 검색해 보는 놀이터를 함께 담았습니다.
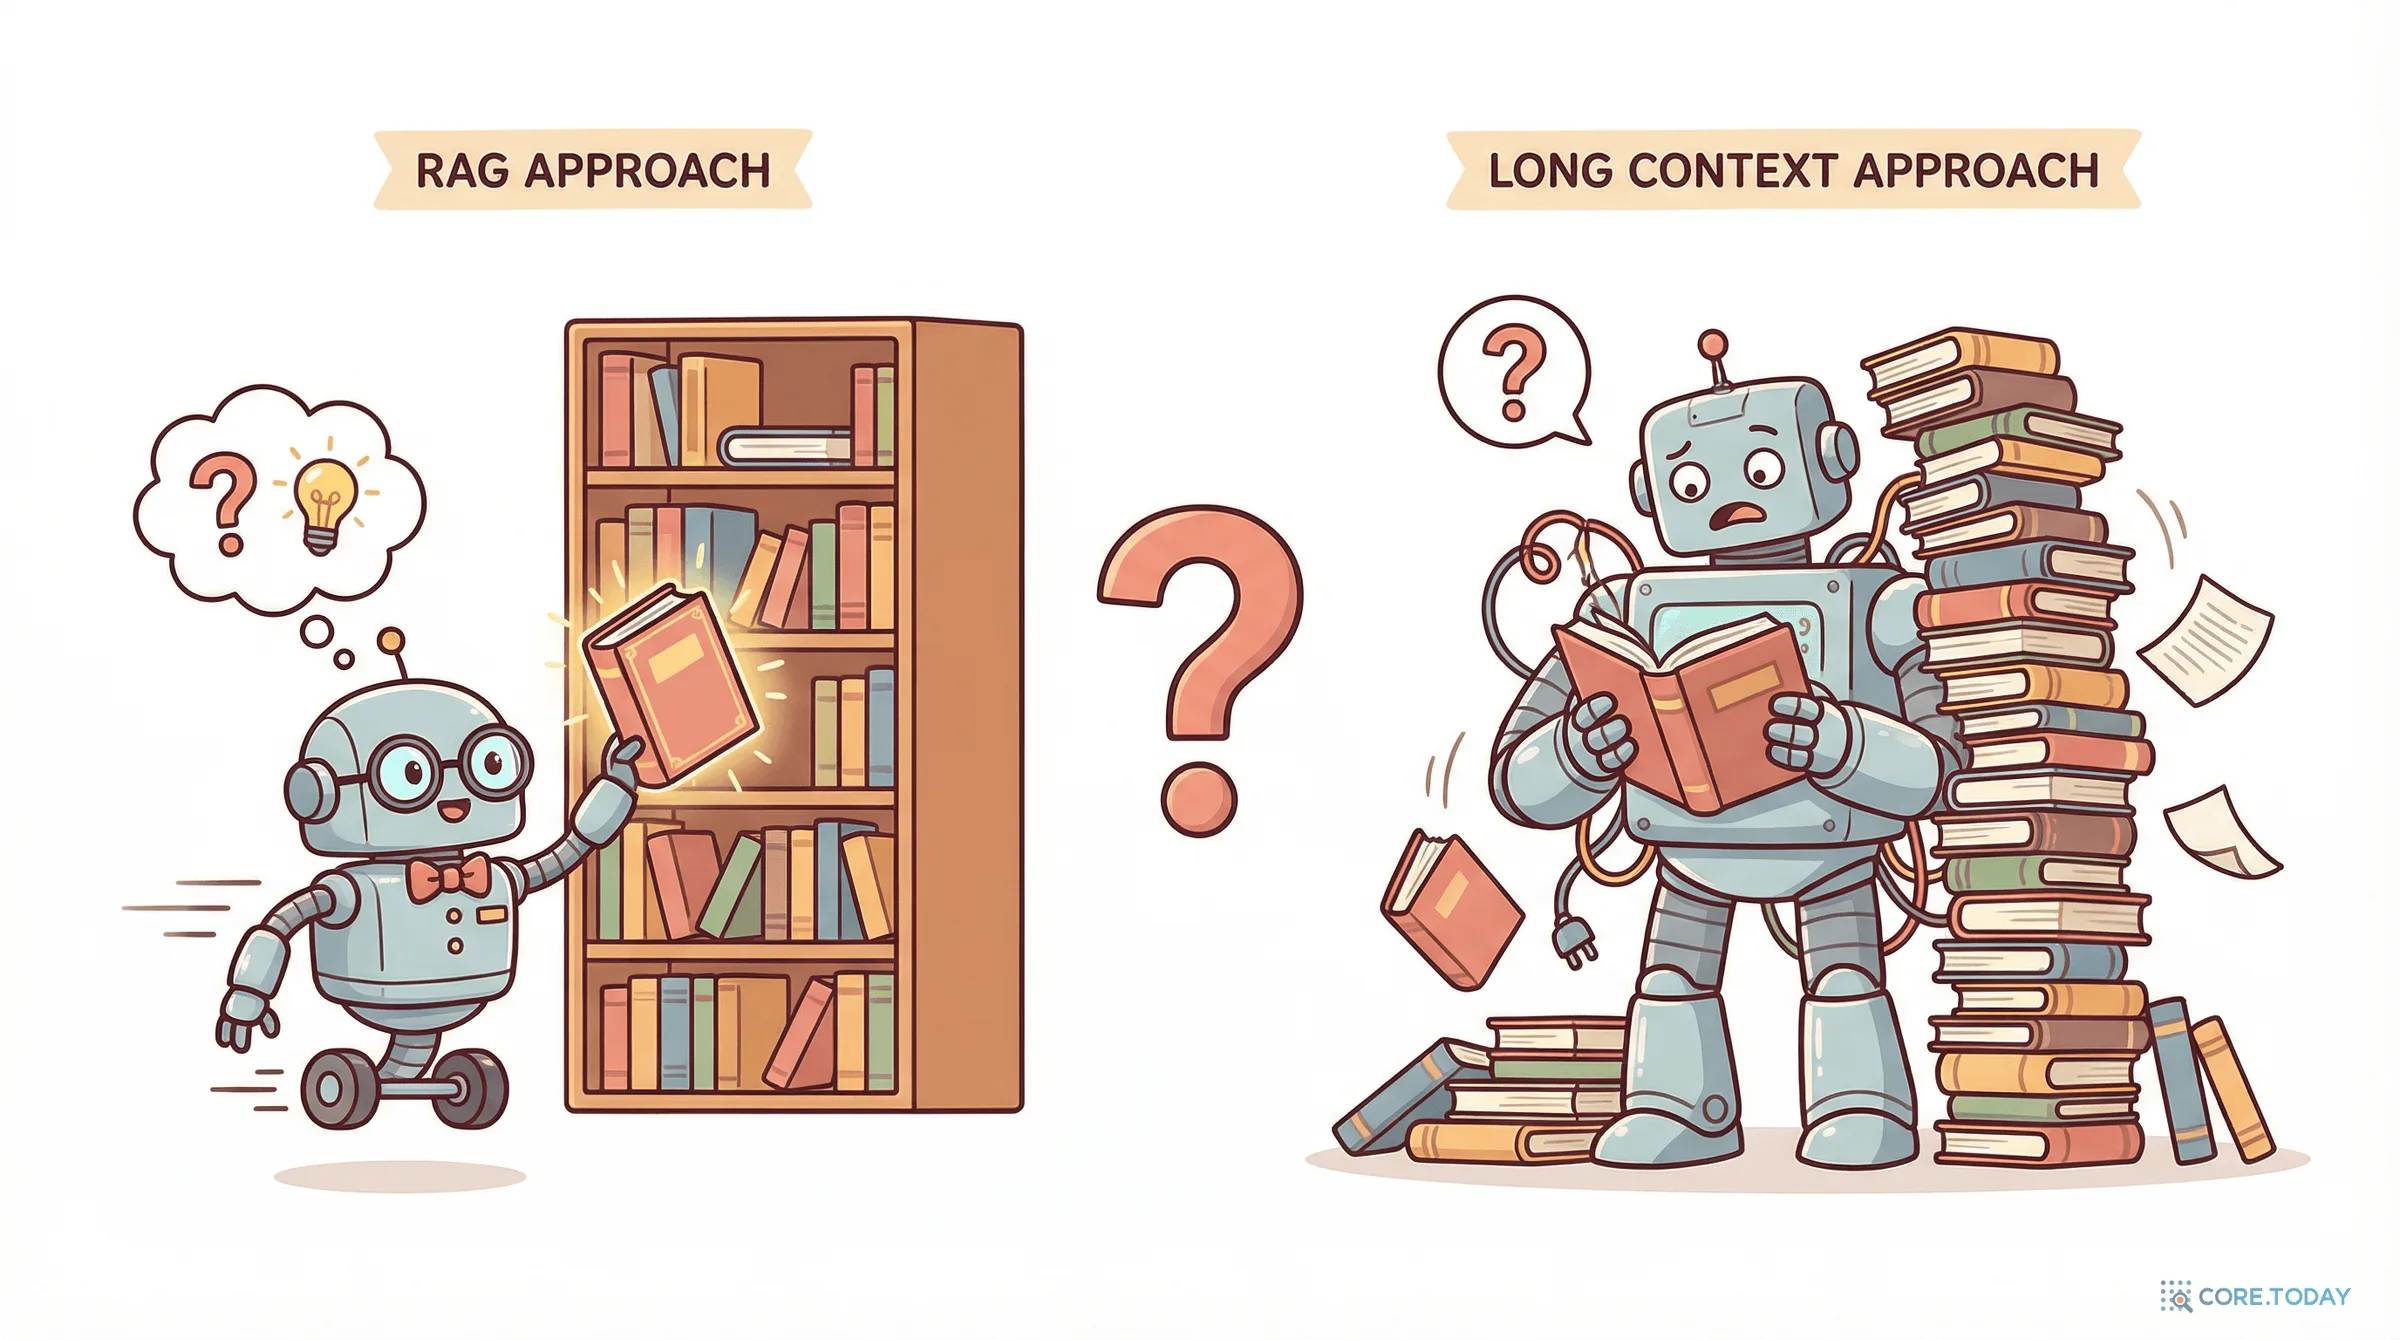
RAG vs Long Context 2026 — 10M 토큰 시대, 검색이 여전히 필요한가?
GPT-2의 1,024 토큰에서 Llama 4 Scout의 1,000만 토큰까지 — 컨텍스트 윈도우가 10,000배 커졌다. 이제 RAG는 필요 없는가? 2026년의 답은 '둘 다'이면서 '상황에 따라 다르다'이다.
SQL vs NoSQL 특집 (Part 2): 2026년 데이터베이스 지형도와 선택 가이드
MongoDB는 ACID를, PostgreSQL은 JSON을 품었다. Netflix는 Cassandra에서 CockroachDB로, Discord는 MongoDB에서 ScyllaDB로 갈아탔다. 2026년, 데이터베이스의 경계는 무너지고 있다. NoSQL 5가지 유형 비교, NewSQL, 벡터 DB, 그리고 실전 선택 가이드.