
#KV 캐시
7개의 포스트
[특집] '얼마나'가 아니라 '어디에' — 생각·구조·시간, 추론 예산을 나눠 쓰는 세 논문 (Gambit·MaAS·LAWA)
같은 문제를 512번 풀게 하고 다수결을 냈는데 오답이 나왔다. 2026년 여름 프린스턴의 Gambit 논문은 이 장면에서 출발해 질문을 바꾼다. 계산을 얼마나 더 쓸지가 아니라 어디에 쓸지다. 이 글은 같은 질문에 서로 다른 단위로 답한 세 논문을 함께 읽는다. Gambit(arXiv 2608.08020)은 한 문제 안에서 GPU 메모리 칸을 유망한 풀이에 몰아주고, MaAS(arXiv 2502.04180, ICML 2025 구두 발표)는 질문마다 에이전트 팀의 크기를 다르게 뽑고, LAWA(arXiv 2610.14481, NeurIPS 2026)는 되풀이되는 질의의 가장 긴 줄을 깎는다. 1976년 음성 인식에서 태어난 빔 탐색이 왜 번역에서 밀려났다가 '생각 단위'로 돌아왔는지, 신경망 구조 탐색의 슈퍼넷이 에이전트로 건너오며 무엇이 바뀌었는지를 따라간 뒤, 세 논문을 부록과 표까지 검산한다. 헤드라인의 +3.3%는 30문항 중 한 문제이고, '엄격히 우세'는 15칸 중 11칸이며, MaAS 표의 토큰 수와 달러는 서로 맞지 않는다. 모의실험과 계산기 다섯 개, 논문 그림 열두 장을 함께 싣는다.
말할수록 무거워지는 기억 — KV 캐시로 본 긴 대화의 비용, 2017년의 첫 캐시부터 GQA·페이지드 어텐션·MLA·어텐션 싱크까지 (특집)
챗봇과의 대화가 길어질수록 답이 느려지고 요금이 오르는 이유는 KV 캐시에 있다. 언어 모델은 한 토큰씩 글을 쓰는데, 앞서 읽은 모든 토큰의 ‘키(K)’와 ‘값(V)’을 메모리에 쌓아 두고 다시 꺼내 쓴다. 계산을 메모리와 맞바꾼 이 장치 덕분에 생성은 빨라졌지만, 대신 대화가 길어질수록 GPU 메모리를 정직하게 잡아먹는다. 이 글은 2017년 원조 트랜스포머 논문에는 없던 캐시가 석 달 뒤 구글 코드에 들어간 이야기에서 시작해, 헤드를 나눠 쓰는 MQA·GQA, 캐시를 압축해 담는 딥시크의 MLA, 운영체제의 가상 메모리를 빌려 온 페이지드 어텐션, 같은 앞부분을 재사용하는 프롬프트 캐싱, 캐시를 2비트로 줄이는 양자화, 그리고 모델이 첫 토큰을 ‘주의 하수구’로 쓴다는 어텐션 싱크까지 따라간다. 그리고 직접 쟀다. 사내 V100에서 Qwen3 0.6B~8B의 캐시 크기와 속도, 동시 사용자 한계, 앞부분 재사용 효과, 캐시 양자화, 창 크기 제한을 실험했고, 피티아의 학습 체크포인트를 거슬러 올라가 어텐션 싱크가 생기는 순간을 찾았다. 1.6만 토큰짜리 앞부분의 캐시를 재사용하자 Qwen3-8B의 첫 토큰이 54배 빨리 나왔다. 캐시를 4비트로 줄일 때 Qwen3는 키를 토큰별로 자르자 무너졌지만, 채널별로 자르면 멀쩡했다. 최근 토큰만 남기자 흔들리던 모델은 첫 토큰 하나를 붙잡아 두자 되살아났다. 인터랙티브 위젯 7종, 코어닷투데이 실측, 삽화 13장.
[특집] 에이전트의 추론은 '미드필'이다 — 캐시 대 새 입력, 그리고 HBM 4단의 역습
코딩 에이전트의 추론은 '프리필 다음 디코드'가 아니라, 이미 캐시된 긴 앞부분에 짧은 새 입력을 붙이는 '미드필'의 반복입니다. 코어닷투데이 Claude Code 로그 6만 1,931번 호출을 세어 보니 입력의 97.8%가 캐시에서 왔고, 새 입력은 중앙값 1,711개로 캐시된 앞부분(중앙값 20만 1,917개)의 119분의 1이었습니다. 이런 일감에서는 HBM의 용량보다 대역폭과 KV를 옮기는 능력이 값을 정한다는 것이 SemiAnalysis의 주장이고, 그래서 Rubin Ultra는 GPU당 HBM을 288GB에서 192GB로 줄였으며 프런티어 연구소들은 4단 HBM을 원합니다. 공개 설정 파일과 공식 자료로 계산한 토큰당 KV는 모델마다 0.9kB에서 389kB까지 400배 넘게 벌어졌고, A100에서 vLLM으로 KV 예산을 줄여 본 실험은 '동시 사용자가 일정 수를 넘기 전까지는 아무 일도 없다'는 모양을 재현했습니다. 메모리 회사 입장의 계산은 유료 구간이라 추정하지 않고, 산수와 열린 질문만 정리했습니다.
모델 서빙 설계 가이드 2026 — 요청 하나의 여정으로 배우는 구조와 노하우
2026년 10월의 모델 서빙에서 엔진은 사실상 정해졌습니다(vLLM, SGLang). 설계의 승부는 엔진 바깥에서 납니다. 이 글은 요청 하나가 들어와 답이 나가기까지의 여정을 식당 운영에 빗대어 따라가며, 지금 통하는 설계와 그 근거를 정리합니다. 응답 시간을 대기·읽기·쓰기로 나눠 재는 법, 최대 처리량이 아니라 굿풋으로 용량을 세는 법, 엔진의 기본값(동시 처리 1,024개, 대기열 무제한)을 그대로 쓰면 안 되는 이유, 같은 대화를 같은 서버로 보내는 것만으로 처리량이 두 배가 되는 라우팅, 받을 수 없는 요청을 거절하는 입장 제어, GPU 사용률이 아닌 확장 신호, 수십 GB 모델의 콜드 스타트를 줄이는 방법, 세대별 양자화 선택, 그리고 규모별 구성까지. vLLM 0.30과 llm-d 0.10의 문서, 그리고 Together·Modal·Baseten·토스·네이버 등이 올해 공개한 운영 사례의 수치를 근거로 삼았습니다. 직접 움직여 보는 위젯 6개가 들어 있습니다.
AI가 단골을 알아보는 법 — 프롬프트 캐시 작동 원리, 일러스트로 이해하기
카페 단골은 '늘 마시던 걸로'라는 한마디면 된다. 그런데 AI는 왜 매번 대화 전체를 처음부터 다시 읽을까 — 그리고 프롬프트 캐시는 어떻게 그 낭비를 10분의 1 가격으로 줄일까? 독서 노트, 도미노, 냉장고, 기차 네 가지 비유와 일러스트로 KV 캐시의 원리를 바닥부터 그려 본다. 왜 '접두사'만 적중하는지, 왜 캐시 쓰기는 비싸고 읽기는 싼지, 왜 1시간이 지나면 증발하는지 — 그림으로 이해하면 /rewind와 /compact 중 뭘 눌러야 할지가 저절로 보인다.
1만 프레임을 잊지 않는 법 — LingBot-Map과 기하 컨텍스트 어텐션
2026년 4월, 앤트그룹의 로봇 자회사가 카메라 영상만으로 1만 프레임 이상을 20 FPS로 3차원 복원하는 모델을 오픈소스로 공개했다. 핵심은 '무엇을 기억하고 무엇을 버릴지'를 어텐션 마스크로 학습시킨 것. 40년 된 SLAM의 지혜가 트랜스포머 안으로 들어온 순간을, 논문과 코드를 끝까지 따라가며 해부한다.
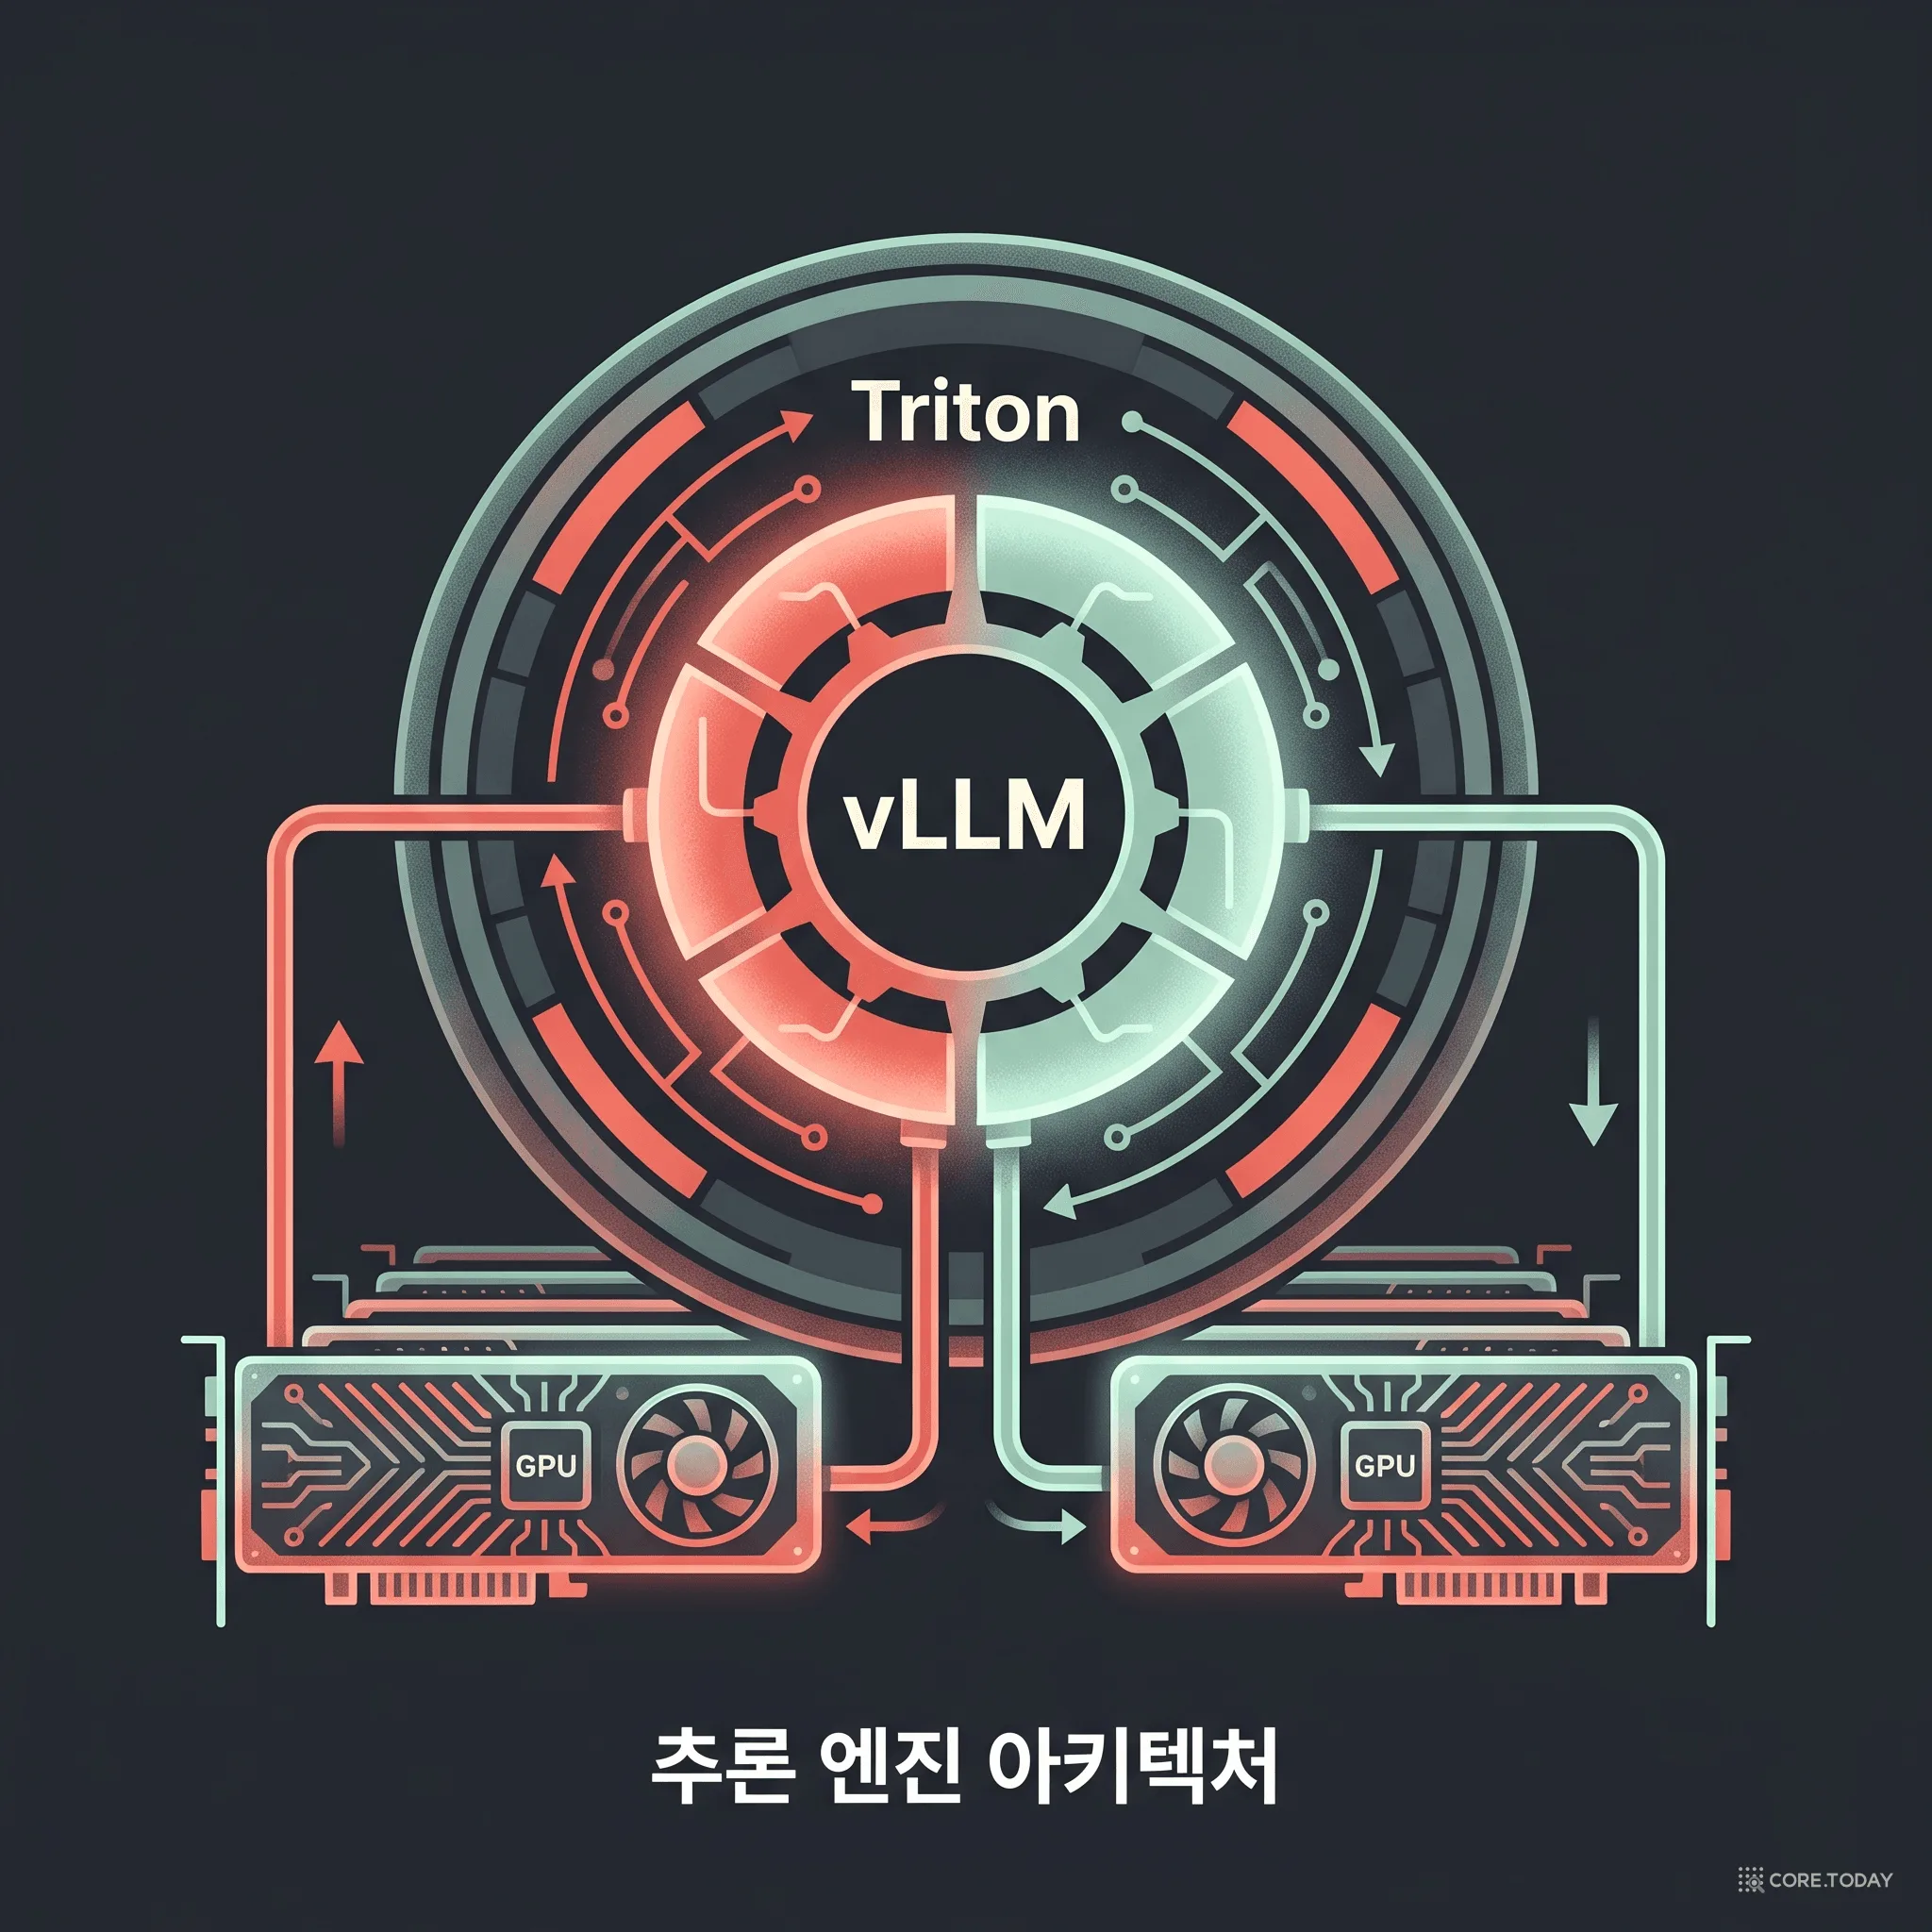
넷플릭스는 왜 LLM을 직접 서빙하는가 (2부): vLLM과 Triton, 서빙 엔진을 해부하다
1부에서 '왜'를 봤다면 2부는 '어떻게'다. 넷플릭스 서빙 스택의 심장인 vLLM과 Triton을 뜯어본다. KV 캐시가 왜 메모리를 잡아먹는지, PagedAttention이 어떻게 그걸 운영체제의 페이징으로 해결했는지, 연속 배칭이 왜 처리량을 몇 배로 끌어올리는지 — 생소한 용어를 하나씩 그림으로 풀고, 넷플릭스가 TensorRT-LLM에서 vLLM으로 갈아탄 진짜 이유까지 따라간다.