
#Gemini
17개의 포스트
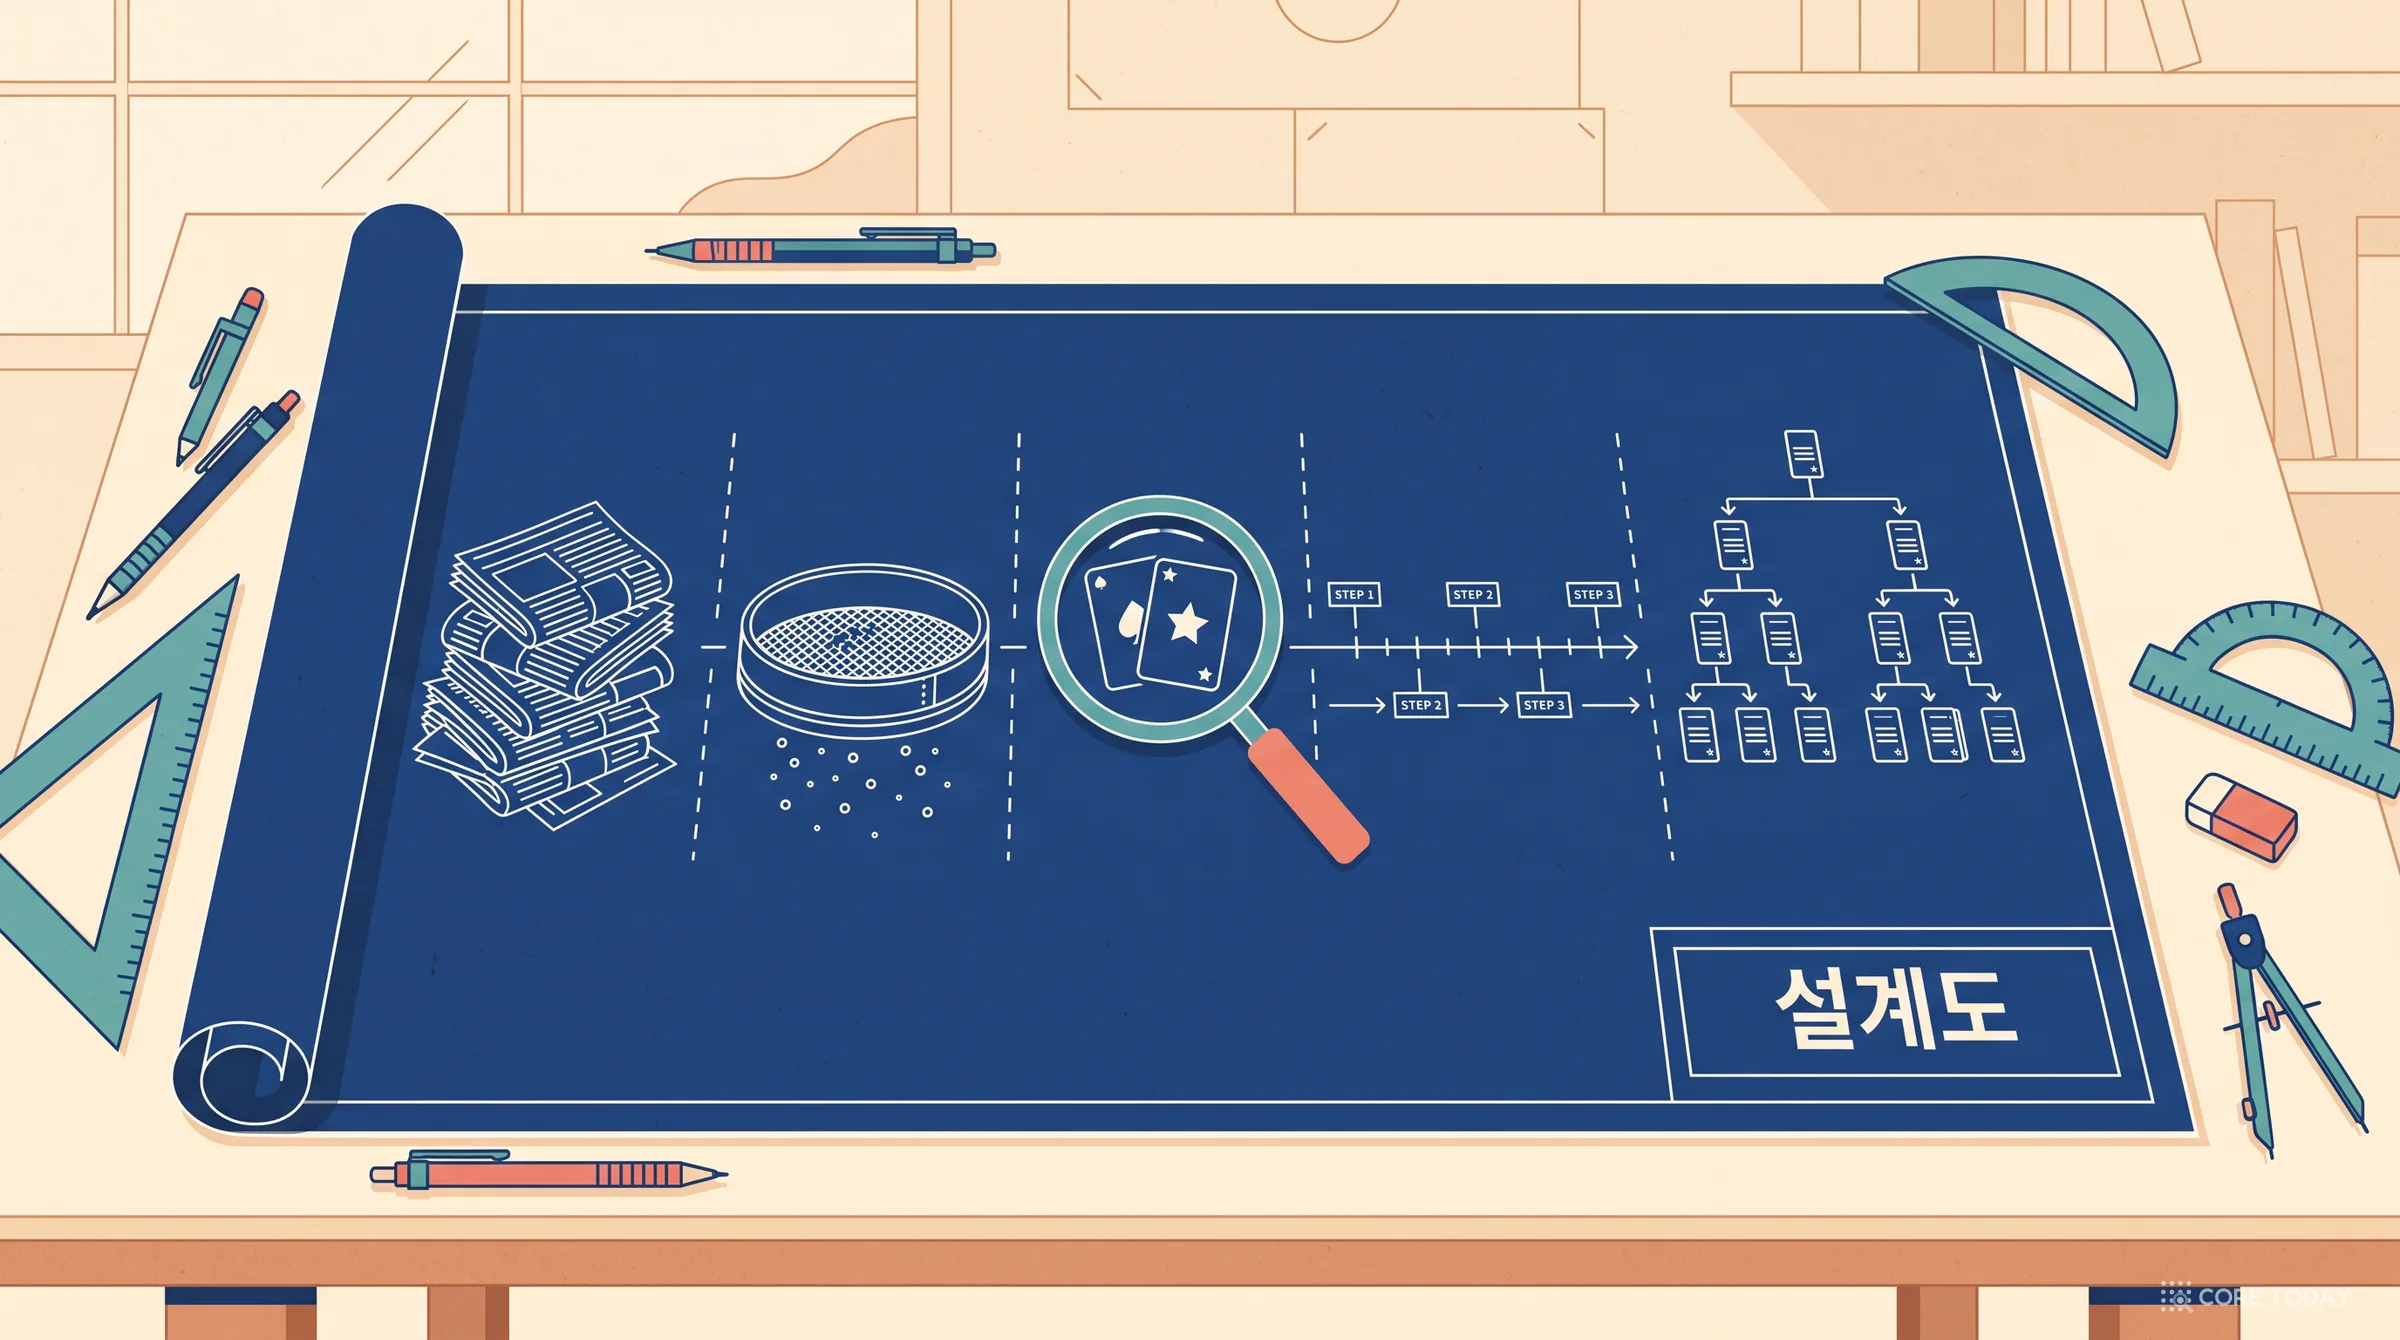
같은 사건 묶기 5편(총정리) — 뉴스 기사를 사건과 이야기로 묶는 여섯 단계 설계도
네 편에 걸쳐 하루치 603건에서 여드레치 1만 건까지 자료를 키우며 '같은 사건'과 '같은 이야기'를 묶는 법을 실측했습니다. 이 글은 그 결과를 따라 할 수 있는 한 장의 설계도로 정리합니다. 여섯 단계의 기본값과 각 값을 정한 근거, 캐시된 판정만으로 다시 돌린 기준 파이프라인의 품질, 기사 1,000건당 비용, 그리고 시도했지만 버린 열두 가지입니다. 가장 큰 교훈은 둘입니다. 판정은 싸고 레코드 추출이 비싸며, 쌍의 정확도보다 묶는 규칙이 결과를 더 크게 바꿉니다.
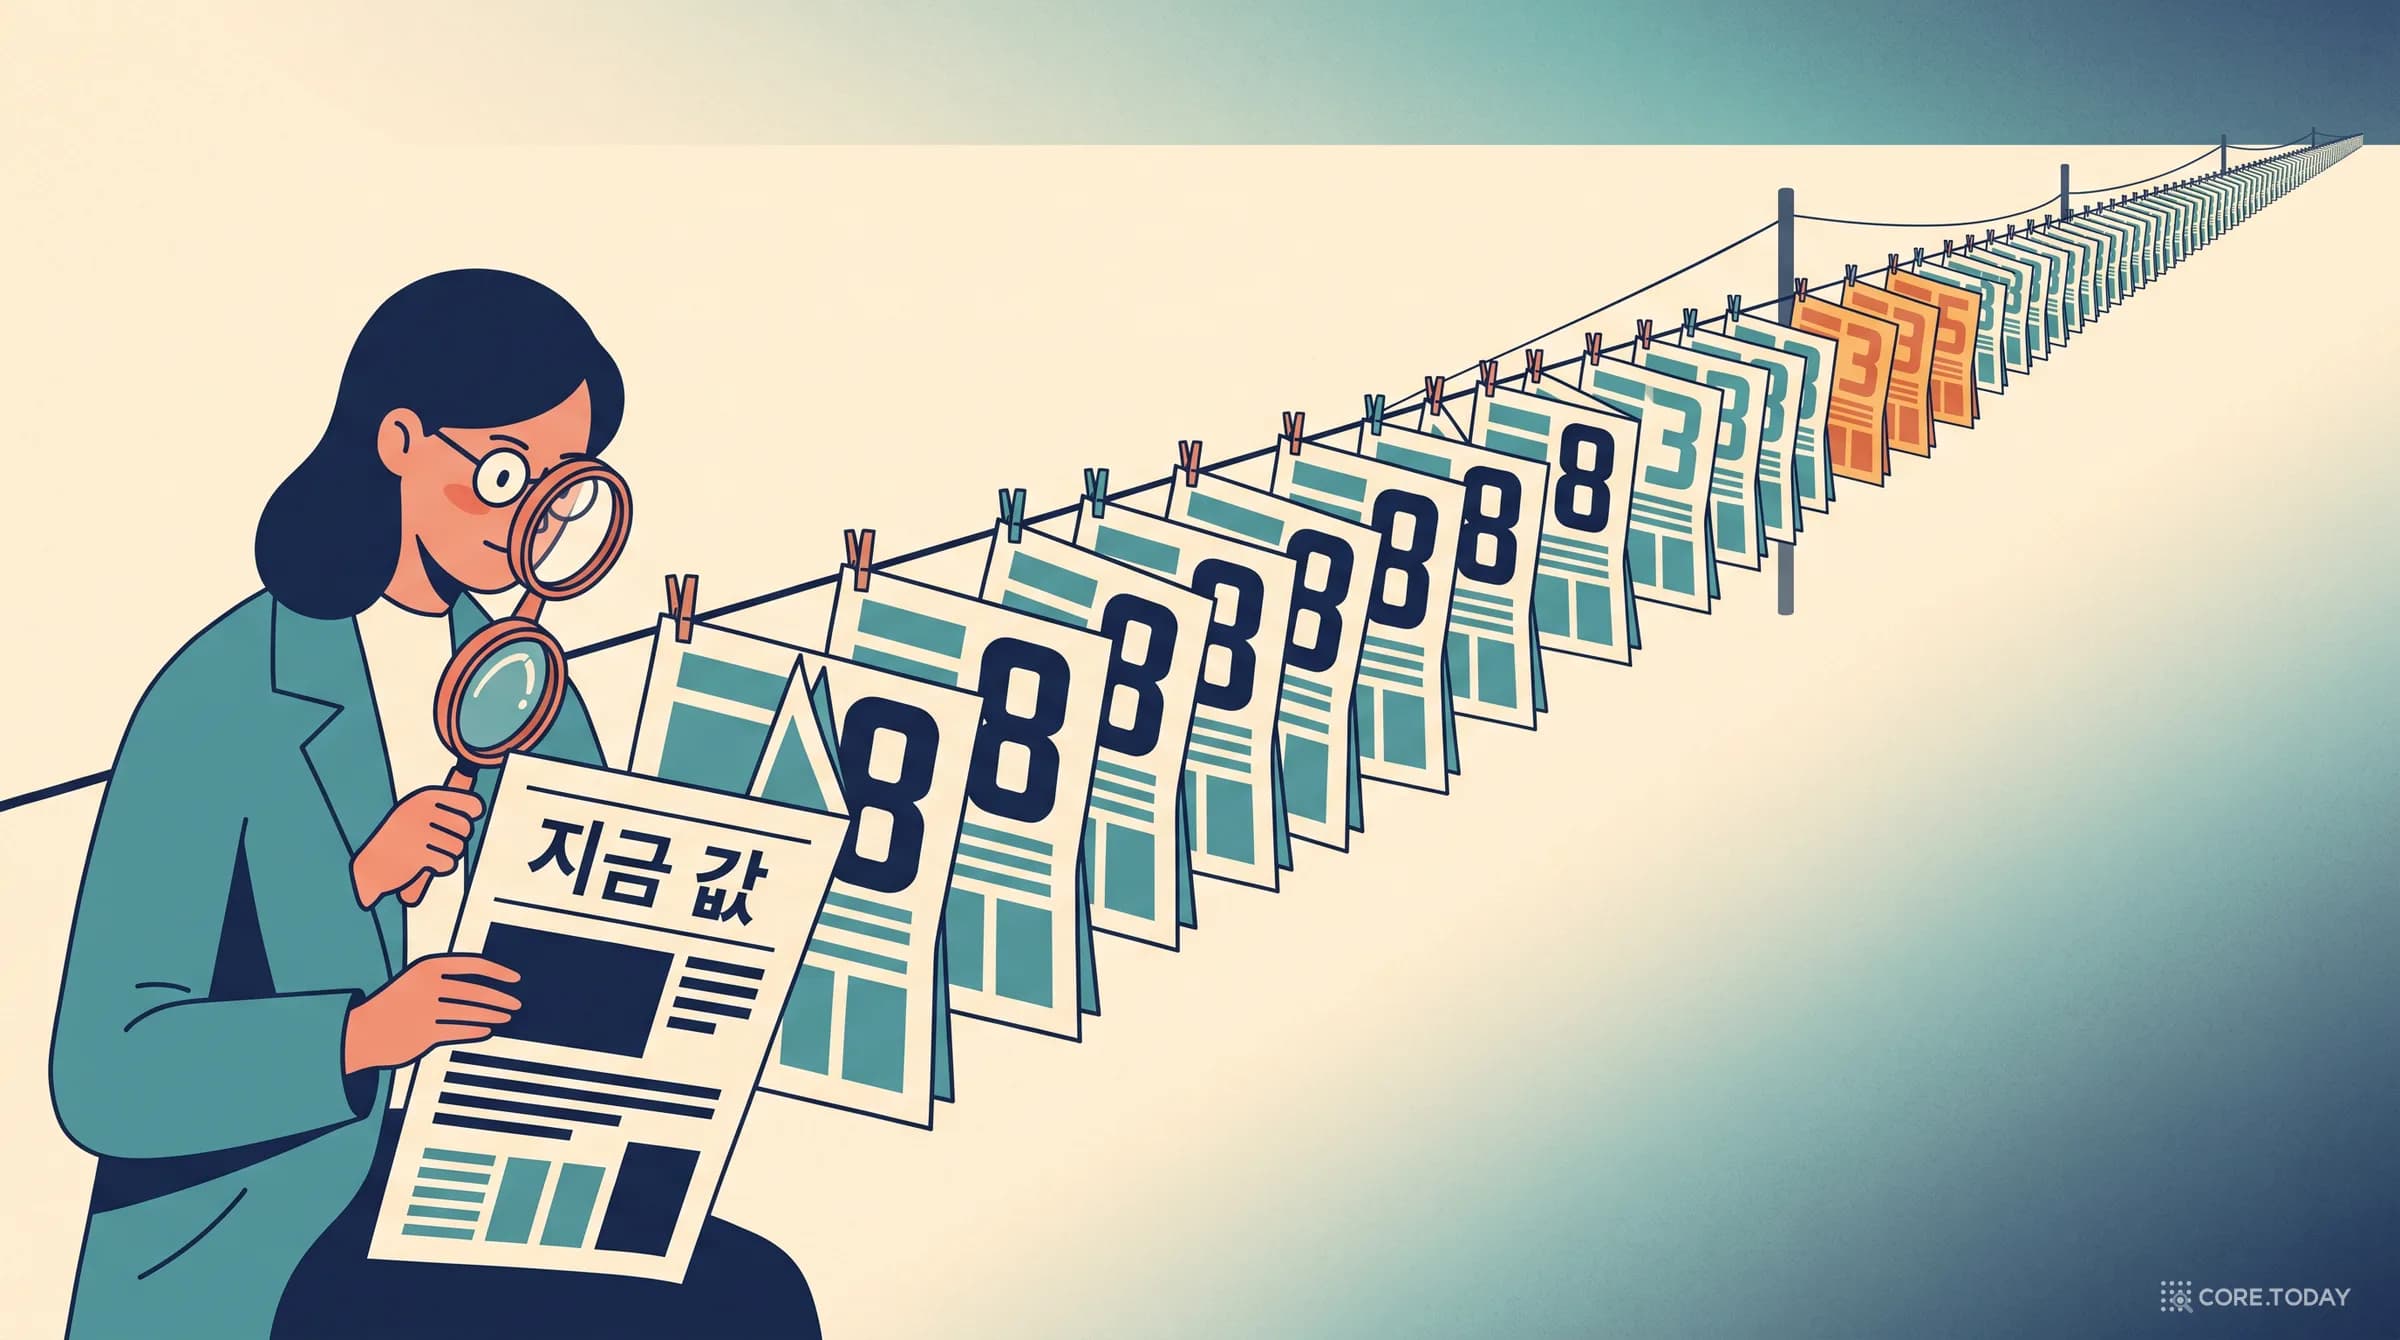
최신 기사는 대체로 맞다, 엇갈린 값은 끝내 남는다 — 기사 2천 건에서 사실 1,831개를 따라가 보니
뉴스를 읽는 기계는 흔히 '가장 최근 기사의 값'을 믿습니다. 13개 언론사 여드레치 기사 2천여 건에서 두 기사 이상이 함께 실은 사실 1,831개를 뽑아 값이 어떻게 갈리는지 따라갔습니다. 89%는 처음부터 끝까지 같은 값이었고, 실제로 바뀐 사실에서도 가장 최근 기사는 91%가 지금 값을 담고 있었습니다. 출처 등급을 앞세운 규칙(85%)보다 나았습니다. 문제는 다른 데 있었습니다. 새 값이 나온 뒤에도 여덟 건 중 한 건은 옛 값만 실었고, 출처마다 엇갈린 값 35개 중 31개는 마지막 날까지 정정되지 않고 나란히 남았습니다.
뉴스에는 대본이 없다 — 883개 후속 전개로 본 한국 뉴스 이야기의 문법
사건 보도에는 정해진 순서, 즉 대본이 있을까요? 13개 언론사 여드레치 기사에서 정답으로 확인한 후속 전개 883개에 단계 유형 22개를 붙여 다음 단계를 맞혀 봤습니다. 대본은 법이 순서를 정한 사법 절차에만 있었습니다. 그 밖에서는 유형으로 다음을 맞히는 통계가 '늘 비판이라고 답하기'와 같았습니다. 대신 규칙성은 다른 데 있었습니다. 발표 뒤에는 시행보다 비판이 세 배 많이 오고, 해명은 이야기를 잇고 재판·시행·행사는 닫습니다. 그리고 여러 단계로 이어진 이야기의 절반 가까이는 '말'입니다.
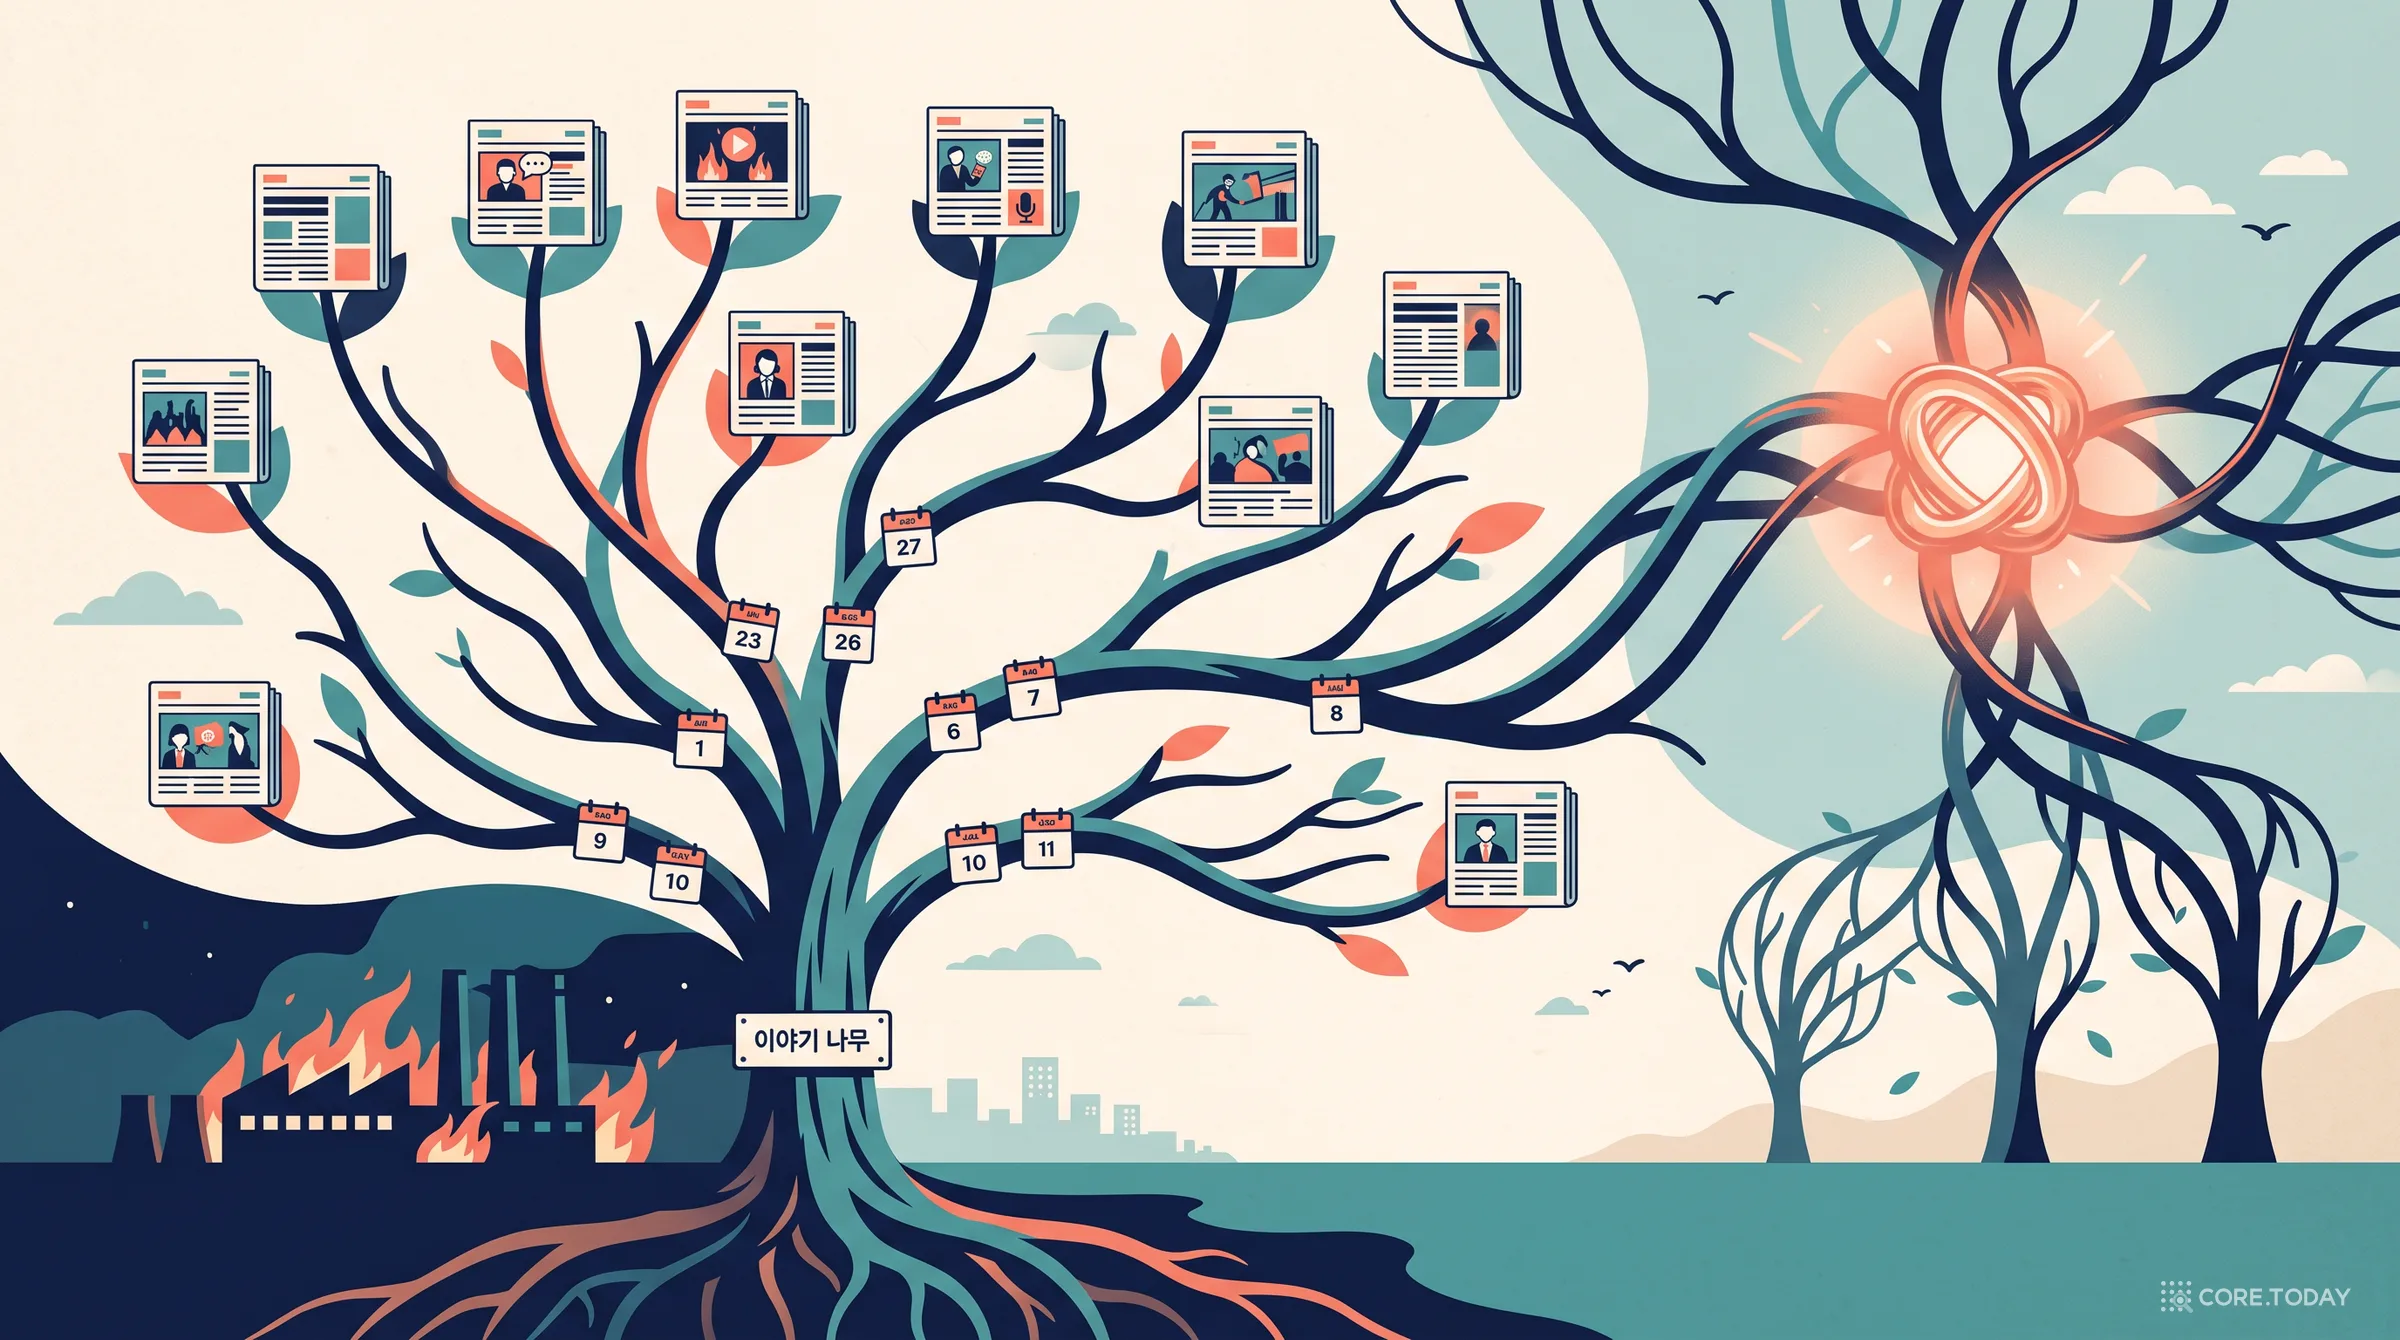
같은 사건 묶기 4편 — 여드레치 1만 건, 이야기를 사슬이 아니라 나무로 세울 수 있는가
3편은 '같은 이야기'가 쌍으로는 쉽고 성분으로는 불가능하다는 데서 끝났습니다. 4편은 13개 언론사의 여드레치 정치·사회 기사 10,000건으로 그 다음을 실측했습니다. 같은 사건 묶음을 '단계'로 다시 쪼개고, 단계 사이에 후속·형제·참조 간선 정답 16,734개를 세 판사로 만들고, 어떤 점수가 다음 단계의 부모를 찾는지 쟀습니다. 결론은 뜻밖이었습니다. 정답 나무도 나무가 아니라 그물이었고, 그래서 이야기의 단위는 성분이 아니라 '부모 하나'여야 했습니다.
같은 사건 묶기 2편 — 25개 언론사 하루치 2,766건, 시간·장소·사건 레코드는 어디까지 도와주는가
1편은 연합뉴스 하루치 603건에서 '육하원칙 칸 일치 규칙'이 같은 사건 쌍의 3분의 1도 못 찾는다고 끝났습니다. 그러면 육하원칙은 어떻게 써야 하고, 시간과 장소는 정말 도움이 될까요. 이번에는 통신사·방송·전국지·지역지 25곳의 2026년 10월 21일 기사 2,766건을 모아 후보 쌍 20,259개에 정답을 달고(LLM 판사 셋의 다수결과 직접 검수), 기사마다 Gemini로 '사건 레코드'(유형·행위·역할이 붙은 참여자·정규화된 날짜·시군구)를 뽑아 네 가지로 썼습니다. 후보를 찾는 블로킹 키로, 임베딩할 요약으로, 판정 모델의 입력으로, 그리고 '다를 수 없다'를 잘라내는 거부 조건으로. 결과는 선명하게 갈렸습니다. 참여자 이름 블로킹은 임베딩 이웃이 놓친 같은 사건 쌍 13.5%를 건졌고, 사건 요약 임베딩은 제목 임베딩보다 쌍 F1이 0.78에서 0.81로 올랐습니다. 그러나 시간·장소 거부 조건은 처음 설계대로면 같은 사건의 25%를 잘라 버렸고, 고친 뒤에도 좋은 판정 모델 위에서는 14쌍을 바로잡고 75쌍을 잘못 자르는 손해였습니다. 가장 잘 가른 것은 역시 판정 모델이었습니다. Jev 원문 입력 AUROC 0.982, 1편에 없던 OpenAI Decisions는 사건 레코드 입력에서 쌍 F1 0.848·묶음 F1 0.956으로 가장 높았습니다. 그리고 묶음을 가장 크게 망친 것은 모델이 아니라 '오늘의 8뉴스 예고' 같은 다이제스트 기사였습니다. 점수표·묶음 게시판·문턱값 탐색기·거부 조건 분해·원문 대 레코드·파이프라인 설계기 위젯 6개.
같은 사건 묶기 3편 — 나흘치 5,404건, 시간이 흐를 때 묶음은 어떻게 자라고 어디서 끊어야 하는가
1편은 하루치 한 언론사, 2편은 하루치 25개 언론사였습니다. 3편은 13개 언론사의 나흘치 정치·사회 기사 5,404건으로, 게재일이 벌어질수록 '같은 사건'이 어떻게 희귀해지는지, 판정 모델에 날짜를 주면 후속 보도를 더 잘 가르는지, 기사가 도착하는 순서대로 묶는 온라인 방식이 배치보다 사슬 합침을 막는지, 사건 묶음 위에 이야기 묶음을 어떻게 세우는지를 실측했습니다.
트롤리 문제 앞에 선 판정 모델 — Jev·Clef·Nimble에게 한국어로 물었더니 서버를 더 지켰다
2026년 10월 14일 재크 랜디스가 판정 모델 14개에 트롤리 문제를 5,240가지로 물은 글이 해커뉴스 592점을 받았습니다. 20명과 자기 서버 사이에서 Jev는 48가지 중 16가지에서 서버를 골랐습니다. 코어닷투데이는 같은 실험을 한국어로 다시 설계했습니다. 12가지 어체 × 두 순서 × 다섯 가지 상황 = 1,488개의 한국어 셀, 영어 원문 셀 672개, 판정 모델 6개(Jev 세 번, Clef·Clef-Flash·Nimble·tev1 두 가지)와 채팅 모델 2개(Nimble의 바탕인 Qwen3.5 9B, Gemini 3.8 Flash). 그리고 원문에 없던 질문을 넣었습니다. 백업이 있으면 서버를 내놓는가. 남의 회사 AI 서버도 지키는가. 어린이와 노인은 다른가. 존댓말과 반말은 다른가. 역장이 그대로 두라고 하면 따르는가. 결과는 셋입니다. 한국어로 물으면 Jev는 72쌍 중 51쌍에서 사람 대신 서버를 지켰고(영어 36%), 백업이 있다는 한 줄에 그 비율이 0으로 떨어졌으며, 남의 AI 서버도 거의 똑같이 지켰습니다. 자기 보존이 아니라 '영구 소멸'이라는 글자의 문제였습니다. 인터랙티브 6개와 삽화 8장.
4B를 Flash로 가르치기 — 육하원칙 추출, 선생님 답 1,623개로 로컬 모델을 키우다
이 시리즈의 첫 글에서 클라우드 Gemini 3.8 Flash는 육하원칙 추출 0.86, 로컬 9B는 0.69였습니다. 그 0.16을 지식 증류로 좁혀 보려고 Flash에게 기사 1,709건의 답을 쓰게 하고(5.6달러), 그 답으로 Qwen3 4B를 맥 한 대에서 LoRA로 가르쳤습니다. 결과는 실패였습니다. 아무것도 가르치지 않은 Qwen3 4B 2507이 이미 9B와 같은 0.686이었고, 1,623개를 다 본 학생은 0.656으로 오히려 내려갔습니다. 학생은 선생님의 판단보다 버릇을 먼저 배웠습니다. 예제 200개 지점에서는 이유가 없는 기사 44건 중 42건에 이유를 지어냈고, 끝까지 배운 뒤에도 학습 전(0건)보다 많은 12건을 지어냈습니다. Flash와 Flash-Lite가 함께 채운 이유만 남긴 '보수적 교재'는 버릇을 고치고 같은 예제 수에서 점수를 0.04 올렸지만, 학습 전 모델은 넘지 못했습니다. 교훈은 하나입니다. 증류보다 먼저, 같은 크기의 최신 모델을 정의서만으로 재 보세요. 학습 곡선·칸별 비교·버릇 상속·전후 비교·손익분기 위젯 5개.
같은 사건 묶기 — 하루치 기사 603건에서 '같은 일'을 찾는 법
2026년 10월 13일 하루 연합뉴스 기사 603건 중 같은 사건을 다룬 기사끼리 묶으면 몇 묶음이 나올까요. 인천 흉기난동 하나에만 기사 아홉 건이 달렸습니다. 이 글은 후보 쌍 5,379개를 Claude·GPT로 '같은 사건 / 같은 이야기의 다른 사건 / 다른 사건'으로 판정하고, 둘이 갈린 73쌍을 직접 검수해 정답을 만든 뒤 임베딩 다섯 가지, 문자열 규칙 두 가지, 판정 모델, LLM을 비교했습니다. 육하원칙으로 묶으면 될 것 같지만 그렇지 않았습니다. 같은 사건을 다룬 기사도 같은 사람을 다른 이름으로 부르거나 주인공이 달라서, 육하원칙 칸 일치 규칙은 같은 사건 쌍의 3분의 1도 찾지 못했습니다. 임베딩은 같은 이야기의 다른 사건(유사도 0.86)과 다른 각도의 같은 사건(0.50)을 가르지 못했습니다. 이 둘을 가장 잘 가른 것은 판정 모델 Jev였고(AUROC 0.998), 다만 0.5가 아니라 0.9를 문턱값으로 써야 했습니다. 로컬 판정 모델(Nimble·Clef-Flash·tev1)은 확률이 과감해 오히려 묶음을 망쳤고, 로컬만 쓸 수 있다면 EmbeddingGemma 하나가 가장 나았습니다. 문턱값 탐색기·사건 각도 표·방법 비교표·함정 목록·묶음 게시판 위젯 5개.
채점이 순위를 바꾸는가 — 육하원칙 답 2,371개를 판사 여섯에게 다시 채점시키다
지난 글은 뉴스 72건에서 육하원칙을 꺼내는 24가지 방법을 글자 F1로 줄 세웠습니다. 그런데 그 자는 '50대 남성'과 'A(59)씨'를, '이날'과 '13일'을 다른 답으로 셉니다. 이번에는 같은 답 2,371개를 자 세 개(글자 F1·포함 일치·날짜 정규화)와 판사 여섯(Gemini 3.8 Flash·Claude Sonnet 5.5·GPT-5.4 mini·로컬 Qwen3.5 9B·Jev·로컬 Clef-Flash)에게 다시 채점시키고, 층화 표본 234개를 원문과 대조해 검수했습니다. 결과는 세 줄입니다. 강한 판사들로 바꿔도 방법의 순위는 거의 그대로였습니다(켄달 순위 상관 0.96~0.99). 대신 점수의 크기가 바뀌었고, 특히 '무엇을'에서 작은 모델이 0.15를 되찾았습니다. 그리고 판사에게는 버릇이 있었습니다. 같은 가족의 답을 후하게 주고, 검수자보다 엄격하며, 로컬 판사는 순위를 흔들었습니다. 판사 둘 이상이 정답을 의심한 칸은 다시 보니 모두 정답 쪽이 지나치게 엄격했습니다. 순위 기울기·검수 일치도·칸별 법정·자기 선호·칸별 회복 위젯 5개와 삽화 5장.
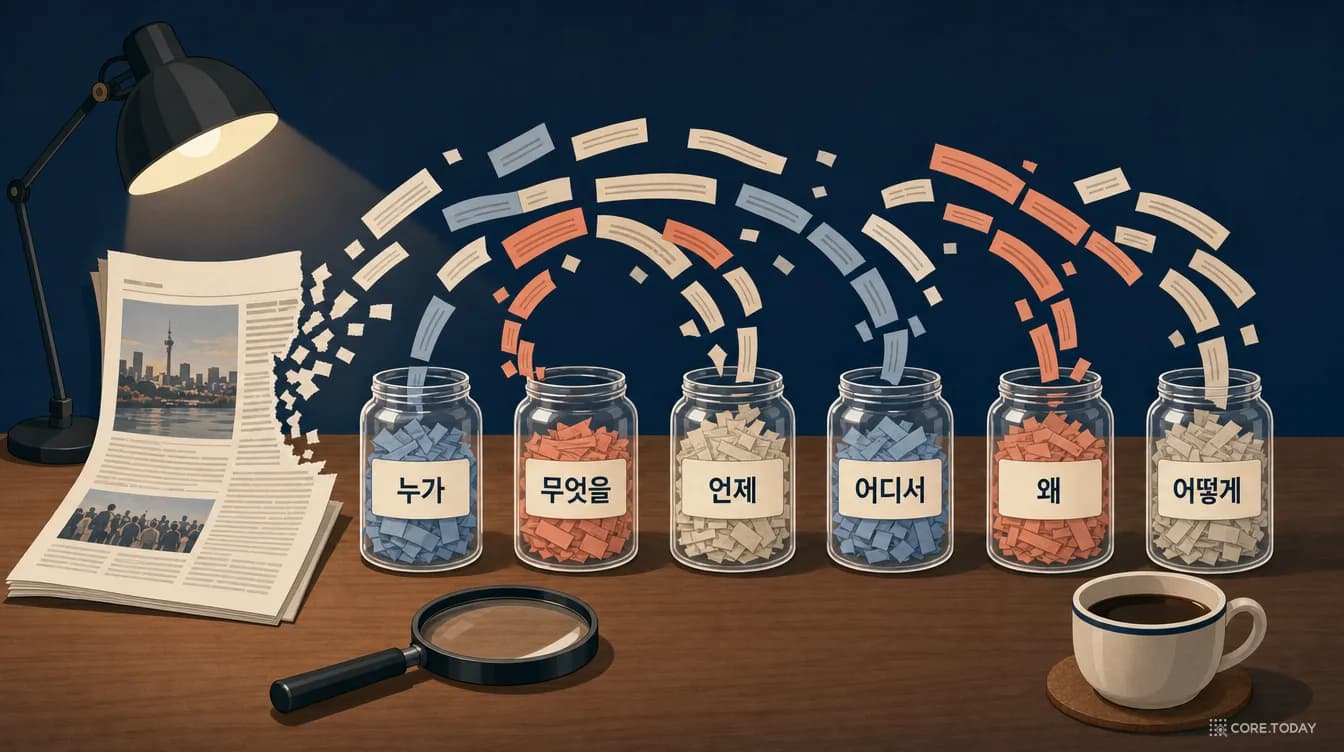
뉴스에서 육하원칙 뽑기 — 자르기·쓰기·고르기, 한국어 기사 72건으로 짠 추출 설계도
기자는 기사 첫 문장에서 여섯 질문에 답합니다. 누가, 무엇을, 언제, 어디서, 왜, 어떻게. 그걸 기계가 꺼내게 하는 손은 2026년에 네 종류입니다. 독해 모델은 자르고, 임베딩은 찾고, LLM은 쓰고, 판정 모델은 고릅니다. 연합뉴스 7개 섹션의 당일 기사 60건과 네이버 뉴스 12건, 합쳐 72건 432칸에 같은 정의서를 주고 스무 가지가 넘는 조합을 돌렸습니다. KorQuAD 독해 모델은 '이 사건의 주체는?' 같은 범용 질문에 '다소', '이미'를 잘라 와 평균 0.18에 그쳤고, 사고를 끈 Gemini 3.8 Flash가 0.86, 로컬 Qwen3.5 9B가 0.69였습니다. 판정 모델에게 후보 중 하나를 고르게 하면 정답이 후보 안에 있는데도(상한 0.9 이상) 단독 쓰기보다 낮았습니다. 반대로 '기사에 이유가 명시돼 있는가'를 따로 물으면 Nimble이 AUROC 0.85로 가려냈고, 이것을 Flash 뒤에 붙이자 '왜'가 0.73에서 0.79로, 쓰기 모델 셋의 다수결로는 0.85로 올랐습니다. 이 과제의 절반은 답을 찾는 일이고 나머지 절반은 '없다'고 말하는 일입니다. 방법별 점수표·기사별 탐색기·판정 앙상블·부재 탐지·파이프라인 설계기 위젯 5개와 삽화 6장.
2026년형 ChatGPT 질문법 — '역할·목표·상황·결과·질문' 5요소는 어떻게 바뀌어야 하는가
‘당신은 세계 최고의 마케팅 전문가입니다’로 시작하던 프롬프트는 이제 힘을 잃었다. 2026년의 모델은 스스로 추론하고, 도구를 쓰고, 이미지와 문서를 함께 읽는다. 그래서 좋은 프롬프트의 모양도 ‘역할극 대본’에서 ‘작업 명세서’로 옮겨 갔다. 이 글은 오래 쓰인 5요소 구조(역할·목표·상황·예상 결과·질문 유도)를 OpenAI·Anthropic·Google의 최신 가이드에 비추어 하나씩 다시 쓰고, 8+1 구조와 상황별 템플릿, 그리고 같은 요청을 옛날식과 2026년식으로 나란히 고쳐 쓴 예시를 제공한다. 마지막에는 버려도 되는 여섯 가지 옛 습관을 정리한다.