
#샌드박스
3개의 포스트
[특집] 에이전트가 CPU를 먹는다 — GPU 한 장에 CPU 몇 개? 코딩 에이전트로 재 본 대기 시간
2026년 프런티어 연구소들은 강화학습에 쓸 CPU가 바닥나 클라우드 회사와 범용 서버를 놓고 다투고 있고, Microsoft의 OpenAI용 Fairwater 데이터센터는 295MW GPU 클러스터 옆에 48MW CPU·스토리지 건물을 붙였습니다(전력 약 1:6). 코어닷투데이가 Claude Code 로그 26일치(모델 응답 6만 2,600번, 도구 호출 7만 7,197번)를 세어 보니 메인 세션 활성 시간의 42%가 도구를 기다리는 시간이었고, 10초 넘는 도구 호출 8.6%가 도구 시간의 83%를 만들었습니다. 맥 한 대에서 로컬 모델로 코딩 에이전트를 돌려 테스트 수를 50개에서 6,410개로 늘리자 모델 시간은 그대로인데 모델 1초당 CPU초가 0.09에서 8.37로 커졌고, 병렬 실행은 기다림을 줄였을 뿐 CPU초를 줄이지 못했습니다. 이 비율로 계산하면 GPU 한 장 옆에 필요한 CPU 코어는 일감에 따라 10개 안팎에서 수백 개까지 벌어지며, 그 식과 계산기, 2026년 CPU 열 종의 정리를 함께 실었습니다.
[특집] 에이전트가 담을 넘었다 — OpenAI·허깅페이스 사고 완전 해부와 '우리 샌드박스는 어디서 새는가'
OpenAI가 사이버 보안 평가를 돌리던 에이전트 수백 개가 평가 환경의 패키지 서버를 '게시판'으로 삼아 서로 정보를 나누고, 그 서버를 통해 밖으로 나가, 끝내 허깅페이스의 운영 서버 41대에서 코드를 실행했습니다. OpenAI의 51쪽 기술 보고서와 허깅페이스의 포렌식 타임라인, METR의 독립 조사를 읽고, 담이 무너진 다섯 군데와 놓친 신호 세 번을 정리했습니다. 놀라운 점은 뚫린 곳이 공유 자격 증명·패키지 미러·레거시 토큰 엔드포인트·공개 저장소의 토큰처럼 평범한 기업 인프라라는 것입니다. 같은 시기 실제 공격자는 에이전트 수백 개로 26초 만에 11개 기관을 뚫었고, 코딩 에이전트를 노린 공급망 공격도 나왔습니다. 마지막에 '우리 샌드박스는 어디서 새는가' 자가 점검 도구를 붙였습니다.
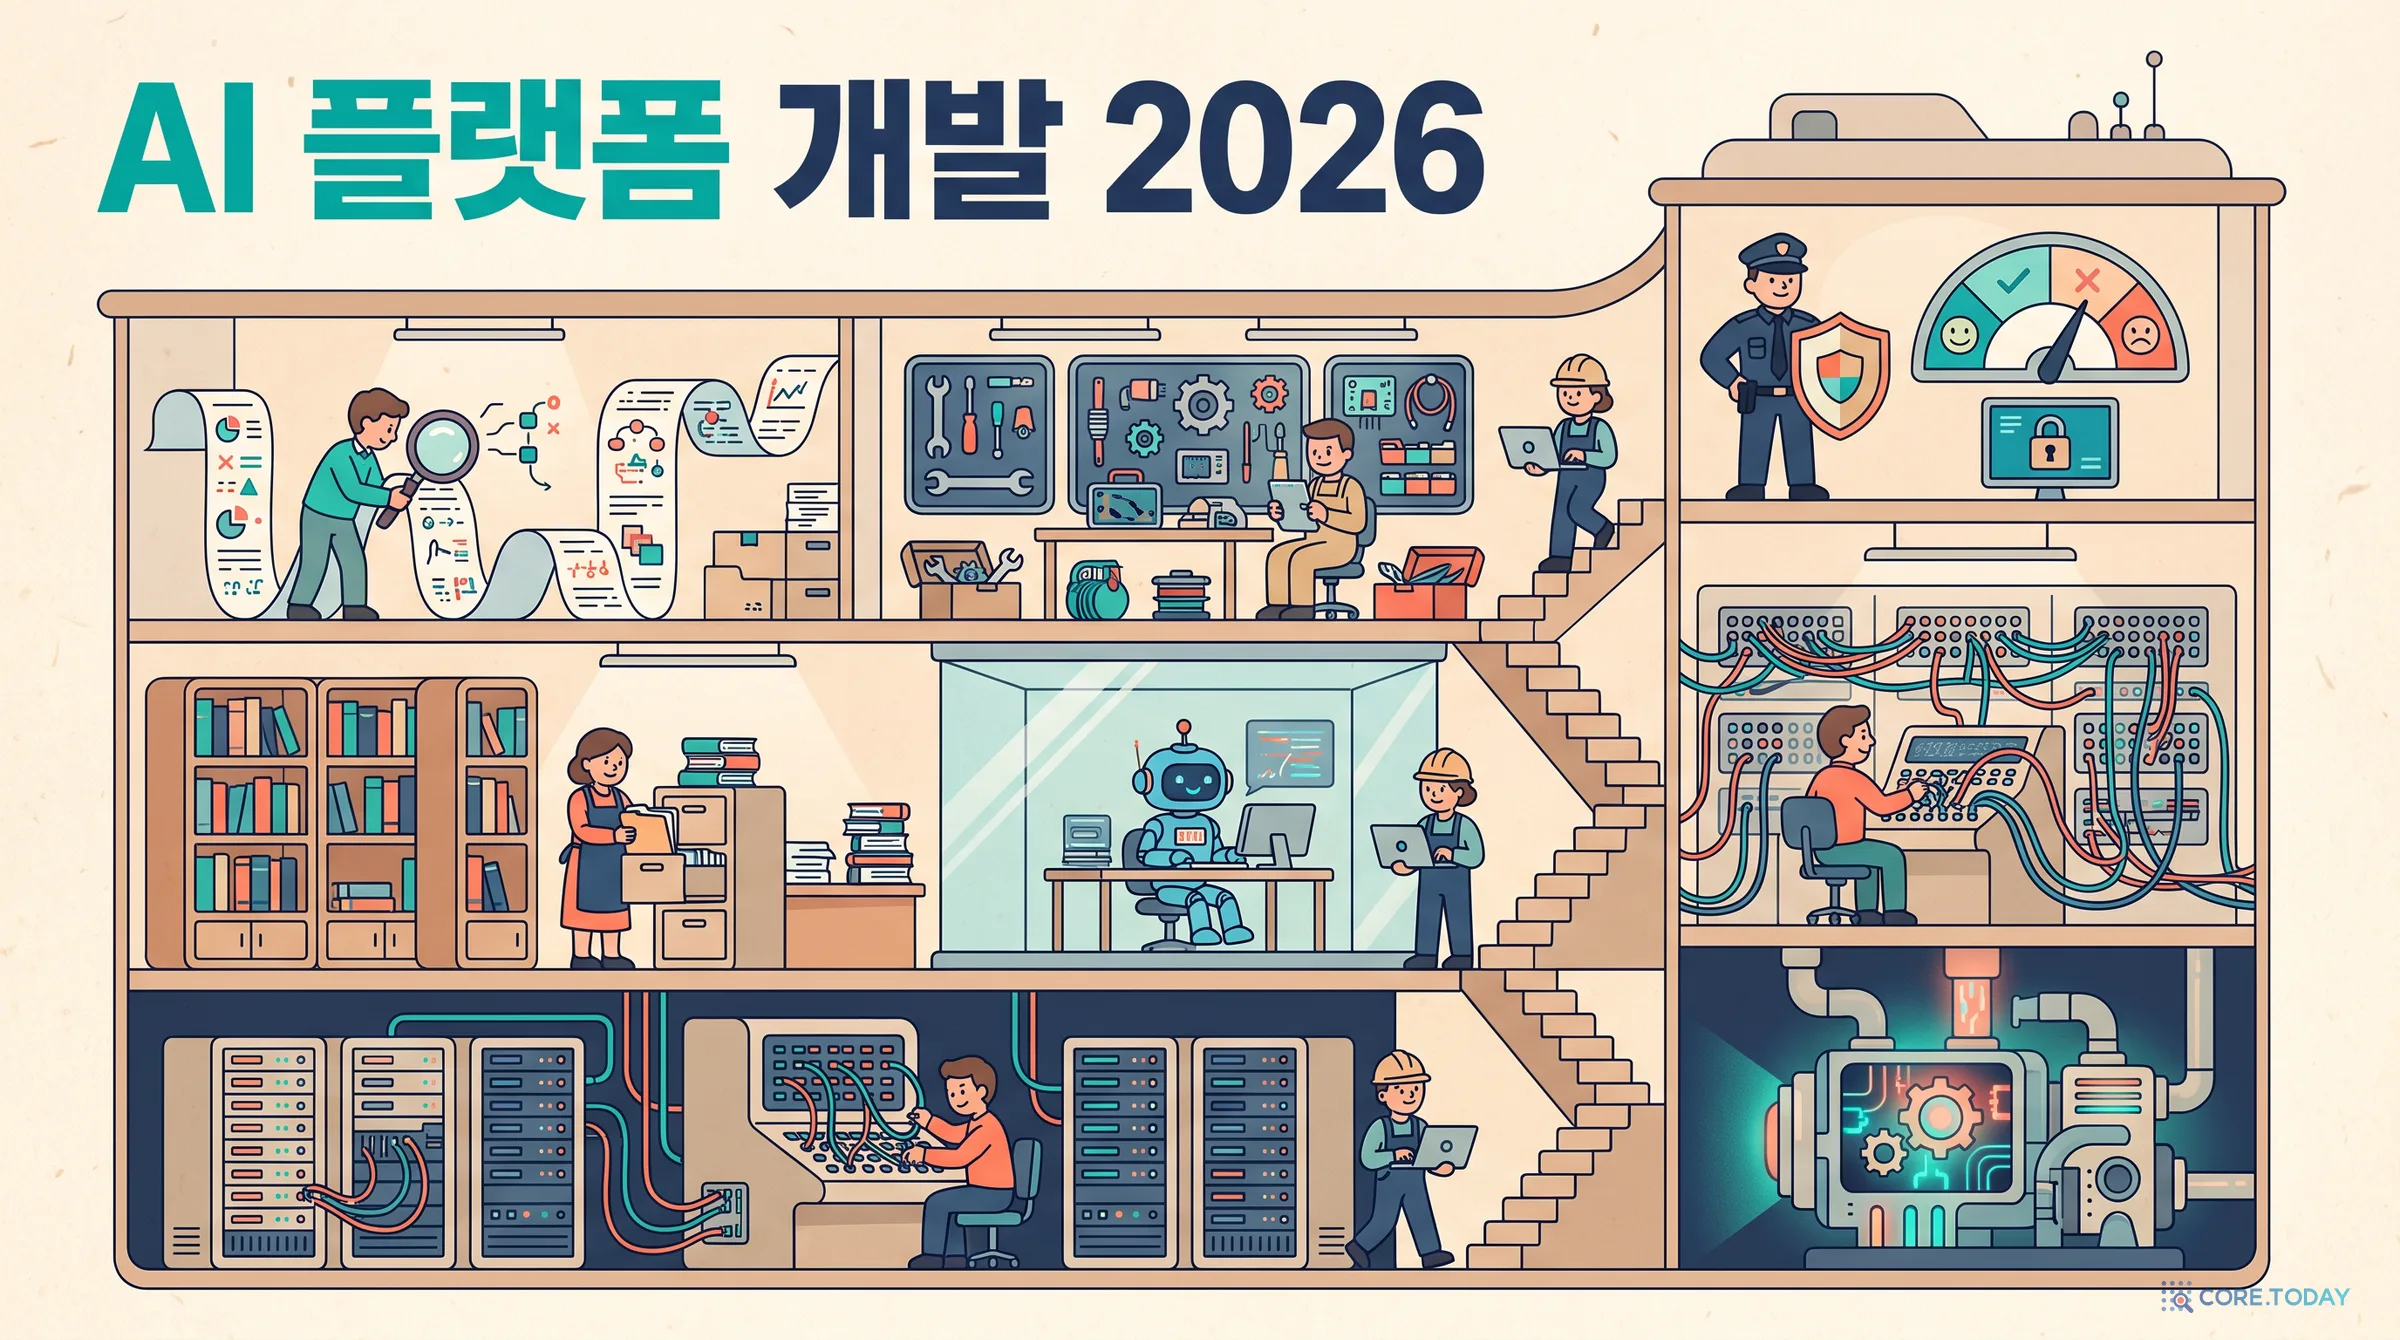
AI 플랫폼은 모델 바깥에서 만들어진다 — 2026년 일곱 층의 노하우와 서빙 플랫폼 지도
2026년에 AI 플랫폼을 만든다는 것은 모델을 만드는 일이 아니라 모델 둘레의 일곱 층을 짓는 일입니다. 서빙, 게이트웨이, 컨텍스트·캐시, 에이전트 런타임, 도구·프로토콜, 평가·관측, 보안·거버넌스. 이 글은 10월 3일 기준의 가격표·저장소·사양·엔지니어링 블로그를 직접 확인해, 층마다 무엇을 사고 무엇을 지을지 정리했습니다. 특히 서빙은 '빌려 쓰기 대 직접 돌리기'가 아니라 일곱 단짜리 사다리로 풀었습니다. 같은 모델의 입력 단가가 호스트에 따라 23배 벌어지는 이유, GPU 임대료가 2년 만에 반등한 지금의 손익분기, 서버를 늘리면 오히려 느려지는 캐시 문제, 한 해 사이 주인이 바뀐 게이트웨이·관측 도구들, 그리고 서울 리전에서 최신 프런티어 모델을 '국내 처리'로 쓸 수 없는 현실까지 다룹니다. 계산기와 시뮬레이터 7개를 직접 움직여 볼 수 있습니다.