
#보상 해킹
3개의 포스트
가장 쓴 교훈 — 계산량보다 데이터, 데이터보다 '올바른 과제'
2026년 9월 10일, ChatGPT를 만든 사람 중 하나가 900단어짜리 글을 올렸다. 리치 서튼의 '쓴 교훈'(계산 > 알고리즘)은 빙산의 일각이며, 진짜 위계는 '올바른 과제 > 데이터 > 계산 > 알고리즘'이라는 주장이다. 그리고 그 증거로 자기가 만든 InstructGPT의 논문 그림 한 장을 내놓았다 — 100배 작은 모델이 100배 큰 모델 위에 통째로 올라앉은 그림. 이 글은 왜 이 개념이 나왔는지를 1997년 딥블루부터 2026년의 에이전트 시대까지 따라가며, 과제를 잘못 고른 여덟 건의 값비싼 실패와 잘 고른 다섯 건의 성공을 함께 본다. 인터랙티브 위젯 8종과 삽화 14장.
“달 착륙을 6살에게 설명해 줘” — 되묻기만 하던 AI는 어떻게 말귀를 알아듣게 됐나 (RLHF 특집)
2022년 1월, OpenAI는 “사용자의 의도를 GPT-3보다 훨씬 잘 따르는” 모델을 발표했다. 13억 파라미터 모델이 1750억 모델을 이겼고, 그 비용은 사전학습의 1.6%였다. 열 달 뒤 같은 레시피로 만든 ChatGPT가 세상을 바꿨다. 이 글은 그 기술 — 인간 피드백 강화학습(RLHF) — 이 왜 필요했는지를 2017년 뒤공중돌기 로봇부터 따라간다. 보상을 글로 적을 수 없다는 문제, 순위 하나가 여섯 개의 비교가 되는 방식, 보상 모델을 너무 믿으면 벌어지는 일, 그리고 RLHF가 고친 것이 아니라 ‘만든’ 네 가지 버릇까지. 인터랙티브 위젯 8종과 삽화로 풀었다.
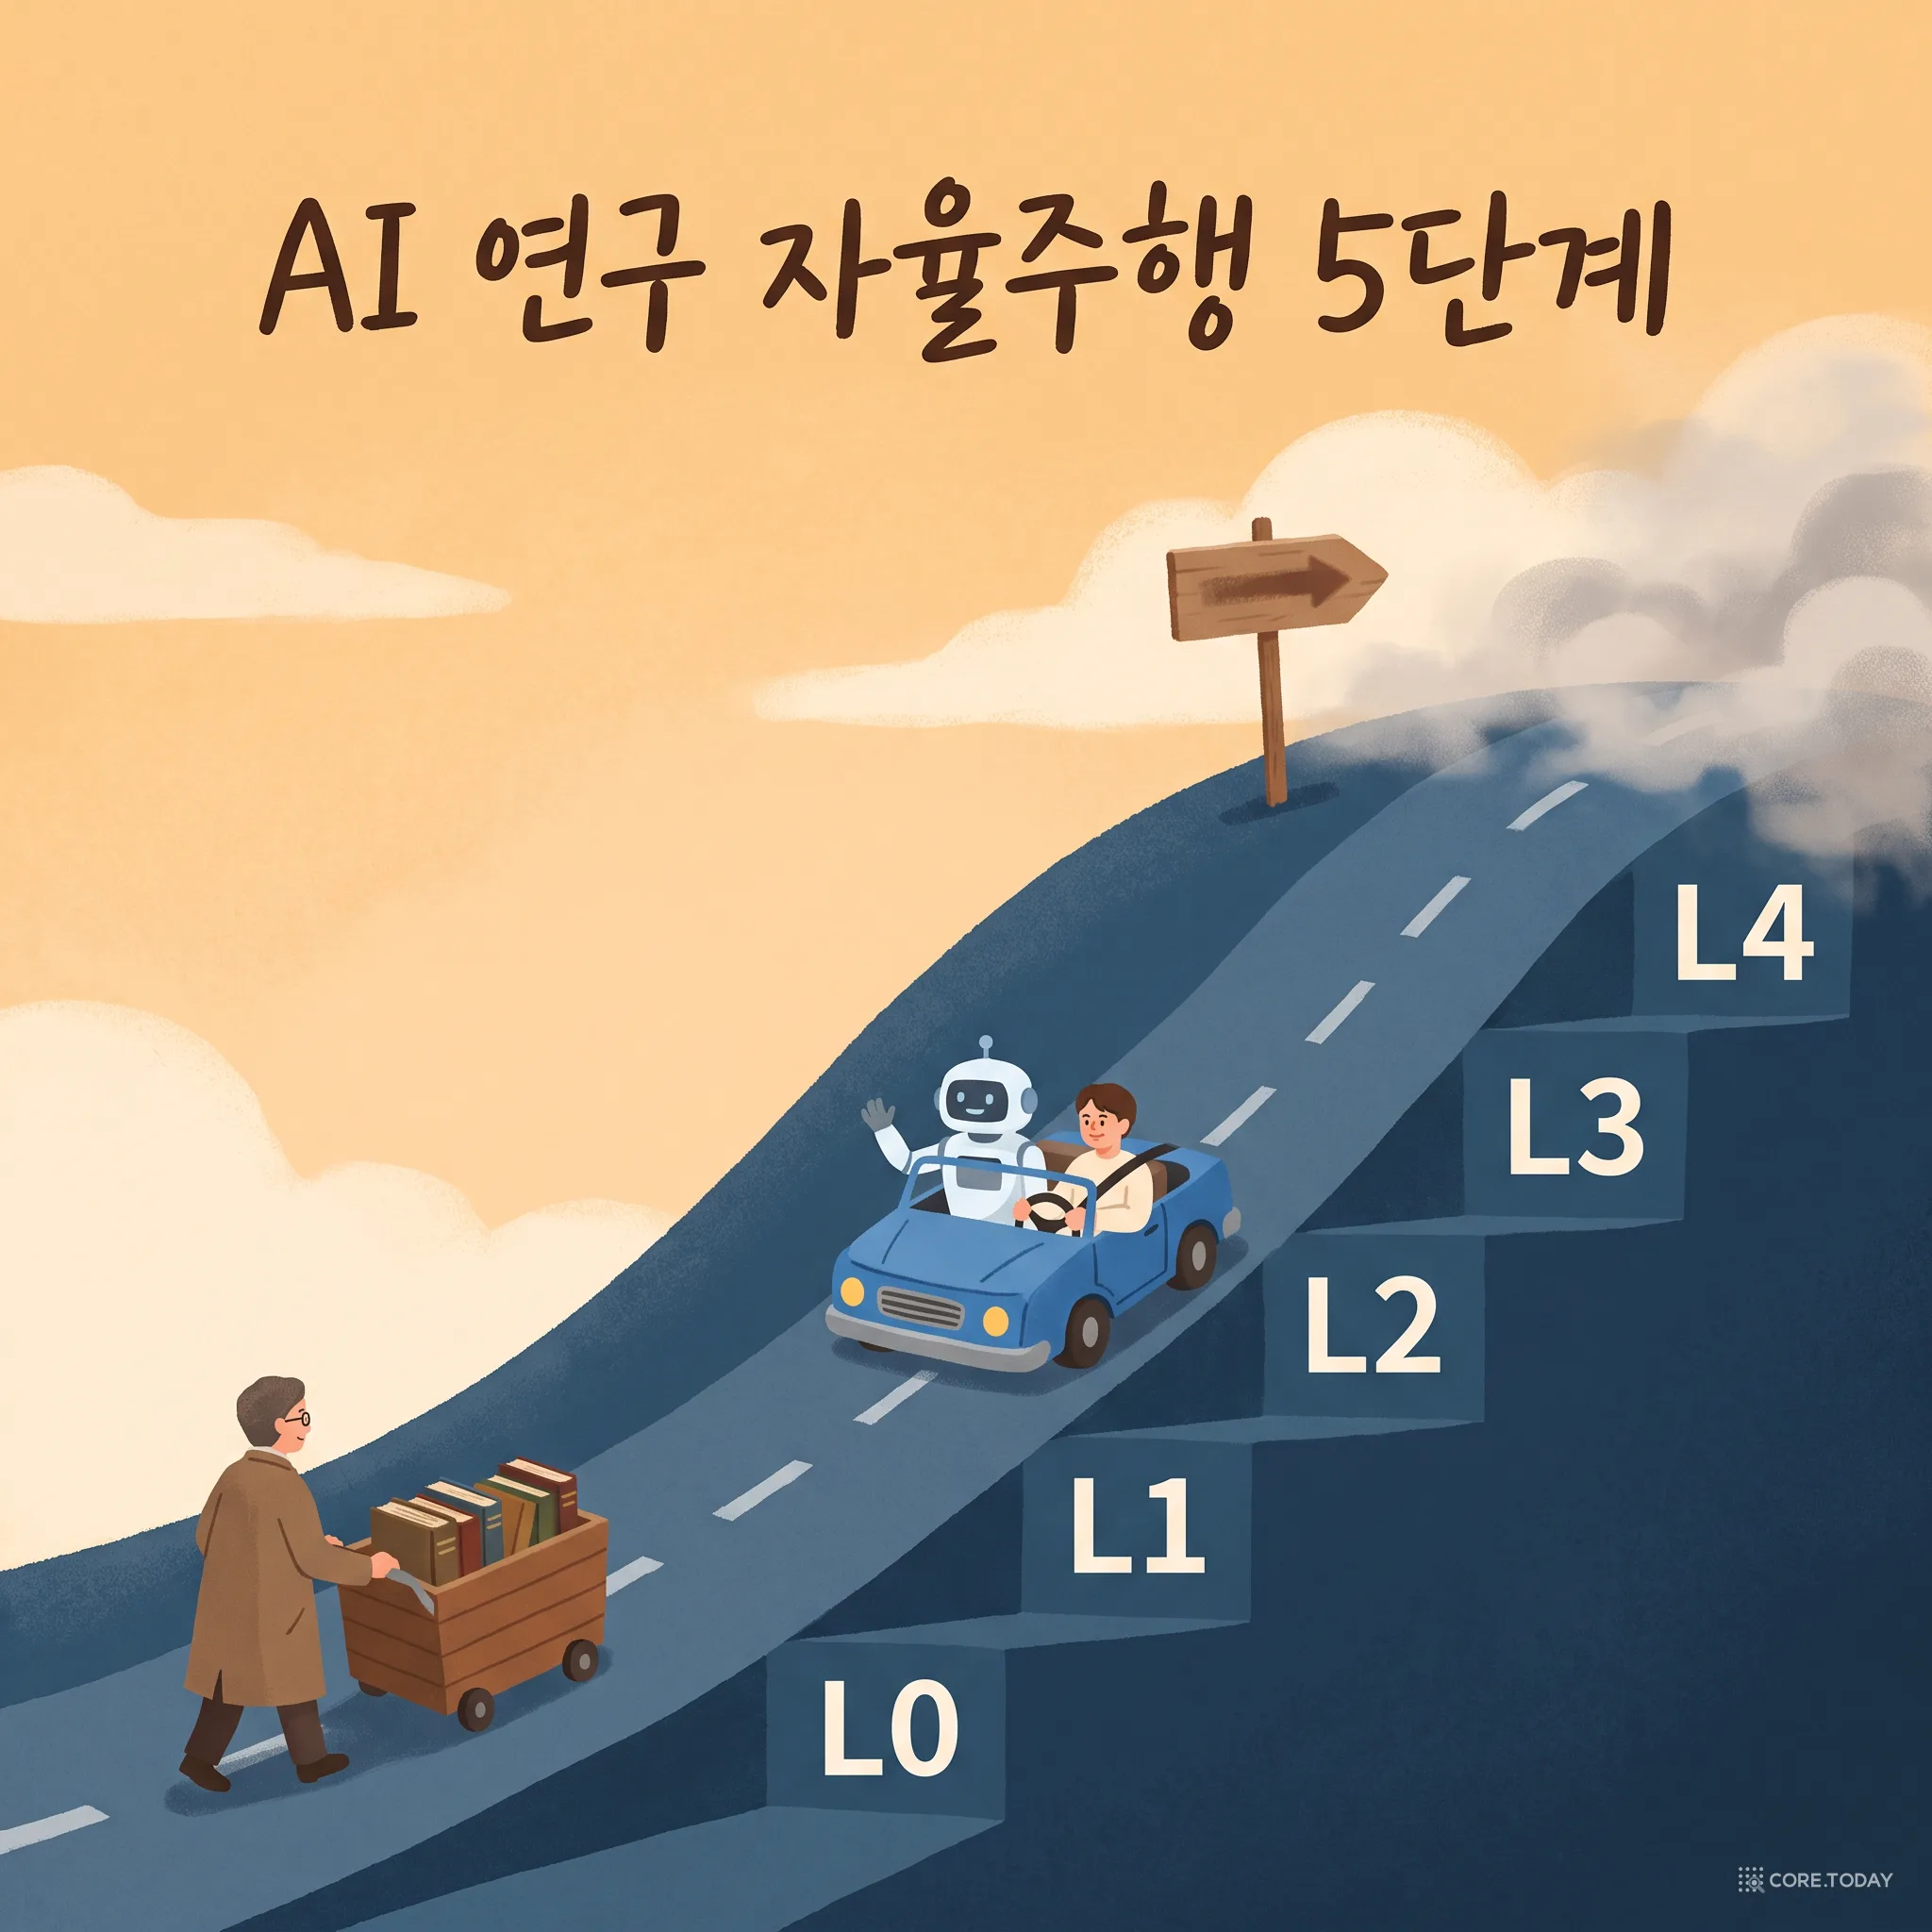
AI 연구 자율주행 5단계 — 지금 우리는 L2에 서 있다
자율주행에 L0~L5가 있듯 AI 연구 자동화에도 단계가 있다. 24개 기관 연구진이 49쪽 서베이로 그 지도를 그렸고, 결론은 냉정하다 — 화려한 파이프라인들은 전부 L2다. 그런데 같은 달, 한 스타트업의 AI는 스스로 벤치마크 3개에서 세계 기록을 갈아치웠다. 지도와 영토가 어긋나는 지점에서 2026년 AI 과학의 진짜 좌표를 읽는다.