
#굿하트의 법칙
6개의 포스트
[특집] 직원은 왜 AI 앞에서 멈칫하는가 — 정체성·감시·불확실성·변화 속도, 네 가지 위협으로 읽는 2026년 AI 도입의 심리학
2026년 10월 가트너는 AI 사용을 기대받는 직원의 47%가 도입에 저항한다고 밝혔습니다. 그런데 같은 해 일선 직원의 AI 정기 사용률은 74%까지 올랐습니다. 저항과 사용은 반대말이 아니라 한 사람 안에 함께 있습니다. 이 글은 직원이 AI 앞에서 멈칫하는 이유를 정체성·감시·불확실성·변화 속도라는 네 가지 위협으로 나눠 읽습니다. 1811년 러다이트와 1948년 하우드 공장 실험에서 '저항'이라는 말의 기원을 짚고, 국내 IT 기업 직원 397명이 AI 도입을 정체성 위협으로 느낄수록 노하우를 숨겼다는 2026년 연구, 메타·아마존의 토큰 순위표가 '쓰는 척'만 낳고 닫힌 사건, 사용 의무화를 1년 만에 되돌린 듀오링고, 감시가 성과를 올리지 못한다는 메타분석을 차례로 봅니다. 그리고 저항이 언제 정당한 신호인지, 회사가 4주 동안 무엇을 해 볼 수 있는지 위젯 여섯 개와 함께 정리합니다.
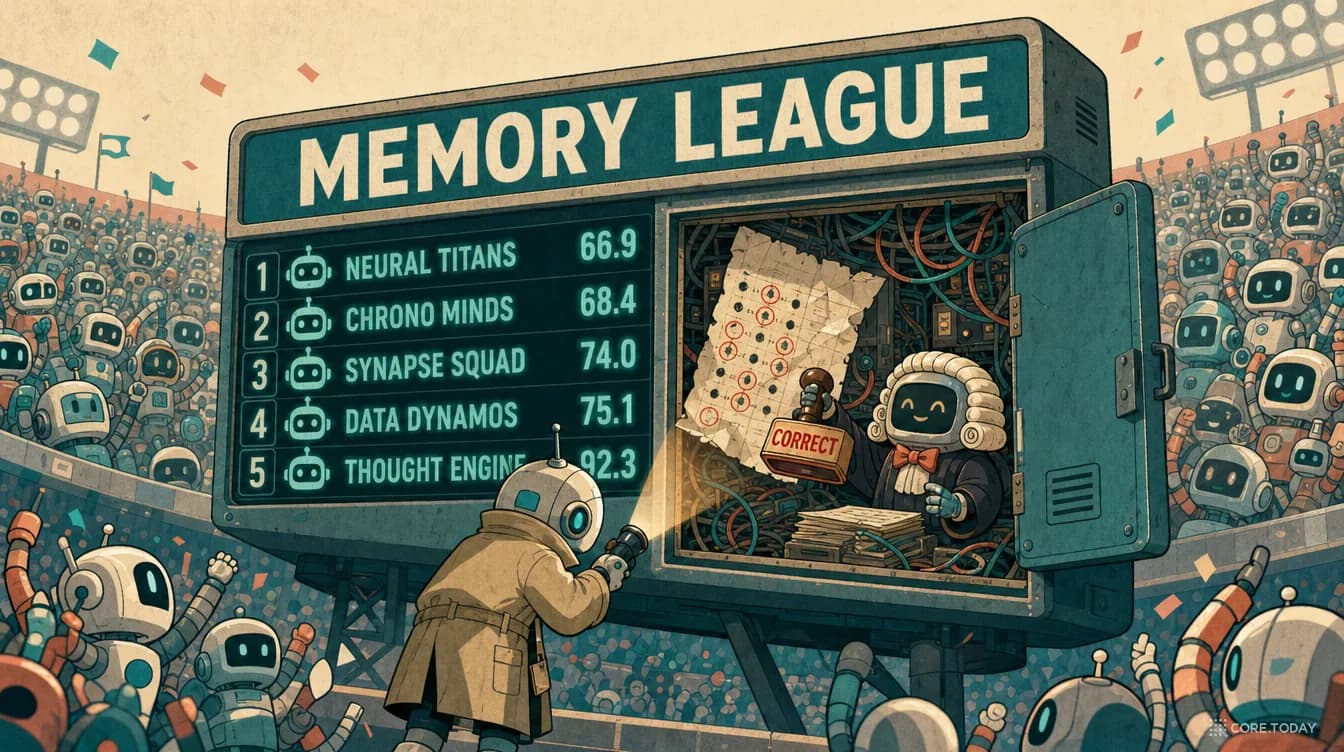
메모리 벤치마크 점수, 믿어도 되나 — LoCoMo·LongMemEval을 직접 다시 채점해 봤다
2026년 에이전트 기억 업계는 LoCoMo·LongMemEval에서 90점대를 발표합니다. 하지만 같은 Zep의 LoCoMo 점수는 누가 쟀느냐에 따라 58점에서 95점까지 흩어져 있습니다. 두 벤치마크를 직접 다시 돌렸습니다. 기억 시스템 없이 대화를 통째로 넣은 2026년 저가 모델이 LoCoMo 80.7%, LongMemEval 81.6%로 2025년의 기억 시스템들을 넘었습니다. 같은 답에 채점 프롬프트만 바꾸자 점수가 26점 움직였고, 정답과 오답을 나란히 적은 답을 Mem0의 2026년 채점 프롬프트는 100% 정답 처리했습니다. LoCoMo 정답지 1,540개를 대화 원문과 대조하니 7%가 틀렸거나 모호했고, 대화 10개에 몰린 문항이라 95% 구간은 ±3.1점이었습니다. bAbI부터 건초더미 속 바늘, SWE-bench Verified의 은퇴까지 벤치마크의 역사와, 점수를 읽는 점검표 10문항을 함께 정리했습니다. 인터랙티브 6개.
[특집] 엔지니어의 '소모율'이 연봉을 따라잡을 때 — 토큰 예산은 누가, 얼마나, 어떻게 정하는가
2026년 봄, 같은 규모의 두 회사가 엔지니어 한 명에게 허락한 월 토큰 한도는 5,000달러와 200달러였다. 25배 차이. 3월에 젠슨 황은 '연봉 50만 달러 엔지니어라면 토큰을 25만 달러어치는 써야 한다'고 했고, 4월에 메타의 사용량 순위표는 30일간 60조 토큰을 태우다 닫혔으며, 6월에 우버는 1인당 월 1,500달러 상한을 걸었다. 넉 달 만에 '토큰을 최대로'가 '토큰을 최소로'로 뒤집힌 것이다. 이 글은 그 소동의 한가운데 있는 질문 하나를 붙든다 — 엔지니어 한 명에게 얼마를 쓰게 할 것인가, 그리고 그걸 누가 어떻게 정하는가. 1969년 멀틱스의 '자원 예산'부터 구글의 사내 계산 자원 경매, 클라우드 FinOps까지 60년 된 문제의 계보를 따라가고, 에이전트 코딩의 토큰이 왜 예측 불가능한지(같은 과제에서 최대 30배 차이)를 논문으로 풀며, 한도라는 숫자 하나 밑에 깔려야 하는 여섯 층의 통제 구조와 다섯 가지 정책의 득실, 굿하트의 법칙이 순위표를 무너뜨린 과정, 손익분기 계산, 그리고 네이버·LG·삼성 등 한국 기업의 실제 선택까지 다섯 개의 인터랙티브 도구와 함께 정리했다.
가장 쓴 교훈 — 계산량보다 데이터, 데이터보다 '올바른 과제'
2026년 9월 10일, ChatGPT를 만든 사람 중 하나가 900단어짜리 글을 올렸다. 리치 서튼의 '쓴 교훈'(계산 > 알고리즘)은 빙산의 일각이며, 진짜 위계는 '올바른 과제 > 데이터 > 계산 > 알고리즘'이라는 주장이다. 그리고 그 증거로 자기가 만든 InstructGPT의 논문 그림 한 장을 내놓았다 — 100배 작은 모델이 100배 큰 모델 위에 통째로 올라앉은 그림. 이 글은 왜 이 개념이 나왔는지를 1997년 딥블루부터 2026년의 에이전트 시대까지 따라가며, 과제를 잘못 고른 여덟 건의 값비싼 실패와 잘 고른 다섯 건의 성공을 함께 본다. 인터랙티브 위젯 8종과 삽화 14장.
“달 착륙을 6살에게 설명해 줘” — 되묻기만 하던 AI는 어떻게 말귀를 알아듣게 됐나 (RLHF 특집)
2022년 1월, OpenAI는 “사용자의 의도를 GPT-3보다 훨씬 잘 따르는” 모델을 발표했다. 13억 파라미터 모델이 1750억 모델을 이겼고, 그 비용은 사전학습의 1.6%였다. 열 달 뒤 같은 레시피로 만든 ChatGPT가 세상을 바꿨다. 이 글은 그 기술 — 인간 피드백 강화학습(RLHF) — 이 왜 필요했는지를 2017년 뒤공중돌기 로봇부터 따라간다. 보상을 글로 적을 수 없다는 문제, 순위 하나가 여섯 개의 비교가 되는 방식, 보상 모델을 너무 믿으면 벌어지는 일, 그리고 RLHF가 고친 것이 아니라 ‘만든’ 네 가지 버릇까지. 인터랙티브 위젯 8종과 삽화로 풀었다.
AI와 수학의 심각한 불일치 — 필즈상 수상자 25인은 무엇을 두려워하는가: 등대, 파이프라인, 그리고 나비에–스토크스 88시간
2026년 9월 11일, 테런스 타오·페터 숄체·마리나 비아조우스카 등 필즈상 수상자 25명이 'AI와 수학의 심각한 불일치'라는 선언을 냈다. AI 기업이 유명 미해결 문제를 벤치마크 삼아 푸는 경쟁이 수학이라는 학문과 공동체에 해롭다는 것이다. 이 선언은 어디서 왔는가. OpenAI가 1만 개 에이전트로 88시간 만에 '풀었다'고 발표한 나비에–스토크스 문제, 그 직전에 같은 문제를 1년간 파던 두 수학자의 4쪽짜리 성명, '10년간 진전 없음'이라는 문구에 항의한 독일 수학자의 이메일, 타오가 ICM에서 그린 다섯 단계 파이프라인과 굿하트의 법칙까지 — 왜 '문제를 푸는 것'과 '수학을 하는 것'이 갈라졌는지를 논문·선언문·논쟁 100건을 읽고 인터랙티브와 함께 풀어본다.